

计算机三级Python真题哪里找?近年高频考点与解析汇总

准备全国计算机等级考试三级Python科目的核心在于两件事:找到真实可信的历年题源,以及搞清楚它与二级考查范围的本质区别。三级考试不再停留在基础语法与内置库调用的辨析,而是转向了数据结构、核心算法以及综合程序设计。本文整理了合规获取真实样题与历年真题的途径,并对近年考频极高的数据结构实现、查找排序以及综合编程题型进行结构化解析与代码示例展示。
一、真题与大纲获取途径与辨识方法
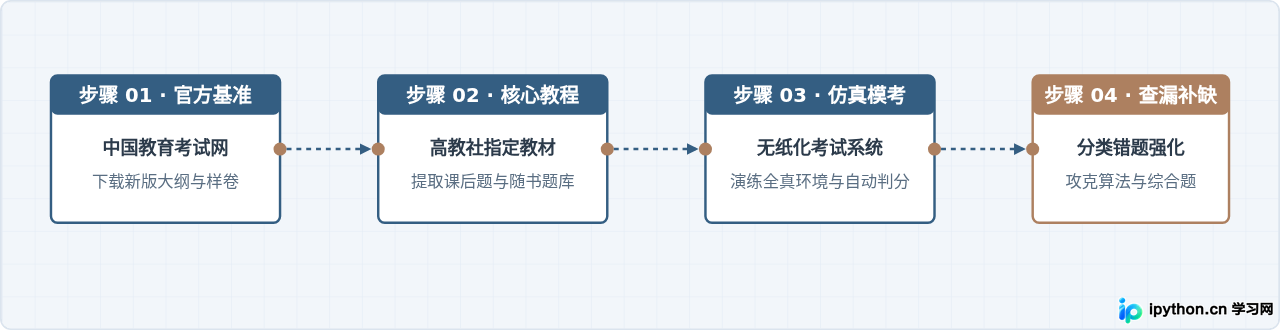
获取复习资料时,需要注意甄别二级与三级的考卷。市面上常有将二级题目重新包装后充当三级资料的情况。寻找真题应以官方发布与权威渠道为主,辅以合规的模拟软件。
- 中国教育考试网(官方主站):教育部教育考试院官方网站会定期发布最新的考试大纲和考试样题。每逢考纲微调,官方都会公开一套标准样卷及评分细则。这是把握题目难易度和出题形式最可靠的标准。
- 官方指定教材与配套题库:高等教育出版社出版的官方指定考试教程,书后附带的综合习题大多选自真实题库;随书附赠的学习光盘或二维码配套在线题库,包含了真实考试界面的上机模拟系统。
- 高校校内资源与正规无纸化刷题软件:各大正规考试软件(如未来教育、未来汇通等正规无纸化考试模拟端)会持续收集历年考生考后回忆卷与真实题库。选择时以标注“三级”且涵盖链表、树、图或递归算法模块的软件为主。
二、近年核心考点分布与架构关系
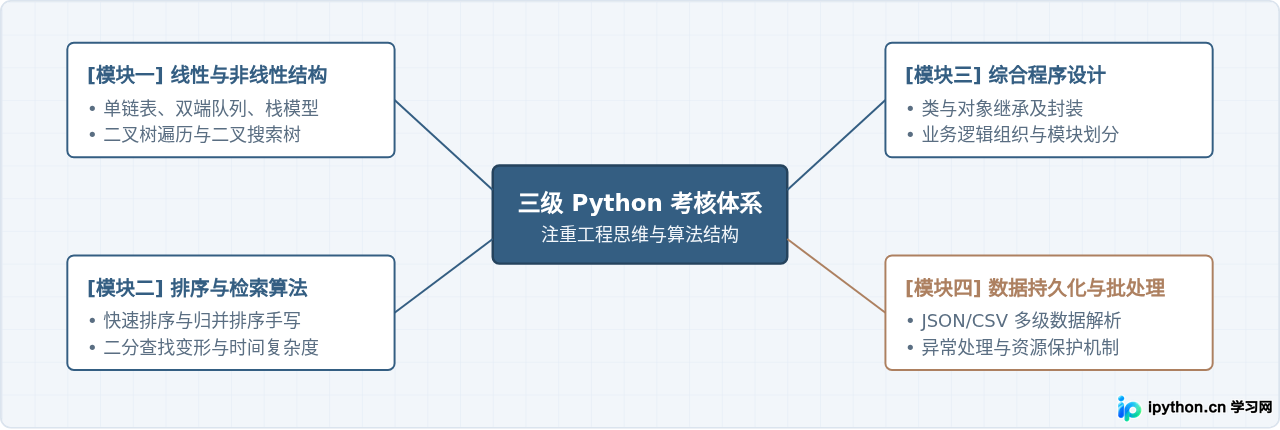
计算机三级考查重心是“理论理解与中等规模算法实现的结合”。从近年试题分布来看,知识结构主要由四大模块组成:基础算法与复杂度分析、经典线性与非线性数据结构、文件与数据持久化处理,以及面向对象的综合程序设计。
三、高频考点一:链表与树结构的 Python 面向对象实现
与二级单纯使用列表(list)和字典(dict)不同,三级真题频繁要求考生使用原生类模拟基本数据结构。其中,单链表的增删改查以及二叉树的前中后序遍历在程序设计题中占比极高。
1. 单链表逆置实战解析
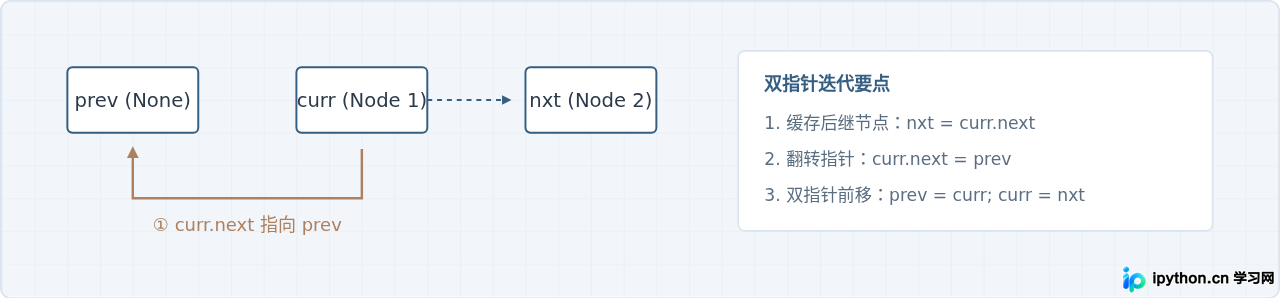
题目通常给定一个节点定义类 ListNode,要求考生补全链表翻转或特定位置节点插入的函数。此类题目的关键在于指针引用的更新顺序,防止链表断裂丢失后续节点。
class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def reverse_list(head: ListNode) -> ListNode:
    prev = None
    curr = head
    while curr is not None:
        next_node = curr.next  # 暂存后继节点
        curr.next = prev       # 翻转指针指向
        prev = curr            # prev 节点前进一步
        curr = next_node       # curr 节点前进一步
return prev考查重点说明:在历年判分系统中,此题通常会检查链表长度为 0、1 以及普通长度情况下的执行表现。将 curr.next 指向前驱节点前,务必预先保留后继指针,否则会陷入死循环或丢失节点访问引用。
2. 二叉树递归遍历模板
真题中二叉树主要考察递归实现。无论是中序遍历计算表达式树,还是后序遍历统计子节点权值,均基于如下递归框架:
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

def inorder_traversal(root: TreeNode) -> list:
    res = []
    def dfs(node):
        if not node:
            return
        dfs(node.left)       # 遍历左子树
        res.append(node.val) # 处理根节点
        dfs(node.right)      # 遍历右子树
    dfs(root)
    return res
四、高频考点二:排序、查找与分治法实战
三级真题中,纯调用 list.sort() 或 sorted() 无法取得满分,填空题与程序题常要求考生补全核心比较与交换逻辑。近年高频考察的是快速排序的分区过程(Partition)与二分查找边界判定。
以二分查找为例,最容易失分的地方是循环终止条件以及区间端点的收缩方式。真题常考察在有序数组中定位指定元素的左右边界:
def binary_search(nums: list, target: int) -> int:
    left = 0
    right = len(nums) - 1

    # 采用闭区间 [left, right]
    while left <= right:
        mid = left + (right - left) // 2
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1      # 目标在右半区间
        else:
            right = mid - 1     # 目标在左半区间
return -1right = mid 或 left = mid,在闭区间判定下这会导致当搜索区间缩小为 2 个元素且元素不匹配时发生死循环。
五、高频考点三:文本与结构化数据批处理
三级综合应用题常模拟小型工程需求:读取外部文本文件(如 data.txt 或 records.csv),完成清洗、过滤、聚合计算,并将最终结果按固定格式格式化写出。
# 典型真题模式:处理日志文件并统计各个状态码的频次
def analyze_log(file_path: str, output_path: str):
    stat = {}
    try:
        with open(file_path, 'r', encoding='utf-8') as f:
            for line in f:
                line = line.strip()
                if not line:
                    continue
                parts = line.split(',')
                # 假设格式: 时间戳,请求方法,状态码,耗时
                if len(parts) >= 3:
                    status_code = parts[2].strip()
                    stat[status_code] = stat.get(status_code, 0) + 1

        with open(output_path, 'w', encoding='utf-8') as out:
            # 依频次从高到低写入
            for code, count in sorted(stat.items(), key=lambda x: x[1], reverse=True):
                out.write(f"{code}:{count}\n")
    except FileNotFoundError:
        print(f"未能找到输入文件: {file_path}")
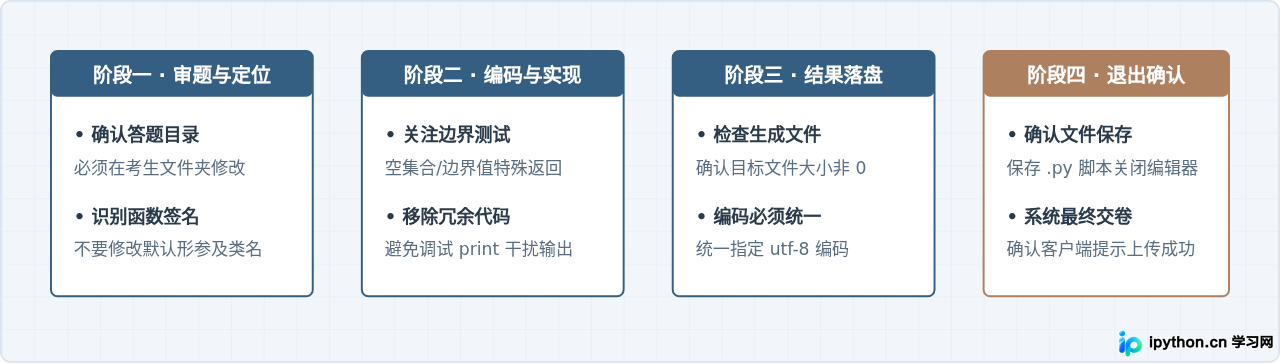
在实际判卷中,如果题目明确规定了输出文件名和路径,任何多余的打印输出(如测试用的 print())或文件写入格式偏差(如少了换行符 \n)都可能导致机器判分给出 0 分。应严格按照题目给定的输出规范操作。
六、全真上机排错与提分策略总结
从历年考生的常见扣分点来看,除语法逻辑外,绝大多数失分发生在环境规范与提交流程上。三级考试在上机操作中应保持清晰的执行顺序。
综上,备战计算机三级Python,要建立在“规范题源 + 数据结构打底 + 标准文件规范”的三维体系上。在考前刷题阶段,重点保证单链表、二叉树与二分排序这三类核心算法能够不依赖IDE代码补全、独立在纯文本环境下完整手写,并保证基本的边界条件与异常处理机制正确无误。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









