

Python类和对象是什么:通俗解释类模板与实例的关系

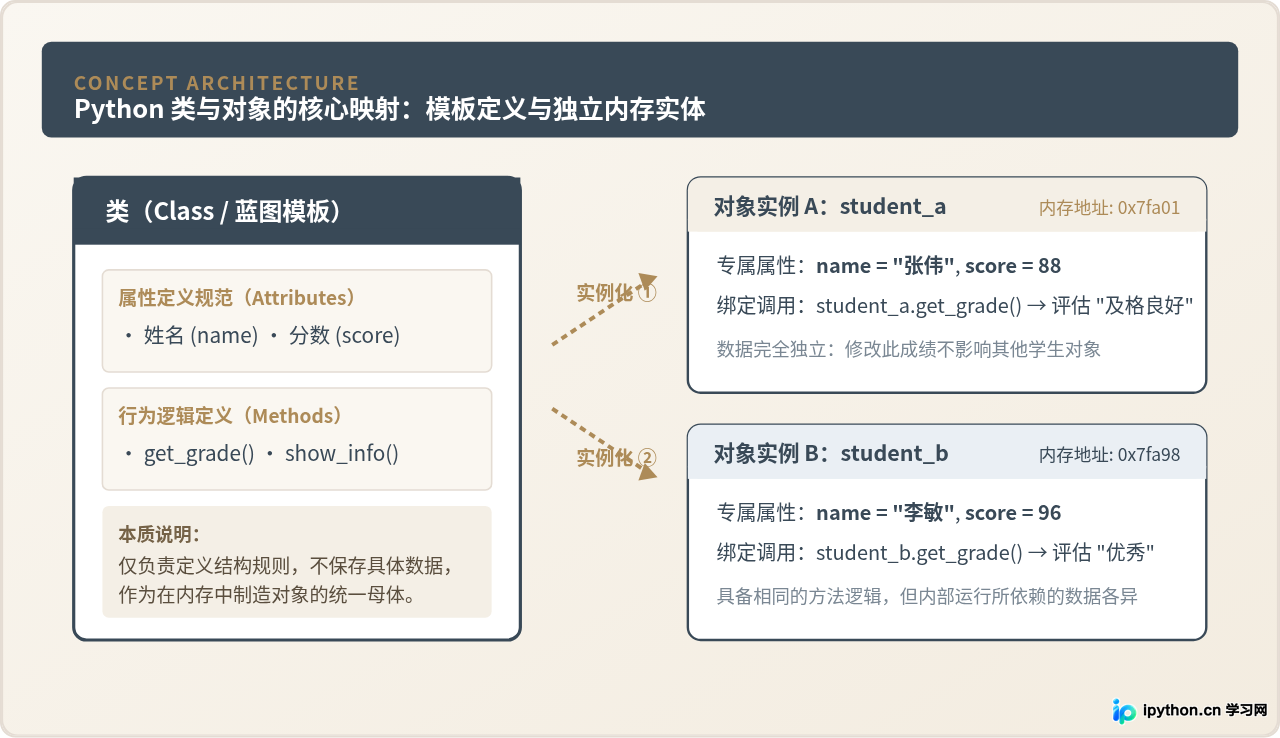
在 Python 编程中,类(Class)是创建实体的模板或图纸,而对象(Object,也称为实例 Instance)则是根据这张图纸真正制造出来的独立个体。类负责规定这类事物“长什么样”(具有哪些属性)以及“能做什么”(具备哪些方法);当我们使用类去创建对象时,计算机便会在内存中分配专属空间,保存该对象具体的数据状态。搞清楚这种“模板与成品”的分工关系,是迈入面向对象编程(OOP)世界最核心的基石。
一、核心概念:为什么需要把“类”与“对象”区分开来?
初学者在学习面向对象时,常常会疑惑:既然最终运行程序时操作的都是具体的数据,为什么不直接定义字典或变量,而一定要先写一个 class 呢?
我们可以用生活中非常贴切的例子来对照理解:
- 建筑图纸与真实住宅:图纸上标明了一栋房子必须有客厅、主卧、入户门和供水管道,但图纸本身不能用来遮风挡雨;只有按照图纸实地施工建造出来的 1 号楼、2 号楼,才是能住人、拥有独立门牌号与住户的实体房屋。这里的图纸就是“类”,每一栋房子就是一个“对象”。
- 印章与纸面印痕:印章上刻好了文字与图案结构,这是“类”;将印章蘸上印泥盖在不同文件上,每一处印痕都是独立的“对象”。你在第一份文件上用水笔涂抹印痕,绝不会弄脏第二份文件上的印痕。
在 Python 代码层面,如果我们要管理一万名学生的信息,如果不使用类,就需要维护一万个结构容易出错的散落字典;一旦需要统一增加一个“计算平均分”的逻辑,修改成本极高。而“类”的作用,就是将数据规格与处理函数打包封装成一个通用的标准模板。
二、动手实践:从编写类到创建对象的执行流程
理解了概念后,我们通过一段具体的 Python 代码,来看看到底如何定义一个类,以及如何把它变成真正的对象。
# 1. 定义类(模板)
class Student:
    # 构造方法:在创建新对象时自动执行
    def __init__(self, name, score):
        # 这里的 self 就代表当前正在被创建的具体对象
        self.name = name    # 给这个具体对象绑定 name 属性
        self.score = score  # 给这个具体对象绑定 score 属性

    # 实例方法:定义对象能够执行的行为
    def get_grade(self):
        if self.score >= 90:
            return "优秀"
        elif self.score >= 60:
            return "合格"
        else:
            return "需补考"

    def show_info(self):
        print(f"学员姓名:{self.name},考试成绩:{self.score},评级:{self.get_grade()}")

# 2. 实例化:根据类模板制造两个独立的对象实体
stu1 = Student("张伟", 88)
stu2 = Student("李敏", 96)

# 3. 通过对象调用其专属的属性与方法
stu1.show_info()
stu2.show_info()
运行上述示例代码,终端将输出:
学员姓名:张伟,考试成绩:88,评级:合格
学员姓名:李敏,考试成绩:96,评级:优秀
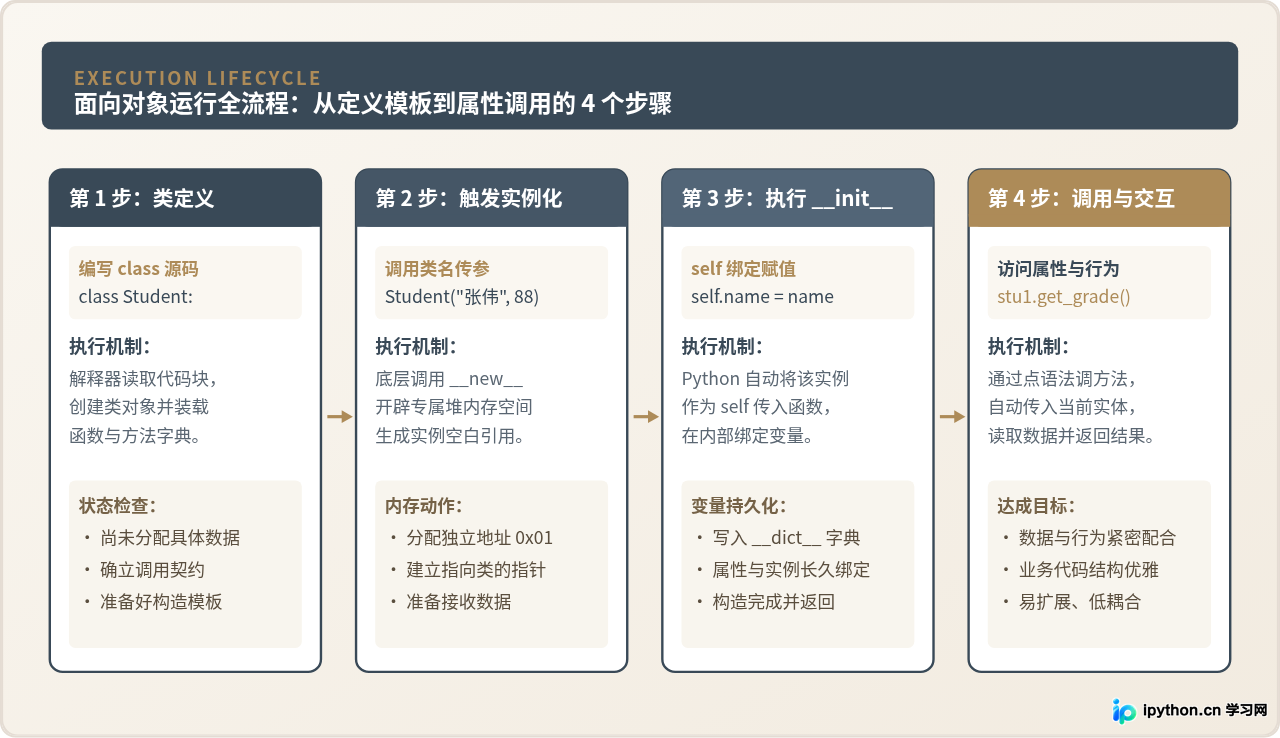
核心执行细节拆解:
-
__init__构造方法:双下划线开头的特殊方法。每当你写下Student(...)时,Python 会首先在内存中开拓一块新空间,然后立即调用__init__来为这个新对象初始化数据。 -
self到底是什么?许多初学者对self感到困惑。其实self就是“这个对象自己”。当执行stu1 = Student("张伟", 88)时,Python 会把刚刚分配好的stu1内存引用自动当作第一个参数传递给self。因此,self.name = name的实际含义就是“把传入的名字,存进当前这个新对象的仓库里”。 -
方法调用的隐式传参:当你调用
stu1.get_grade()时,Python 底层会自动转换为Student.get_grade(stu1)。方法之所以知道要查询谁的成绩,正是因为self已经锁定了发起调用的具体对象。
三、关键辨析:类属性与实例属性的本质差异
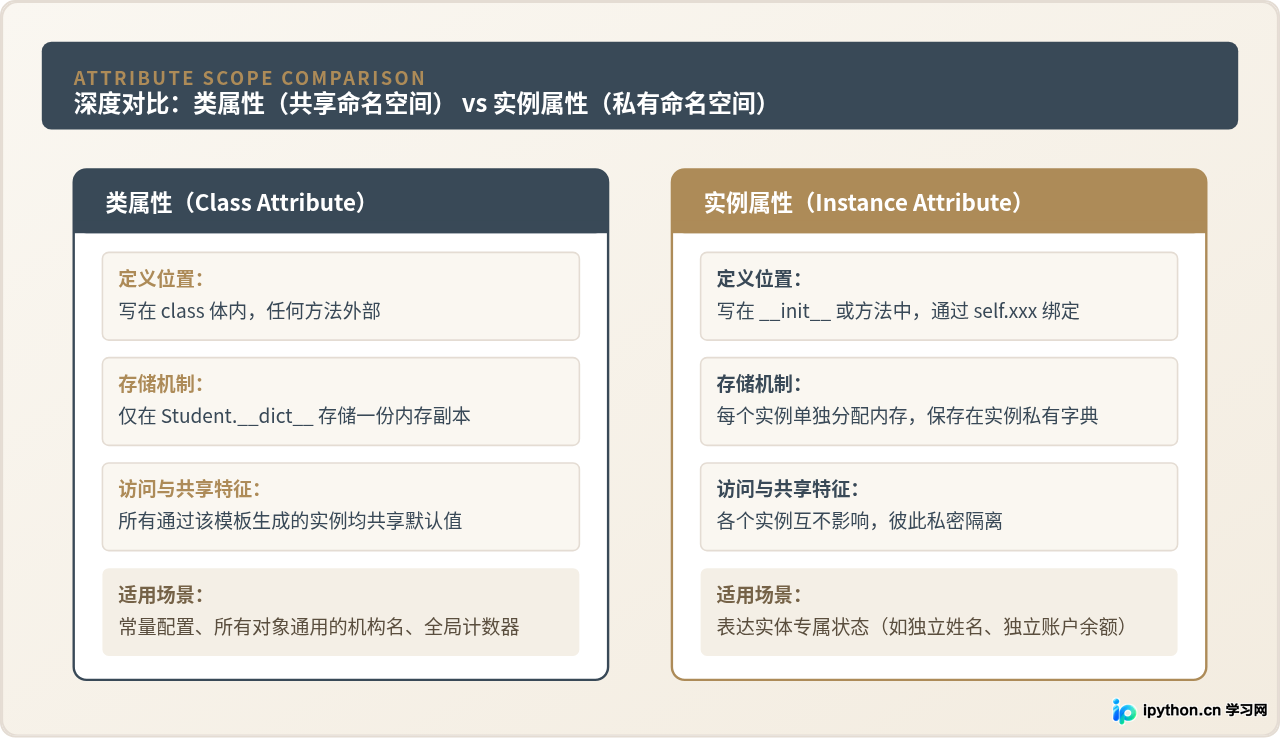
在实际开发中,容易让新手产生误解的一个细节是:属性究竟是定义在类上,还是定义在对象实例上?
来看下面这段对比代码:
class Student:
    # 类属性:直接写在类体内,所有实例共同享有
    school_name = "阳光实验中学"

    def __init__(self, name, score):
        # 实例属性:必须通过 self 绑定,属于每个对象独有
        self.name = name
        self.score = score

s1 = Student("张伟", 88)
s2 = Student("李敏", 96)

# 1. 访问类属性:所有实例均可直接读取
print(s1.school_name)  # 输出:阳光实验中学
print(s2.school_name)  # 输出:阳光实验中学

# 2. 尝试通过某一个实例去修改“类属性”
s1.school_name = "未来科技中学"

# 3. 观察此时的结果差异
print(s1.school_name)        # 输出:未来科技中学(实际上是在 s1 身上新建了一个实例属性!)
print(s2.school_name)        # 输出:阳光实验中学(s2 仍然读取类本身的属性)
print(Student.school_name)   # 输出:阳光实验中学(类原本的属性根本没有改变)
为什么会这样?这是因为 Python 在查找属性时遵循就近原则:
- 当通过
s1.school_name读取时,Python 会先检查s1自身的字典中是否有这个属性;如果没有,再去类中查找。 - 当你执行
s1.school_name = "未来科技中学"时,Python 绝不会去修改母体类,而是在s1自己的实例空间中新建了一个同名的实例属性,从而遮蔽(Shadow)了原有的类属性。 - 如果确实要全局修改所有学生共享的学校名称,正确的做法是通过类名直接赋值:
Student.school_name = "未来科技中学"。
四、新手容易踩坑的常见误区与防范要点
根据开发经验,在初次接触类与对象时,以下 3 个细节最容易引发报错或逻辑陷阱:
很多新手写普通函数习惯了,在类中定义方法时漏写 self,例如写成 def get_grade():。当通过对象调用 stu.get_grade() 时,Python 会报 TypeError: get_grade() takes 0 positional arguments but 1 was given。这是因为实例调用会自动传入对象自己,方法必须预留 self 来接收。
如果直接执行 Student.get_grade(),由于没有指定任何具体的学生对象,Python 不知道要读取谁的分数,便会直接报错。除非使用 @classmethod 或 @staticmethod 装饰器,否则实例方法必须由实例对象发起调用。
面向对象不是万灵丹。如果你只是写一个 30 行的小脚本去统计一个文本文件里的行数,直接写普通函数和简单的列表即可,完全没有必要强行定义一个 TextCounter 类。面向对象的核心价值在于管理复杂状态与复用业务行为,只有当数据和行为需要紧密绑定在一起时,设计类才是最划算的。
五、总结:记住这张类与对象的心智模型图
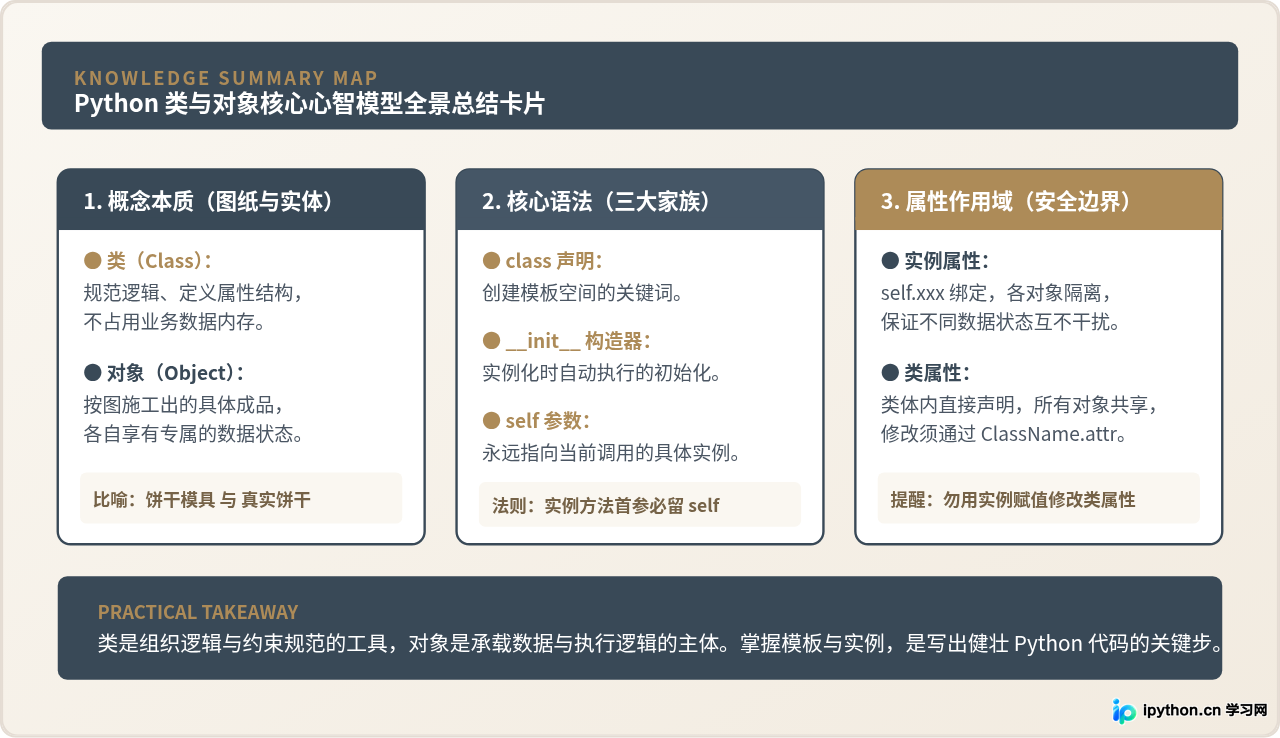
归纳起来,我们可以用三句话彻底固化关于 Python 类与对象的心智模型:
- 类是设计图,代码里只写一次:它把事物的属性规约与动作逻辑封装起来,是静态的模具。
- 对象是真实实体,内存里可以制造成千上万个:通过调用类实例化生成,各自保存独一无二的数据状态。
- self 是指引明灯:无论是在方法内部读取属性,还是执行其他关联行为,
self永远精准锁定当前正在工作的具体对象。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









