

Python 2 中文乱码深度解析:编码原理与四种典型场景解决方案

本文深入解析 Python 2 中中文乱码的成因,通过四种典型场景(文件声明缺失、IDE与脚本编码不一致、命令行环境差异、Shell交互模式)详细阐述编码转换机制。重点讲解 Unicode 在编码转换中的核心地位,以及 decode 和 encode 的正确使用方式,帮助开发者彻底解决 Python 2 环境下的中文显示问题。
Python 2 中文乱码问题解析
针对 Python 2 环境下的中文乱码现象,本文将通过以下四种具体情况进行详细展开说明。
理解本文的核心在于掌握以下两条关键原则,后续所有案例分析均基于此展开。
- 1. 乱码的根本原因是字符的编码格式与显示该字符的环境编码格式不一致。解决乱码的关键在于明确两个要素:字符本身的编码方式以及运行环境的编码方式,只有当两者保持一致时,才能正确显示内容。
- 2. 在 Python 中,当打印 Unicode 类型的字符时,系统会自动根据当前环境的编码格式将其转换为特定编码后再进行显示。
接下来探讨字符在 Python 代码中的编码机制。不同版本的 Python 处理字符编码的方式存在差异,本文主要聚焦于 Python 2 版本的处理逻辑。
乱码场景一:文件编码未声明
Python 2 默认使用 ASCII 编码解析源代码。如果代码中包含中文字符,必须在 Python 文件开头明确声明支持中文的编码格式。若未声明,Python 2 会尝试使用默认的 ASCII 编码去识别中文,从而导致报错。
s = "中文"
E:\PycharmProjects\LEDdisplay2\venv\Scripts\python.exe E:/PycharmProjects/LEDdisplay2/1.py File "E:/PycharmProjects/LEDdisplay2/1.py", line 1SyntaxError: Non-ASCII character '\xe4' in file E:/PycharmProjects/LEDdisplay2/1.py on line 1, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for detailsProcess finished with exit code 1
上述报错信息的含义是:在 1.py 文件的第一行检测到了非 ASCII 字符“\xe4”,且文件中未声明编码格式。
假设我们将编辑器 PyCharm 的环境编码设置为 UTF-8,通过工具查看 1.py 文件的十六进制数据,可以看到“中文”两个汉字在文件中存储为 \xe4\xb8\xad\xe6\x96\x87。
(在 UTF-8 编码下,存储一个汉字通常需要三个字节,因此“中文”两个字符共占用六个字节)
使用 Notepad++ 查看文件的十六进制内容

由于 Python 2 的默认编码格式是 ASCII,它无法识别“\xe4”这样的字节序列,因此无法解析“中文”,进而抛出错误。
解决方法是在 Python 文件的第一行添加 # encoding:utf-8 声明,告知脚本文件的编码方式。这样 Python 就能正确识别代码中的汉字字符串,并依据声明的编码格式进行后续处理。
补充说明:
- 查看 Python 环境的默认编码设置
- 查看字符串的十六进制表示
# encoding:utf-8
import sys

s = "中文"
print(sys.getdefaultencoding())
print (repr(s))
E:\PycharmProjects\LEDdisplay2\venv\Scripts\python.exe E:/PycharmProjects/LEDdisplay2/1.py ascii '\xe4\xb8\xad\xe6\x96\x87'
Process finished with exit code 0
乱码场景二:文件编码与 IDE 环境不一致
如果在 Python 文件开头声明脚本编码为 UTF-8,同时将编辑器 PyCharm 的环境编码设置为 GBK,此时打印中文会出现什么情况?
答案:依然会出现乱码。
# coding=utf-8s = "中文"print(s)
E:\PycharmProjects\LEDdisplay2\venv\Scripts\python.exe E:/PycharmProjects/LEDdisplay2/1.py 涓枃
Process finished with exit code 0
PyCharm 编码设置界面
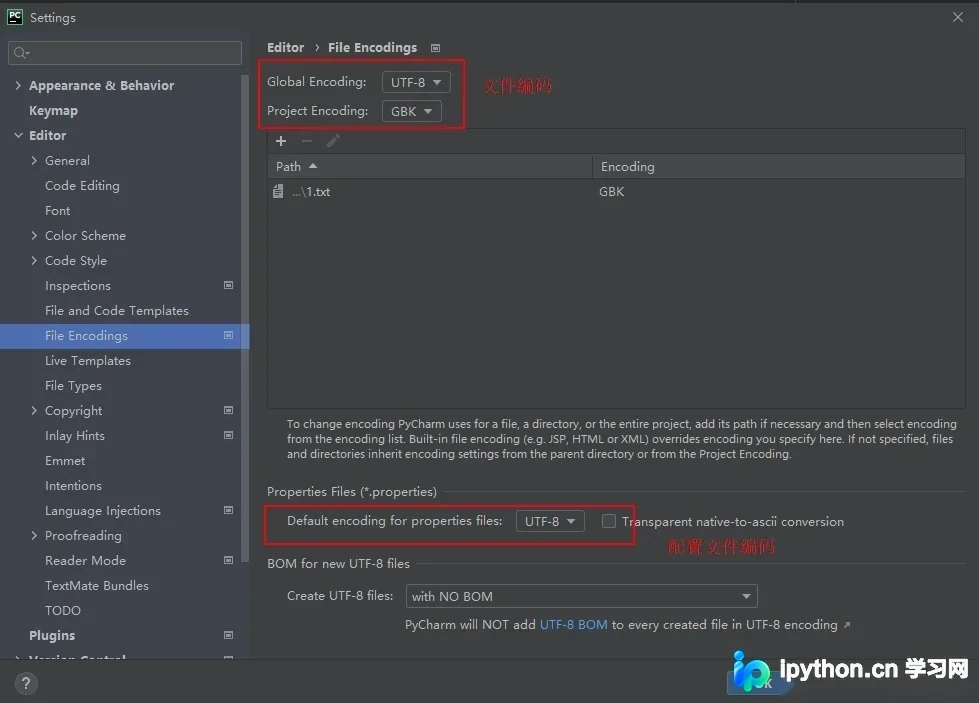
原因在于,上述代码中变量 s 的编码是 UTF-8,而运行脚本的编辑器 PyCharm 设置的环境编码却是 GBK。由于两者编码方式不一致,必然导致显示乱码。
解决该问题有以下几种方法:
(这些方法是互斥的,核心目的是确保文件开头声明的编码格式与 PyCharm 编辑器设置的环境编码格式保持一致)
1. 将编辑器 PyCharm 的环境编码修改为 UTF-8。
2. 将 Python 文件开头声明的脚本编码方式修改为 GBK。
3. 在变量 s 前添加前缀 u,将其强制转换为 Unicode 编码(如前所述,对于 Unicode 编码的字符,Python 打印时会自动根据环境编码转换为特定编码后显示)。
4. 使用 decode 和 encode 函数。decode 方法可以将字符串按指定格式解码为 Unicode。需要注意的是,非 Unicode 类型的字符只能进行 decode 操作,不能进行 encode 操作;而 Unicode 类型的字符只能进行 encode 操作,不能进行 decode 操作。
# encoding:utf-8
s = "中文"
y1 = s.decode("utf-8") # s.decode("utf-8")这句话跟u“中文”效果是等价的
y2 = s.decode("utf-8").encode("gbk")
print(y1)
print(y2)
E:\PycharmProjects\LEDdisplay2\venv\Scripts\python.exe E:/PycharmProjects/LEDdisplay2/1.py 中文 中文
Process finished with exit code 0
注意:在使用 encode 和 decode 时,必须明确指定编码格式。
在 Python 中,不同编码之间不能直接转换,必须通过 Unicode 字符集作为中间过渡。例如,从 UTF-8 转换为 GBK,需要先将 UTF-8 格式的字符串解码为 Unicode,然后再编码为 GBK 格式。
- encode 的正常用法:对 Unicode 类型进行 encode 操作,得到字节串(str 类型)。即:Unicode -> encode(指定编码) -> str。
- decode 的正常用法:对 str 类型进行 decode 操作,得到 Unicode 类型。即:str -> decode(指定编码) -> Unicode。
- encode 的非正常用法:对 str 类型直接进行 encode。由于 encode 需要 Unicode 类型,Python 会先使用默认编码(注意:这里的默认编码是 ASCII,而非文件开头的 encoding 声明)将 str 解码为 Unicode,再使用你指定的编码进行 encode。
- decode 的非正常用法:对 Unicode 类型直接进行 decode。Python 会先使用默认的系统编码将 Unicode 编码为 str 类型,再使用你指定的编码进行 decode。
另外需注意:若使用某种字符编码将 Unicode 编码为 str 类型,则必须使用对应的字符编码将该 str 类型解码回 Unicode 类型。
以下是一个非正常使用的示例:
# encoding:utf-8
import sys

s = "中文"
print(sys.getdefaultencoding())
y3 = s.encode("utf-8")
print(y3)
E:\PycharmProjects\LEDdisplay2\venv\Scripts\python.exe E:/PycharmProjects/LEDdisplay2/1.py ascii Traceback (most recent call last): File "E:/PycharmProjects/LEDdisplay2/1.py", line 5, in <module> y3 = s.encode("utf-8") UnicodeDecodeError: 'ascii' codec can't decode byte 0xe4 in position 0: ordinal not in range(128)
Process finished with exit code 1
从上述代码可以看出,Python 2 的默认编码是 ASCII。当直接对 str 类型的变量 s 进行 encode 操作时,Python 会尝试使用默认编码 ASCII 将变量 s 先 decode 为 Unicode。由于文件开头已声明代码使用 UTF-8 编码,而 ASCII 无法 decode 字节“0xe4”(这是 UTF-8 编码存储变量 s=“中文”时第一个字节的十六进制表示),因此报错。
乱码场景三:命令行环境编码差异
将以下代码文件(保存时选择 UTF-8 编码)直接在命令行中运行,会发生什么问题?
# encoding:gbk
s = "中文"
y1 = s.decode("gbk") #s.decode("gbk")这句话跟u“中文”效果是等价的
y2 = s.decode("gbk").encode("utf-8")
print(y1)
print(y2)
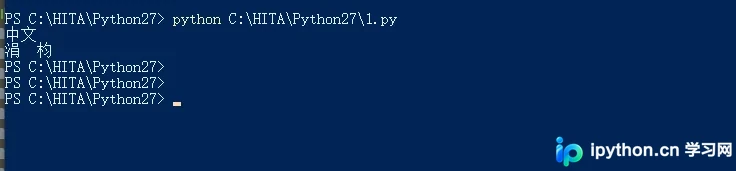
结果显示 y1 正常显示中文,而 y2 出现乱码。
这次出现乱码的原因是什么?
Windows 命令行的环境编码是 GBK 格式。y1 经过 decode 后变为 Unicode 码,如前所述,对于任何 Unicode 类型的字符,Python 打印时会自动根据环境编码转换为特定编码后显示,因此 y1 在 CMD 命令行下能正常显示。
y2 经过解码和编码后变为 UTF-8 格式,这种格式仅在环境编码为 UTF-8 的环境中才能正常显示。在 Windows 命令行(默认 GBK)下运行,因编码不一致导致乱码。
如果上述代码增加一句 print(s),分别在 PyCharm 和 CMD 下运行,结果会如何?
# encoding:gbk
s = "中文"
y1 = s.decode("gbk") #s.decode("gbk")这句话跟u“中文”效果是等价的
y2 = s.decode("gbk").encode("utf-8")
print(y1)
print(y2)
print(s)
E:\PycharmProjects\LEDdisplay2\venv\Scripts\python.exe E:/PycharmProjects/LEDdisplay2/1.py 中文 中文 ����
Process finished with exit code 0
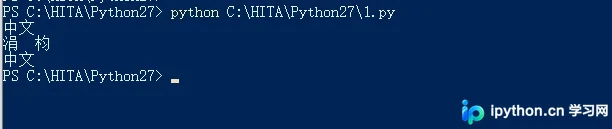
在 PyCharm 环境下运行,输出 s 会乱码。因为 PyCharm 环境编码设置为 UTF-8,而文件开头声明编码是 GBK,两者编码方式不一致,故显示乱码。
在 CMD 环境下运行,输出 s 不会乱码。因为 CMD 环境编码是 GBK,且文件开头声明的编码格式也是 GBK,两者一致,故正常显示。
上述代码均在 Python 2 环境下运行。如果是 Python 3 脚本,处理过程则简单得多。
因为 Python 3 中,所有字符串不再受系统环境编码的影响,统一使用 Unicode 进行编码,字符串类型统一为 str。因此,不再需要在中文前加 u 来强制转换为 Unicode。
此外,所有 Python 3 脚本默认使用 UTF-8 编码,因此通常不需要在脚本开头指定 coding:utf-8(但一般建议保留,以兼容 Python 2)。
打印显示也更为方便。由于所有字符串均为 Unicode 格式,无论是在命令行还是 PyCharm 中,均能正常显示而不会出现乱码。
乱码场景四:命令行直接编写脚本
如果在命令行中直接编写脚本,又会出现什么问题?
我们只需弄清楚字符本身的编码与环境编码是否一致,即可得出结论。
在 Python Shell(即命令行)中直接运行代码时,需要知道:Windows 下命令行的默认编码是 GBK,而 Linux 环境下命令行的默认编码是 UTF-8。
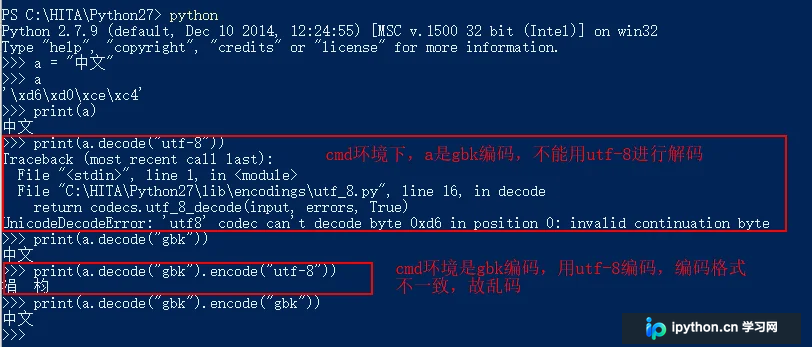
第一行定义 a="中文"时不会报错,因为在命令行中默认是 GBK 编码,此时 a 的编码即为 GBK,支持中文没有任何问题。
直接显示 a 变量时,打印出来的不是乱码,而是该字符串的字节码表示方式。可以理解为这是给计算机看的数据格式,而非给人看的可读内容,只有 print 出来的内容才是给人阅读的。
print(a) 也不会报错,因为按照 GBK 方式编码并在 GBK 环境中运行,逻辑上不会出问题。
直接对 a 进行 decode 解码时,解码方式必须与编码方式一致。GBk 编码的内容不能用 UTF-8 解码为 Unicode,只能用 GBK 解码成 Unicode。
使用 GBK 进行 decode 后,字符串变为 Unicode,Python 会自动根据环境编码进行编码,因此可以正常显示。
最后,若将 Unicode 按照 UTF-8 编码,字符的编码格式又与当前环境编码(GBK)不一致,因此再次出现乱码。
Linux 下同理,区别仅在于 Linux 命令行的默认编码格式是 UTF-8。
总结
以上为个人经验总结,希望能给大家提供参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









