

Numpy argsort函数用法详解:按索引排序与二维数组重排列举

Numpy中的argsort()函数用于获取数组按大小排序后元素的原始位置索引,而非直接输出排序结果。本文详细解析axis参数对行列轴的控制逻辑,通过标准代码演示一维数组的基础索引返回,并深入讲解如何利用返回的索引矩阵精准实现二维数组按指定列的值进行重排行序,附带运行结果对照与常见避坑指南。
Numpy argsort函数基础用法与参数说明
在数据分析与矩阵运算中,经常需要知道元素排序后所在的原位置,而不是单纯的数值重排。argsort() 正是为此设计的函数,它接收一个数组并返回该数组排序后的索引坐标序列。其核心控制参数为 axis:
• axis=0:沿着垂直方向(按列)比较元素,返回每一列内部排序的行索引。
• axis=1:沿着水平方向(按行)比较元素。若省略该参数,默认行为通常依数组维度而定,但在二维矩阵操作中明确指定 axis=1 可避免维度混淆。
第1步:一维数组的索引排序验证
导入标准库后,可直接对列表或一维数组调用该函数。返回的整数序列代表原数组元素从小到大排列时的原始下标。
# 统一使用标准导入方式
import numpy as np

# 一维数组示例
a = np.array([3, 5, 1])
indices_1d = np.argsort(a)
print("一维数组排序索引为:", indices_1d)

# 二维数组基本对比
matrix = np.array([[8, 3, 7], [1, 5, 9]])
print("默认按行排序索引:", np.argsort(matrix, axis=1))
print("按列排序索引:", np.argsort(matrix, axis=0))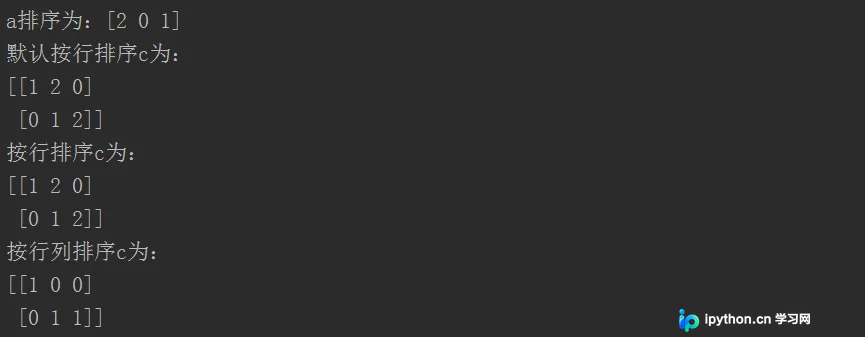
第2步:利用索引矩阵实现二维数组按列重排行序
当需要对多行数据(如表格)按照某一特定列的数值大小重新排列行顺序时,结合 argsort 的输出结果进行切片索引是最高效的方法。以按照第0列数值升序为例:
a = np.array([[0, 11, 12],
              [2, 2, 3],
              [7, 8, 9],
              [1, 2, 3]])

# 沿第0轴计算每列元素的排序行索引
ind = np.argsort(a, axis=0)

# 提取目标列(第0列)的排序行索引
row_order = ind[:, 0]

# 将原数组按提取的索引重排
sorted_matrix = a[row_order]
print("原矩阵:\n", a)
print("第0列排序索引:", row_order)
print("重排后矩阵:\n", sorted_matrix)执行上述代码后,ind 是一个与原数组形状相同的索引矩阵。其中 ind[:, 0] 提取出第0列各元素排序所需的行号(例如结果为 [0, 3, 1, 2]),分别指向原数组的第0、3、1、2行。将此索引数组作用于 a,即可在不破坏数据结构的前提下,依据第0列数值大小完成整行数据的升降序重组。
完成判断与操作避坑
- 结果核对:重排后的首行对应原矩阵中第0列最小值所在的行,末行对应最大值所在的行。可通过打印比较确认数值是否严格递增或递减。
- 索引越界风险:
argsort仅返回合法坐标,不会修改原数组内存。务必确保用于切片索引的维度与原数组行数匹配,否则将触发IndexError。 - 性能提示:对于超大规模数据集,频繁创建中间索引矩阵会占用额外内存。若仅需获取Top-N极值的位置,建议搭配
np.argpartition使用以降低时间复杂度。
总结
掌握 argsort() 的核心在于理解其“返回原始位置而非新数值”的设计逻辑。无论是处理基础的一维查询,还是构建复杂的数据清洗流水线,灵活拆解索引矩阵都能大幅简化多维数据的排序与重构流程。以上就是Python Numpy中argsort()函数用法的详细内容,更多关于Numpy排序技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









