

Java使用HttpURLConnection与正则提取视频下载链接并入库

发布时间:2026-10-13| 5人浏览过
在Java开发中,无需依赖第三方库即可实现基础网页数据抓取。本文通过 HttpURLConnection 发起请求,配合正则表达式定位目标信息,以广度优先策略遍历电影网站的分页列表与详情页面,最终使用JDBC连接将影片标题和下载链接持久化到MySQL数据库中。
抓取原理与策略
本方案旨在从特定电影网站提取“2015年”上映影片的标题及对应的迅雷下载链接。为了确保效率,需对抓取路径进行严格控制:
- 入口选择:仅针对特定的年份分页URL发起请求,忽略网站其他不相关的分类标签或推荐位。
- 页面判断:区分“影片列表页”与“影片详情页”。列表页用于获取下一层级的页面链接,详情页仅提取关键信息(标题、链接)后立即停止深入,不再爬取详情页内的相关推荐。
- 数据存储:将所有提取到的有效资源映射到Map结构中,最后统一连接数据库进行写入。
在构建抓取逻辑时,首先需要确认当前页面的类型。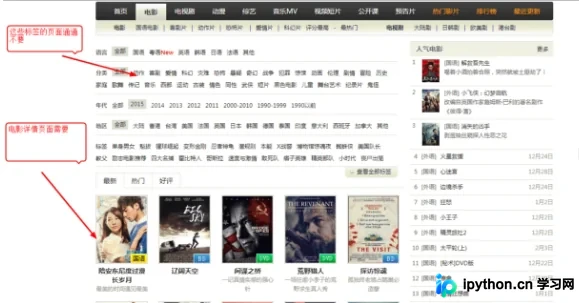 展示了网站的结构特点,明确过滤掉无关的导航链接是提升爬虫效率的关键。
核心代码实现
完整的Java实现类包含两个主要方法:crawlLinks 负责网络请求与页面解析,saveData 负责数据库操作。代码遵循了标准的IO流处理与异常捕获规范。
package action;
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStream;
import java.io.InputStreamReader;
import java.net.HttpURLConnection;
import java.net.MalformedURLException;
import java.net.URL;
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.util.LinkedHashMap;
import java.util.Map;
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class VideoLinkGrab {

  public static void main(String[] args) {
    VideoLinkGrab videoLinkGrab = new VideoLinkGrab();
    // 起始URL为2015年电影的列表首页
    videoLinkGrab.saveData("http://www.80s.la/movie/list/-2015----p");
  }

  /**
   * 主入口:初始化数据库连接并调用爬虫逻辑
   */
  public void saveData(String baseUrl) {
    // 记录已访问URL的状态,防止重复爬取
    Map<String, Boolean> oldMap = new LinkedHashMap<String, Boolean>;
    // 存储结果:Key为影片名,Value为下载链接
    Map<String, String> videoLinkMap = new LinkedHashMap<String, String>;

    // 提取Host域名,用于拼接相对路径
    Pattern p = Pattern.compile("(https?://)[^/\\s]*");
    Matcher m = p.matcher(baseUrl);
    if (m.find()) {
      String oldLinkHost = m.group();
      oldMap.put(baseUrl, false);
      // 开始深度/广度遍历
      videoLinkMap = crawlLinks(oldLinkHost, oldMap);
    } else {
        return;
    }

    // 数据入库阶段
    try {
      Connection connection = JDBCDemo.getConnection();
      for (Map.Entry<String, String> mapping : videoLinkMap.entrySet()) {
        PreparedStatement pStatement = connection
            .prepareStatement("insert into movie(MovieName,MovieLink) values(?,?)");
        pStatement.setString(1, mapping.getKey());
        pStatement.setString(2, mapping.getValue());
        pStatement.executeUpdate();
        pStatement.close();
      }
      connection.close();
    } catch (SQLException e) {
      e.printStackTrace();
    }
  }

  /**
   * 递归遍历页面,提取视频链接
   */
  private Map<String, String> crawlLinks(String oldLinkHost,
      Map<String, Boolean> oldMap) {
    Map<String, Boolean> newMap = new LinkedHashMap<String, Boolean>;
    Map<String, String> videoLinkMap = new LinkedHashMap<String, String>;

    for (Map.Entry<String, Boolean> mapping : oldMap.entrySet()) {
      if (!mapping.getValue()) { // 若该链接未处理过
        String oldLink = mapping.getKey();
        try {
          URL url = new URL(oldLink);
          HttpURLConnection connection = (HttpURLConnection) url.openConnection();
          connection.setRequestMethod("GET");
          connection.setConnectTimeout(2500);
          connection.setReadTimeout(2500);

          if (connection.getResponseCode() == 200) {
            InputStream inputStream = connection.getInputStream();
            BufferedReader reader = new BufferedReader(
                new InputStreamReader(inputStream, "UTF-8"));
            String line = "";
            Pattern pattern = null;
            Matcher matcher = null;

            // 判断页面类型并进行针对性解析
            if(isMoviePage(oldLink)){
              boolean checkTitle = false;
              String title = "";
              while ((line = reader.readLine()) != null) {
                // 提取标题
                if(!checkTitle){
                  pattern = Pattern.compile("([^\\s]+).*?</title>");
                  matcher = pattern.matcher(line);
                  if(matcher.find()){
                    title = matcher.group(1);
                    checkTitle = true;
                    continue;
                  }
                }
                // 提取迅雷下载链接
                pattern = Pattern
                    .compile("(thunder:[^"]+).*thunder[rR]es[tT]itle=\"[^\"]*\"");
                matcher = pattern.matcher(line);
                if (matcher.find()) {
                  videoLinkMap.put(title,matcher.group(1));
                  System.out.println("视频名称: " + title + " ------ 视频链接:" + matcher.group(1));
                  break; // 详情页信息已足够,跳出读取循环
                }
              }
            }
            // 列表页:提取下一级链接
            else if(checkUrl(oldLink)){
              while ((line = reader.readLine()) != null) {
                pattern = Pattern
                    .compile("<a href=\"([^\"\\s]*)\"");
                matcher = pattern.matcher(line);
                while (matcher.find()) {
                  String newLink = matcher.group(1).trim();
                  // 处理相对路径
                  if (!newLink.startsWith("http")) {
                    if (newLink.startsWith("/"))
                      newLink = oldLinkHost + newLink;
                    else
                      newLink = oldLinkHost + "/" + newLink;
                  }
                  if (newLink.endsWith("/"))
                    newLink = newLink.substring(0, newLink.length() - 1);

                  // 过滤已存在链接及非本站链接
                  if (!oldMap.containsKey(newLink)
                      && !newMap.containsKey(newLink)
                      && (checkUrl(newLink) || isMoviePage(newLink))) {
                    newMap.put(newLink, false);
                  }
                }
              }
            }

            reader.close();
            inputStream.close();
          }
          connection.disconnect();
        } catch (MalformedURLException | IOException e) {
          e.printStackTrace();
        }

        // 增加延时,礼貌爬虫
        try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); }
        oldMap.replace(oldLink, false, true);
      }
    }
    // 递归处理新发现的链接
    if (!newMap.isEmpty()) {
      oldMap.putAll(newMap);
      videoLinkMap.putAll(crawlLinks(oldLinkHost, oldMap));
    }
    return videoLinkMap;
  }

  /**
   * 正则判断是否为2015年的列表页URL
   */
  public boolean checkUrl(String url){
    Pattern pattern = Pattern.compile("http://www.80s.la/movie/list/-2015----p\\d*");
    Matcher matcher = pattern.matcher(url);
    return matcher.find();
  }

  /**
   * 正则判断是否为电影详情页URL
   */
  public boolean isMoviePage(String url){
    Pattern pattern = Pattern.compile("http://www.80s.la/movie/\\d+");
    Matcher matcher = pattern.matcher(url);
    return matcher.find();
  }
}
注意事项与排错
在实际应用中,直接使用此类简单正则可能面临目标网站结构变更导致失效的风险。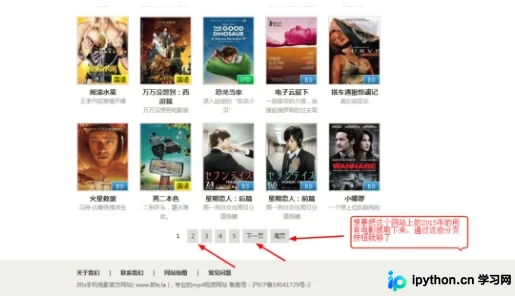 提供了抓取过程中的中间状态参考,建议根据实际页面的HTML结构微调正则表达式中的捕获组。
另外,以下常见错误需注意排查:
- 中文乱码:确保
InputStreamReader指定编码为"UTF-8",且数据库连接字符集一致。 - 相对路径报错:如果链接不以
http开头,必须手动拼接待测域的 Host 地址,否则new URL()会抛出异常。 - 并发限制:示例代码中加入了
Thread.sleep(1000),高并发场景下请考虑更完善的队列机制与限速策略。
测试结果验证
运行上述代码后,控制台会打印出抓取的影片名称与对应链接,随后数据将被插入指定的MySQL表中。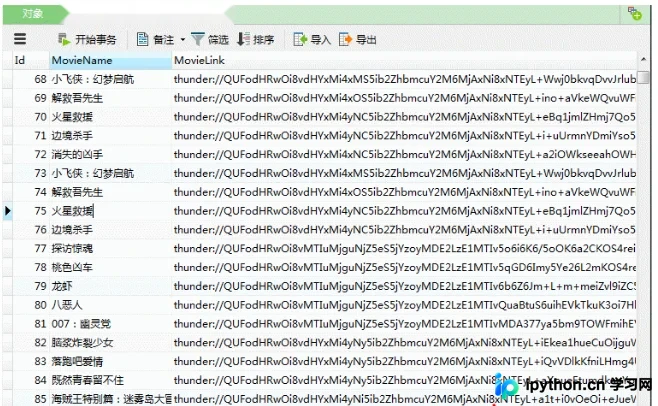 展示了程序运行正常的日志输出界面,表明成功完成了从列表页到详情页的信息抽取。
以上就是Java使用HttpURLConnection与正则提取视频下载链接并入库的详细内容,更多关于Java爬虫与数据处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









