

C语言三大基础排序算法实现与性能对比:选择、冒泡与快速排序

掌握选择排序、冒泡排序和快速排序是理解计算机算法基础的关键。本文通过C/C++代码示例,直观展示这几种常见排序算法的实现过程,并利用大规模随机数据进行实际运行时间测试,帮助读者深入理解不同算法的时间复杂度差异与适用场景。
选择排序与冒泡排序的实现逻辑
选择排序(Selection Sort)的核心思想是每次从未排序序列中找到最小(或最大)元素,存放到已排序序列的末尾。其空间复杂度为O(1),但时间复杂度始终为O(n²)。以下是具体实现:
#include<stdio.h>
void xuanze(int a[],int len){
  int i , j , t , temp;
  for (i = 0 ; i < len - 1 ;i ++)
  {
    t = i;
    for (j = i + 1 ; j < len ; j ++)
    {
      if (a[t] > a[j])
      {
        t = j;//记下该趟最小数的序号
      }
    }
    if (t != i)//如果序号不变就什么也不做
    {
      temp = a[t];//否则元素交换
      a[t] = a[i];
      a[i] = temp;
    }
  }
}
冒泡排序(Bubble Sort)则通过重复遍历数组,比较相邻元素并交换位置,将较大的元素逐渐“浮”到末尾。其代码结构如下:
void maopao(int a[],int len){
  int i,j,temp;
  for(i = 0;i < len - 1 ; i ++){//从第一个到倒数第二个
    for (j = 0 ; j < len - 1 - i ; j ++)//排在后的是已经排序的
    {
      if (a[j] > a[j + 1])//大的数换到后面去
      {
        temp = a[j];
        a[j] = a[j + 1];
        a [j + 1] = temp;
      }
    }
  }
}
快速排序(Quick Sort)的核心算法
快速排序采用分治法策略,通过选择一个基准值(pivot),将数组分为两部分:左侧小于基准,右侧大于基准。然后递归地对两侧进行排序。这种方法平均时间复杂度为O(n log n),在处理大规模数据时优势明显。
以下实现使用了一种双指针扫描的方式来确定分区点,逻辑较为紧凑:
//快速排序,参数是数组,最低索引,最高索引(从0开始)
void qSort(int a[], int low, int high){
  int temp;
  int mid = low;//定义一个中索引,用于记录一次排序后确定位置的一个元素索引
  int right = high;//记录最右元素索引

  //默认中值是左值,现在要把凡是比中值大的元素放到中值左边
  while(right > mid){//因此从右开始向中值遍历,到达中值时遍历结束
    if (a[right] < a[mid])//如果右值比中值还小,说明他不该在右边,要把它放到左边
    {
      temp = a[mid];//所以先把中值的地盘腾出来
      a[mid] = a[right];//把比中值小的那个数放在那儿
      a[right] = a[++mid];//right索引的空间已经腾出来了,就把中值原来右边的值放到right
      a[mid] = temp;//然后就可以把mid右移一位
    }else{
      right--;//否则的话说明right已然大于等于mid,不用移动,继续判断right左边那个数
    }
  }//这样right与mid重合之时,退出循环,此时mid的位置已经确定了
   //因为他左边的都比他小,右边的都比他大
  if (mid - low > 1)//如果low到mid之间还有两个或以上元素,还要对他们排序
  {
    qSort(a, low, mid - 1);
  }
  if (high - mid > 1)//右边那半也是一样
  {
    qSort(a, mid + 1, high);
  }
}
性能实测对比
为了直观展示三种算法的效率差异,我们构建了一个包含99999个随机整数的数组,并使用标准库计时器对它们分别进行排序测试。测试结果显示:
- 快速排序:处理速度极快,通常耗时不到0.05秒。
- 选择排序:由于需要进行大量的元素比较和不必要的潜在交换,在大数据量下表现较差,耗时约20秒左右。
- 冒泡排序:在最坏情况下交换次数最多,是三者中最慢的,耗时可达40-50秒。
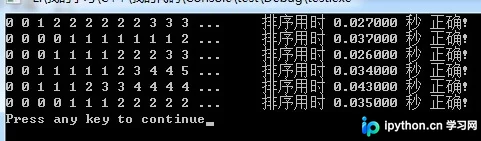
上图展示了部分排序过程的输出结果。可以看到,随着数据量的增加,简单交换类算法的性能瓶颈迅速显现,而基于分治思想的快速排序展现了极高的执行效率。
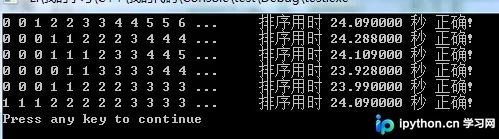
在选择排序的执行过程中,虽然交换次数较少,但其遍历寻找最小值的开销累积起来非常巨大。
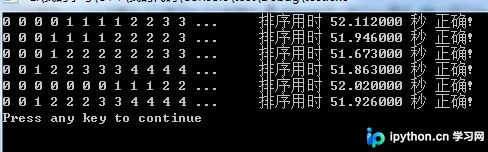
冒泡排序由于其“逐个推进”的特性,在处理无序度高的数据时效率极低,仅适合小规模或近乎有序的数据集。
C++函数模板的泛型应用
在C++环境中,我们可以利用函数模板(Template)使排序算法支持多种数据类型,而不仅仅是整型。只要数据类型支持比较运算(如‘<’),即可复用同一套排序逻辑。
#include <iostream.h>
#include <iostream>

//C++模板函数实现快速排序
template<class T> void qSort(T a[], int low, int high){
  T temp;
  int mid = low;
  int right = high;

  while (right > mid)
  {
    if (a[right] < a[mid])
    {
      temp = a[mid];
      a[mid] = a[right];
      a[right] = a[++mid];
      a[mid] = temp;
    }else{
      right--;
    }
  }
  if (mid - low > 1)
  {
    qSort(a, low, mid - 1);
  }
  if (high - mid > 1)
  {
    qSort(a, mid + 1, high);
  }
}

void main(){
  int a[10] = {1, 9, 6, 3, 5, 7, 1};//整型数组
  qSort(a, 0, 9);
  for (int i = 0; i < 10; i++)
  {
    cout<<a[i]<<" ";
  }
  cout<<endl;

  float b[10] = {2.0f, 1.2f, 5.5f, 6.63f, 9.11f, 1.32f, 3.44f, 5.0f, 5.22f, 0.02f};
  qSort(b, 0, 9);//对浮点数排序
  for (int i = 0; i < 10; i++)
  {
    cout<<b[i]<<" ";
  }
  cout<<endl;

  char c[10] = {'d','e','f','n','j','c','e','b','f','a'};//字符数组
  qSort(c, 0, 9);
  for (int i = 0; i < 10; i++)
  {
    cout<<c[i]<<" ";
  }
  cout<<endl;
}//凡是可以用‘<'来比较大小的类型都可以排序了
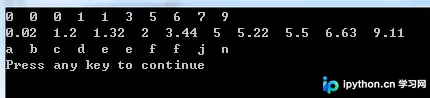
通过上述模板方法,开发者可以轻松扩展排序功能至浮点数、字符甚至自定义结构体(需重载运算符),极大地提高了代码的复用性和灵活性。
总结
选择排序和冒泡排序结构简单,易于理解,常作为算法入门案例,但在实际工程的大数据处理中因其O(n²)的时间复杂度而被弃用。快速排序凭借O(n log n)的平均性能成为主流的基础排序算法之一。在C++开发中,结合模板技术不仅能提升性能,还能增强代码的通用性。
以上就是C语言实现选择排序、冒泡排序和快速排序的代码示例及性能分析的详细内容,更多关于C/C++算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









