

SQL Server 并行查询与 sys.dm_os_waiting_tasks 深度解析:操作符级并行的验证

本文通过分析 SQL Server 的 sys.dm_os_waiting_tasks 动态管理视图,探讨并行查询(Parallel Query)在实际操作中的表现。研究发现,在执行包含多个表的关联查询时,即便启用了并行处理线程,数据库引擎仍然按照执行计划的既定顺序依次访问数据源,阻塞往往发生在当前被扫描的表上,从而验证了并行机制更多是应用于单个物理操作符层面的多线程处理。
并行执行的误解与修正
在讨论 SQL Server 的并行处理时,常有一种直观的理解:当两个表进行内连接(INNER JOIN)且开启并行选项时,系统会分配一组线程去获取 T1 的数据,同时分配另一组线程去获取 T2 的数据,最后由其他线程合并结果集。然而,这种“多表并发扫描”的认知与实际执行计划并不相符。为了深入理解并行处理的真实运作方式,我们需要借助系统视图来观察底层的锁等待和资源消耗情况。
第1步:构建测试环境与模拟阻塞
目的:通过在两张测试表上添加事务锁,强制查询产生阻塞,进而观察 sys.dm_os_waiting_tasks 中反映出的等待行为。
入口:SSMS (SQL Server Management Studio) 查询窗口。
动作:首先开启一个显式事务,然后分别对表 t1 和 t2 执行更新操作以获取排他锁(X Lock)。此时不提交事务,保持会话打开以模拟长时间运行的阻塞场景。
代码操作:
-- 开启事务并锁住两张表
BEGIN TRAN;
UPDATE t1 SET b = GETDATE();
UPDATE t2 SET b = GETDATE();
-- 注意:此处不要 COMMIT 或 ROLLBACK,保持事务挂起参数说明:此处的目标是让后续尝试访问这两张表的查询会话陷入 WAITING 状态。
利用视图观察资源竞争详情
在保持上述阻塞事务的同时,我们可以查询 sys.dm_os_waiting_tasks 来获取正在等待资源的任务详情。通过对比多次查询的结果,可以清晰地看到并行线程究竟在等待什么。
尽管开启了并行查询(例如通过查询提示使用 OPTION (querytraceon 8649)),产生的 21 条等待记录并非均匀分布在两个表中。通过查看 resource_description 字段,我们发现这些等待主要集中在其中一个表的锁对象上。例如,以下展示了典型的 KeyLock 资源描述:
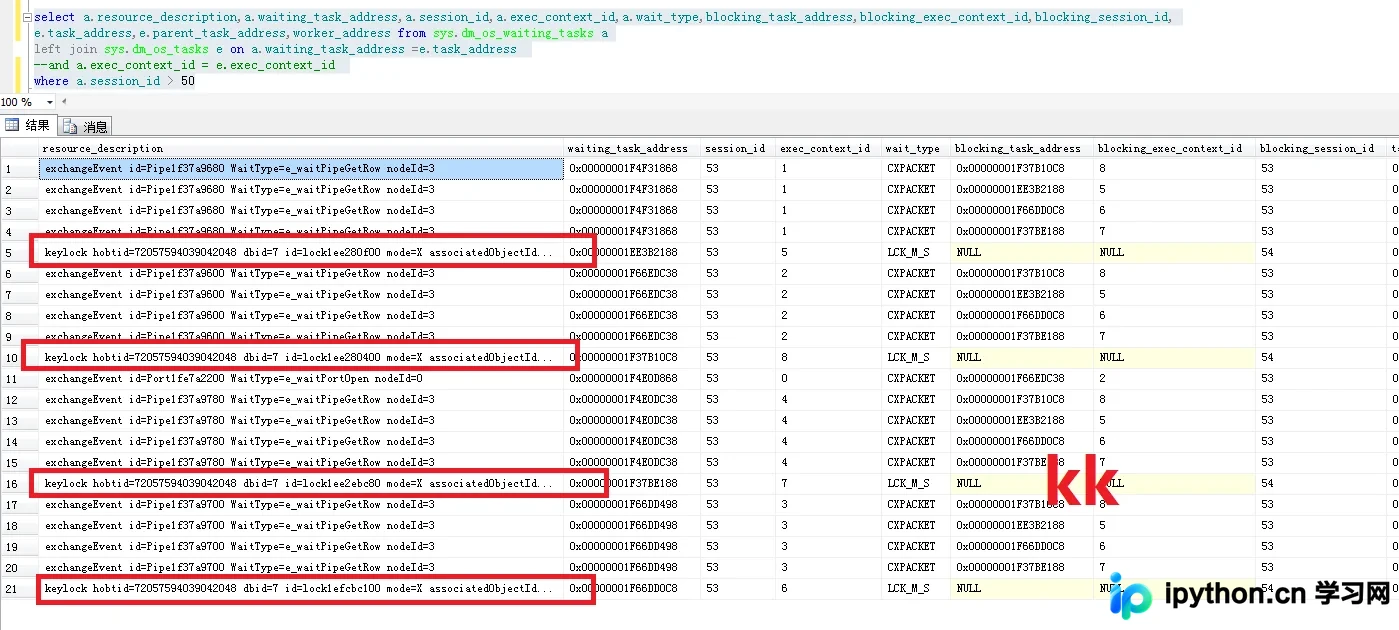
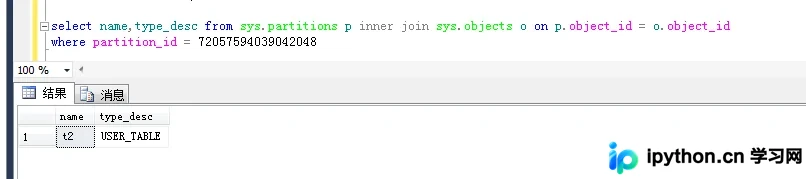
在上述截图中,keylock hobtid=... 指向了具体的分区 ID。经过确认(需在同一数据库上下文中关联 sys.partitions),该 ID 对应的是表 T2 的一个内部表结构或相关页。这证实了一个关键结论:虽然查询整体是并行的,但引擎依然选择先扫描 T2,因此所有的 I/O 请求和随之而来的锁请求都集中在 T2 上。如果真的是如前所述的多表并行扫描,我们应该能观察到 T1 和 T2 同时存在大量的 LCK_M_S(共享锁等待)或其他类型的资源争用。
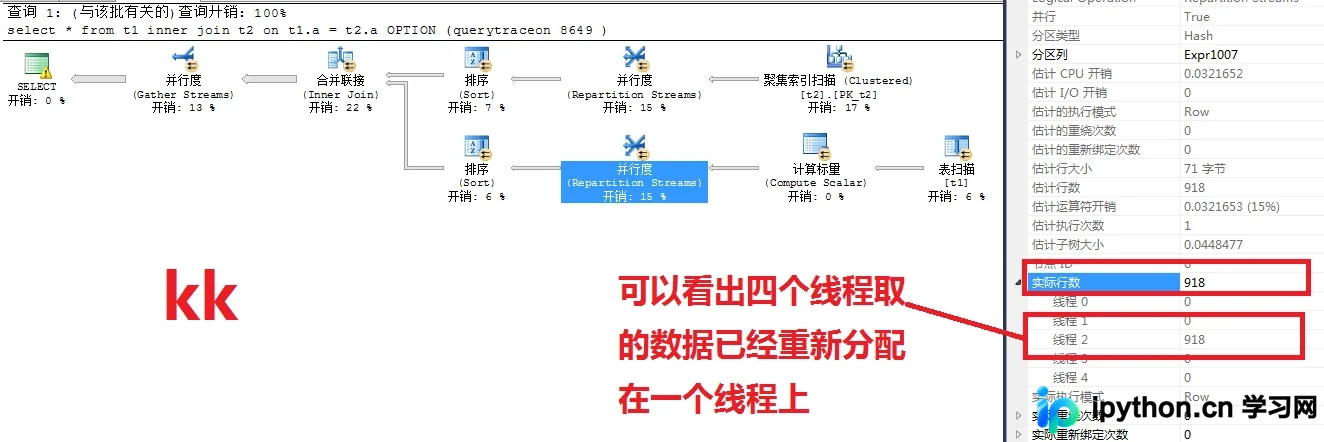
从执行计划的角度看,优化器决定了数据流的走向。在这个例子中,由于某些统计信息或成本估算的原因,T2 成为了驱动表或被优先选择的输入源。这意味着,所有的并行子任务都在试图加速对这个特定数据源的扫描过程,而不是各自负责不同的表。
深入解析:操作符级别的并行
基于以上现象,可以对 SQL Server 的并行策略做出更精确的描述:
- 非操作符间并行:并行机制通常不会将两个完全独立的逻辑操作符(如两个毫无依赖关系的扫描)直接映射到不同的一组物理线程上进行并发I/O(除非涉及复杂的调度开销大于收益的场景)。
- 操作符内拆分:所谓的“并行”,更多是指将一个大的物理操作符(如 Table Scan、Index Seek 或 Sort)拆分成多个部分。每个物理线程负责数据集中的一部分(例如不同的行组、页面或桶),然后并行地执行计算或I/O。
对于用户提出的关于 UNION ALL 各部分为何不能同时执行的疑问,其原理也是类似的:并行调度器倾向于将工作量分摊给可用的线程池,以提高单个操作的吞吐量,而不是为了并行运行多个简单的集合操作。当然,具体的底层实现还涉及到 INTERNAL_TABLE 等内部结构的处理细节,这表明在特定的执行阶段,资源的管理方式可能会有所不同。
自动化捕获等待信息的实践技巧
为了持续观察一条语句执行期间的完整等待画像,手动执行查询往往不够全面。这里提供一个实用的脚本片段,用于持续抓取 sys.dm_os_waiting_tasks 的动态变化,并将其保存到临时表中供事后分析。
-- 声明变量用于轮询计数
DECLARE @a INT;
SET @a = 0;

-- 确保目标表存在且已清空
TRUNCATE TABLE waiting_ecec;

-- 循环抓取等待信息(生产环境请谨慎使用,建议缩短间隔或限制次数)
WHILE 1=1 BEGIN
    INSERT INTO waiting_ecec
    SELECT @a, * FROM sys.dm_os_waiting_tasks
    WHERE session_id > 50;
    SET @a = @a + 1;
END

-- 查询最终累积的所有等待快照
SELECT * FROM waiting_ecec;
配合以下针对特定会话的请求分析语句,可以更精准地定位问题源头:
-- 假设我们要分析 Session 53 的详细信息
SELECT a.resource_description,
       a.waiting_task_address,
       a.session_id,
       a.exec_context_id,
       a.wait_type,
       blocking_task_address,
       blocking_exec_context_id,
       blocking_session_id,
       e.task_address,
       e.parent_task_address,
       worker_address
FROM sys.dm_os_waiting_tasks a
LEFT JOIN sys.dm_tasks e
    ON a.waiting_task_address = e.task_address
    AND a.exec_context_id = e.exec_context_id
WHERE a.session_id > 50;

-- 补充主请求的状态信息
SELECT session_id,
       status,
       blocking_session_id,
       wait_type,
       last_wait_type,
       scheduler_id,
       task_address
FROM sys.dm_exec_requests
WHERE session_id = 53;
通过结合 sys.dm_exec_requests 和 sys.dm_os_waiting_tasks,我们能够还原出执行过程中每一个瞬间的资源争夺状态,从而更准确地判断性能瓶颈是来自于磁盘 I/O、CPU 压力还是锁冲突。
以上就是 SQL Server 并行查询机制与 sys.dm_os_waiting_tasks 应用的详细内容,更多关于 SQL Server 性能调优与分析的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









