

提升MySQL InnoDB全表扫描速度的核心优化方案

在使用MySQL进行大规模数据备份或执行在线结构变更(Online Schema Change)时,InnoDB引擎的全表扫描往往成为性能瓶颈,导致备份周期过长甚至影响业务稳定性。传统线性预读取在碎片化严重的表中效果有限,根本原因在于无法保证物理页面的连续顺序访问。通过引入逻辑预读取(Logical Read Ahead)机制,结合主键页顺序扫描策略与批量异步IO提交技术,可以显著减少磁盘随机寻道次数,将全表扫描速度提升10倍以上,是优化InnoDB大表操作的核心手段。
全表扫描面临的性能挑战
大多数应用程序通过索引定位少量数据进行查询,但在逻辑备份(如 mysqldump)、数据导出(SELECT ... INTO OUTFILE)以及在线Schema变更等场景中,必须对整张表进行全表扫描。相比物理备份,逻辑备份具有体积小、易于解析和修复等优势,但其还原速度慢且扫描过程耗时较长,常成为运维痛点。
InnoDB作为基于聚簇索引的存储引擎,全表扫描默认按照主键顺序遍历叶子节点。若主键页面在磁盘上紧密排列,扫描效率接近顺序文件读取(如Linux中的 dd if=... of=/dev/null),速度极快。然而,在实际生产环境中,由于主键设计不当(如复合键无序插入)、频繁更新导致页分裂等因素,主键页面往往存在严重碎片化。
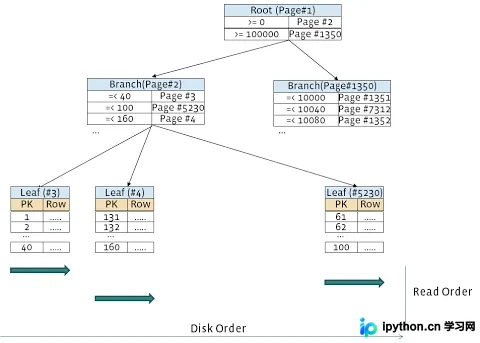
当主键页面碎片化严重时,InnoDB在读取完当前页面后,需跳转至磁盘地址截然不同的下一个页面。这种模式从顺序读取退化为随机读取。对于机械硬盘(HDD)而言,磁头寻道时间的开销巨大,使得全表扫描速度大幅下降,即便使用SSD缓解,成本也较为高昂。因此,优化的核心在于如何让InnoDB尽可能执行顺序读取。
现有预读取技术的局限性与替代方案
线性预读取(Linear Read Ahead)
InnoDB原生支持线性预读取功能,可通过 innodb_read_ahead_threshold 参数配置。其机制是在发现连续访问页面时,提前读取一个Extent(通常64个Page)。但在页面高度碎片的场景下,下一个逻辑主键页往往不在当前的Extent范围内,导致该技术失效,无法改善性能。
用户自定义函数预加载(UDF Buffer Warmup)
一种思路是使用UDF直接顺序读取 .ibd 数据文件并将Page载入Buffer Pool,随后执行内存中的全表扫描。这种方法虽能利用顺序IO,但存在明显缺陷:
- 空间限制:若表容量超过Buffer Pool上限,预热将无效。
- I/O浪费:需要读取整个文件,包括非必要的二级索引页和元数据,造成额外I/O开销。
- 侵入性**:应用层需修改代码以调用特定函数。
为此,更优的解决方案是直接在存储引擎内部实现的逻辑预读取(Logical Read Ahead, LRA)。
核心优化策略一:逻辑预读取(LRA)
逻辑预读取旨在模拟顺序IO的行为,同时保持仅读取必要数据的精准度。其工作流程如下:
- 探测主键结构:读取部分主键分支页面,估算叶子节点的分布情况。
- 计算页数:确定需要读取的叶子页面数量。
- 排序并预读:根据页面号(Page Number)对目标叶子页面进行排序,使其在磁盘上的物理位置尽可能靠近,然后按此顺序批量读取指定数量的叶子页面。
- 正常扫描:最后再按照主键的逻辑顺序逐行读取已缓存的数据。
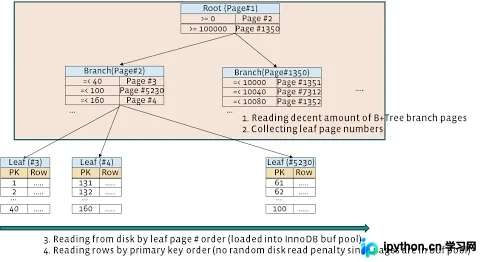
LRA解决了上述UDF方案的痛点:它仅读取主键叶子页面,避免读取冗余的二级索引;且无需修改SQL语法或应用代码。为了启用该功能,在运行 mysqldump 或大型查询前,需设置以下会话级变量:
innodb_lra_size:控制预读取的叶子页面总大小(字节),建议设置为512MB~4096MB,以便一次性获取大量顺序连续的页面。innodb_lra_sleep:每次预读取操作间的休眠时间(毫秒),用于平衡CPU调度与IO线程的执行效率,测试中设为50ms左右表现稳定。
注意:这些变量为Session级别,仅在当前连接生效,不会影响其他并发事务。
核心优化策略二:批量提交异步I/O请求
在早期的InnoDB版本中,即使是预读取机制,每次底层API(如Linux aio)提交的请求往往仅包含单个Page(16KB)。对于现代RAID或高性能HDD阵列,小块随机I/O的效率远低于大块顺序I/O。
优化方案是在调用 io_submit() 之前,将多个连续的页面读取请求合并为一个批次提交。实验数据显示,在单盘环境下,单次提交64个页面的连续读取请求可获得超1GB/s的吞吐量,而单次仅提交一个页面则仅有约160MB/s。这一改进大幅降低了上下文切换开销,提升了磁盘带宽利用率。
性能基准测试对比
在生产环境的真实大表测试中,经过上述两项优化(LRA + 批量IO提交),性能提升效果显著:
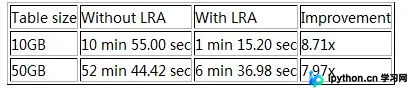
场景1:纯HDD环境全表扫描
在无其他负载干扰的情况下,开启优化后的全表扫描速度相比基线提升了约10倍。这直接缩短了逻辑备份所需的时间窗口,缓解了备份对白天业务的影响。
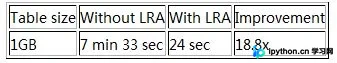
场景2:高负载下的Online Schema Change
在执行大规模表的DDL操作期间,优化后的扫描阶段耗时大幅降低。不仅加快了锁表到释放锁的过程,还减少了对线上并发查询的阻塞时长。
总结与注意事项
InnoDB全表扫描慢的本质在于物理存储碎片与逻辑遍历不匹配导致的随机IO。通过实施逻辑预读取(LRA)技术,将离散的主键页在读取前进行物理排序和批量预取,再辅以底层I/O请求的批量化处理,可以有效绕过HDD随机寻道的瓶颈。
适用建议:
- 在执行
mysqldump全量备份前,建议在Dump进程连接的会话中临时调大innodb_buffer_pool_size(如果资源允许)并设置innodb_lra_size。 - 对于拥有海量数据的宽表,优化带来的收益远大于普通小表。
- 该特性目前多见于针对特定业务优化的MySQL分支或企业版补丁中,社区版标准发行版可能未默认包含最新完整实现,部署前请确认数据库版本及补丁情况。
以上就是大幅提升MySQL InnoDB全表扫描速度的详细内容,更多关于MySQL性能调优与存储引擎底层优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









