

MySQL事务机制详解:ACID特性、隔离级别与SQL控制

在银行转账或订单处理等关键业务中,如何确保数据的一致性?本文将深入解析MySQL事务的ACID特性,辨析扁平、嵌套及分布式事务的区别,并详细说明如何通过SQL语句控制事务流程,以及配置不同的隔离级别以解决脏读、不可重复读和幻读等并发问题。
为什么需要事务
以ATM取钱为例,这一过程包含多个步骤:验证密码、查询余额、扣减账户金额、吐钞和取走现金。如果在“扣减金额”成功后,“吐钞”环节发生故障,导致钱被扣除但未发出,就会造成严重的数据不一致。
为了解决此类问题,数据库引入了事务(Transaction)概念。事务由一条或多条SQL语句组成,其核心逻辑是:要么所有操作全部成功,要么如果任何一步失败,则全部撤销,回滚到初始状态。这种机制确保了数据的完整性和一致性。
事务的ACID特性
一个可靠的事务必须满足以下四个特性:
- 原子性(Atomicity):事务是不可分割的最小工作单元。事务中所有的操作要么都发生,要么都不发生。如果部分失败,已执行的操作必须回滚。
- 一致性(Consistency):事务执行前后,数据库必须从一个一致性状态变换到另一个一致性状态。例如,转账过程中,A转给B 100元,A减少100,B增加100,总金额不变。
- 隔离性(Isolation):并发执行的事务之间互不干扰。一个事务的执行不应被其他事务干扰,通常通过锁机制实现。
- 持久性(Durability):一旦事务提交,其对数据库的修改就是永久性的,即使随后发生系统宕机,数据也不会丢失。
事务的类型
根据应用场景和复杂度的不同,事务主要分为以下几种类型:
第1步:理解扁平事务
这是最常见且最简单的事务类型。所有操作处于同一层次,直到遇到错误进行整体回滚,或成功时整体提交。
BEGIN WORK
  Operation 1
  Operation 2
  ...
  Operation N
COMMIT WORK

-- 或者在出错时
BEGIN WORK
  Operation 1
  ...
ROLLBACK WORK -- 发生错误,整体回滚局限性:无法只提交或回滚事务的一部分。例如,从呼和浩特到北京再到深圳,若中间航班延误,扁平事务可能导致整段行程作废,成本过高。
第2步:使用带有保存点的扁平事务
为了降低回滚代价,MySQL支持在事务中设置保存点(Savepoint)。这样可以在出错时,只回滚到特定的保存点,而不是整个事务。
第3步:区分链事务与嵌套事务
- 链事务:回滚时只能恢复到最近一个保存点,形成链式结构。
- 嵌套事务:在一个顶层事务中可以包含子事务。子事务可以独立提交或回滚,但只有当父事务最终成功提交时,子事务的提交才真正生效;若父事务回滚,所有子事务也一并回滚。
BEGIN WORK  -- 顶层事务
  BEGIN WORK  -- 子事务1
    SubOperationX
  COMMIT WORK  -- 子事务1提交(暂存)
  BEGIN WORK  -- 子事务2
    SubOperationY
  COMMIT WORK  -- 子事务2提交(暂存)
COMMIT WORK   -- 顶层事务提交,所有子事务正式生效
第4步:了解分布式事务
当涉及多个跨网络节点的不同数据库时(如跨行转账),需要使用分布式事务来保证各节点间的ACID特性。
MySQL中的事务控制操作
MySQL默认开启自动提交(AUTOCOMMIT=1),每条SQL执行后立即提交。手动控制事务需使用以下命令:
第5步:开启与控制事务
- 开启事务:使用
BEGIN或START TRANSACTION,或将当前会话设为SET AUTOCOMMIT=0。 - 提交事务:使用
COMMIT,将未提交的修改永久写入数据库。 - 回滚事务:使用
ROLLBACK,撤销所有未提交的修改。 - 设置保存点:使用
SAVEPOINT identifier创建标记。 - 回滚到保存点:使用
ROLLBACK TO identifier。 - 删除保存点:使用
RELEASE SAVEPOINT identifier。
执行DDL语句(如
ALTER TABLE, DROP TABLE)、管理语句或修改架构语句时,MySQL会自动隐式提交当前事务,无需手动处理。
事务隔离级别与并发问题
为防止并发访问导致的数据异常,InnoDB提供了四种隔离级别。级别越低,性能越高,但数据风险越大。
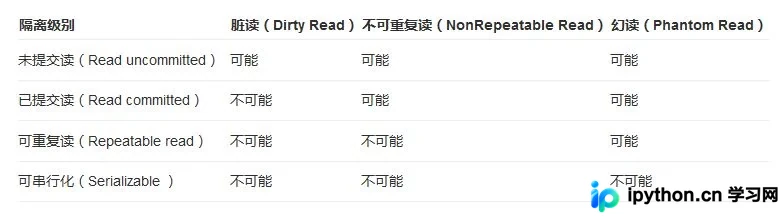
常见的并发问题
- 脏读(Dirty Read):读取了其他事务尚未提交的数据。若该事务随后回滚,读取到的数据即为无效数据。
- 不可重复读(Non-Repeatable Read):在同一事务中,两次读取同一数据结果不同。通常因为其他事务修改或删除了该数据并提交。
- 幻读(Phantom Read):在同一事务中,两次使用相同的WHERE条件查询,返回的行数不同。通常因为其他事务插入或删除了符合新条件的行。
四种隔离级别详解
- READ UNCOMMITTED(读未提交):最低级别,允许脏读、不可重复读和幻读。
- READ COMMITTED(读已提交):防止脏读,但存在不可重复读和幻读。Oracle默认此级别。
- REPEATABLE READ(可重复读):MySQL InnoDB默认级别。防止脏读和不可重复读。InnoDB通过MVCC机制在一定程度上也解决了幻读问题。
- SERIALIZABLE(串行化):最高级别,强制事务串行执行,避免所有并发问题,但性能最低。
第6步:设置事务隔离级别
可以使用 SET TRANSACTION 语句调整隔离级别。语法如下:
-- 仅影响下一个事务(默认行为)
SET TRANSACTION ISOLATION LEVEL READ COMMITTED;

-- 影响当前会话后续所有新事务
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;

-- 影响全局所有新建连接(需SUPER权限)
SET GLOBAL TRANSACTION ISOLATION LEVEL SERIALIZABLE;
可通过以下命令查看当前会话的隔离级别:
mysql> select @@tx_isolation;InnoDB默认的 REPEATABLE READ 级别通常足以满足大多数业务需求,能在数据一致性和性能之间取得良好平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









