

Python中使用xlrd与xlwt读写Excel表格实战详解

在Python数据分析与报表自动化场景中,经常需要定期生成服务器使用情况等统计报表。针对传统Excel文件的读写需求,本文基于开源库xlrd与xlwt整理了一套完整的实操方案,重点解决读取时的日期浮点异常、合并单元格内容为空等常见问题,并提供写入时的样式定制与多Sheet管理代码。
环境准备与核心逻辑
Python操作Excel主要依赖两个经典第三方库:xlrd负责读取,xlwt负责写入。两者均通过pip安装即可调用。在实际开发中,需注意这两个库对旧版.xls格式的支持最为稳定。以下将按“读取”与“写入”两大主线拆解真实操作步骤。
第1步:使用xlrd读取Excel数据
读取阶段的核心目标是精准提取指定Sheet的行列数据,并正确处理特殊数据类型。
第1步:加载工作簿并定位Sheet
目的:打开目标文件并切换到需要处理的工作页。
入口:使用 xlrd.open_workbook() 传入文件绝对路径。
# -*- coding: utf-8 -*-
import xlrd
import xlwt
from datetime import date, datetime

def read_excel():
  # 打开文件
  workbook = xlrd.open_workbook(r'F:\demo.xlsx')

  # 获取所有sheet名称列表
  print(workbook.sheet_names())  # 输出: ['sheet1', 'sheet2']

  # 根据sheet索引或者名称获取sheet内容
  sheet2 = workbook.sheet_by_index(1)  # sheet索引从0开始
  # sheet2 = workbook.sheet_by_name('sheet2')

  # 打印sheet的名称,行数,列数
  print(sheet2.name, sheet2.nrows, sheet2.ncols)

if __name__ == '__main__':
  read_excel()
执行后控制台会返回工作簿的基本结构信息。此时可继续提取特定行、列或单元格的数据:
# 获取整行和整列的值(数组)
rows = sheet2.row_values(3)   # 获取第四行内容
cols = sheet2.col_values(2)   # 获取第三列内容

# 获取单元格内容(注意Python 3需处理编码)
print(sheet2.cell(1,0).value.encode('utf-8'))
print(sheet2.cell_value(1,0).encode('utf-8'))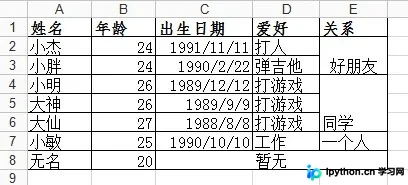
第2步:识别数据类型与解析日期
目的:解决单元格明明存储的是出生日期,但读取后显示为浮点数的问题。
xlrd返回的单元格类型由 ctype 标识,常见映射为:0为空值、1为字符串、2为数字、3为日期、4为布尔值、5为错误值。
> sheet2.cell(2,2).ctype  # 对应出生日期单元格
3
> sheet2.cell(2,2).value
33656.0
当判定 ctype == 3 时,必须使用 xlrd.xldate_as_tuple() 将其转换为元组格式,再拼接为标准的 datetime.date 对象:
date_value = xlrd.xldate_as_tuple(sheet2.cell_value(2,2), workbook.datemode)
datetime_obj = date(*date_value[:3])
formatted_date = datetime_obj.strftime('%Y/%m/%d')  # 输出: '1992/02/22'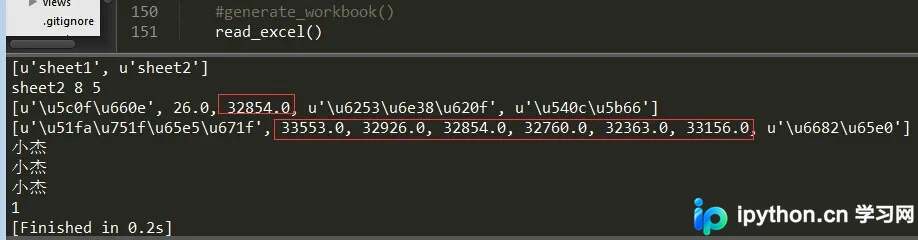
第3步:准确提取合并单元格内容
目的:修复直接按行列索引读取合并区域时返回空串的缺陷。
普通单元格与合并单元格均可留空,因此需先获取真正的合并区域列表。默认参数下 workbook.merged_cells 返回空数组,必须在打开文件时显式开启格式解析:
# 必须开启 formatting_info=True 才能读取合并布局
workbook = xlrd.open_workbook(r'F:\demo.xlsx', formatting_info=True)
sheet2 = workbook.sheet_by_name('sheet2')
print(sheet2.merged_cells)
# 输出示例: [(7, 8, 2, 5), (1, 3, 4, 5), (3, 6, 4, 5)]
返回的四元组含义为 (row_start, row_end, col_start, col_end),采用左闭右开区间。只需取每个区间的起始坐标作为读取锚点:
merge_keys = []
for (rlow, rhigh, clow, chigh) in sheet2.merged_cells:
  merge_keys.append([rlow, clow])

for index in merge_keys:
  print(sheet2.cell_value(index[0], index[1]))
# 依次输出: 暂无, 好朋友, 同学
第2步:使用xlwt写入与排版Excel
写入阶段的重点在于构建复杂的报表结构,包括自定义字体字号、跨行跨列合并以及多页签编排。
第1步:封装字体样式对象
目的:实现标题、表头与正文字体、粗细、颜色的一致性控制。
入口:实例化 xlwt.XFStyle() 并配置 Font 属性。
def set_style(name, height, bold=False):
  style = xlwt.XFStyle()  # 初始化样式容器
  font = xlwt.Font()      # 创建字体实例
  font.name = name
  font.bold = bold
  font.color_index = 4    # 字体颜色索引
  font.height = height
  style.font = font
  return style
第2步:填充表头、表尾与主体数据
目的:按照业务指标生成规整的交叉统计表。
入口:创建工作簿 f = xlwt.Workbook(),添加Sheet后通过循环写入基础网格。
def write_excel():
  f = xlwt.Workbook()
  sheet1 = f.add_sheet(u'sheet1', cell_overwrite_ok=True)

  row0 = [u'业务',u'状态',u'北京',u'上海',u'广州',u'深圳',u'状态小计',u'合计']
  column0 = [u'机票',u'船票',u'火车票',u'汽车票',u'其它']
  status = [u'预订',u'出票',u'退票',u'业务小计']

  # 写入第一行标题
  for i in range(len(row0)):
    sheet1.write(0, i, row0[i], set_style('Times New Roman', 220, True))

  # 写入左侧分类列与右侧合计列(每4行合并一次)
  i, j = 1, 0
  while i < 4*len(column0) and j < len(column0):
    sheet1.write_merge(i, i+3, 0, 0, column0[j], set_style('Arial', 220, True))
    sheet1.write_merge(i, i+3, 7, 7)
    i += 4
    j += 1

  sheet1.write_merge(21, 21, 0, 1, u'合计', set_style('Times New Roman', 220, True))

  # 写入中间状态分类列
  i = 0
  while i < 4*len(column0):
    for j in range(len(status)):
      sheet1.write(j+i+1, 1, status[j])
    i += 4

  f.save('demo1.xls')  # 注意xlwt默认保存为xls后缀

if __name__ == '__main__':
  write_excel()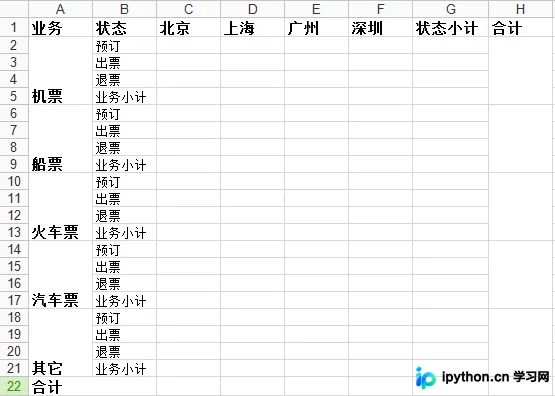
核心方法 write_merge(x, x+m, y, y+n, string, style) 的参数顺序为:起始行、跨行数量、起始列、跨列数量、填充文本、应用样式。所有坐标均以0为基准计数。
第3步:追加新Sheet并保存文件
目的:在同一份文件中输出多张关联数据表。
入口:在 f.save() 执行前,重复调用 f.add_sheet() 并填入第二份数据。
sheet2 = f.add_sheet(u'sheet2', cell_overwrite_ok=True)
head_row = [u'姓名',u'年龄',u'出生日期',u'爱好',u'关系']
col_list = [u'小杰',u'小胖',u'小明',u'大神',u'大仙',u'小敏',u'无名']

for i in range(len(head_row)):
  sheet2.write(0, i, head_row[i], set_style('Times New Roman', 220, True))
for i in range(len(col_list)):
  sheet2.write(i+1, 0, col_list[i], set_style('Times New Roman', 220))

# 演示跨列与跨行合并
sheet2.write_merge(7, 7, 2, 4, u'暂无')
sheet2.write_merge(1, 2, 4, 4, u'好朋友')
f.save('demo1.xls')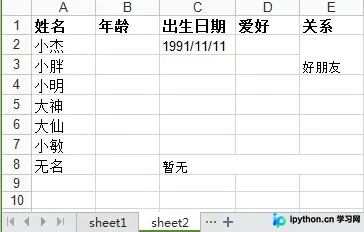
关键问题排查与版本提示
- 日期解析容错:部分老旧报表可能混用文本型日期,建议在判断
ctype==3前后增加try-except捕获转换异常。 - 合并区域边界确认:写入合并单元格的范围请勿超出实际数据边界,否则可能导致部分渲染器打开时弹出损坏警告。
- 库版本差异:本文代码基于Python 3语法重写,原始素材中的print语句已做兼容性升级。另外请注意,
xlrd≥ 2.0.0 版本出于安全与维护考量已停止支持.xlsx格式,若需处理新版Excel请迁移至openpyxl或xlwings。
以上就是Python使用xlrd与xlwt读写Excel表格操作详解的详细内容,更多关于Python办公自动化与数据处理技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









