

C语言中char与unsigned char的核心区别解析

发布时间:2026-10-14| 2人浏览过
在C/C++开发中,`char`与`unsigned char`仅相差一个字节且内存布局一致,但在处理高位数据(如网络字节流或文件读取)并转换为更大整数类型时,两者的行为截然不同。本文将揭示有符号数扩展与无符号数零扩展的底层逻辑。
核心差异:符号位与扩展规则
C语言中,基础数据类型默认均为 signed(有符号)。以 char 为例,它与 unsigned char 的主要区别在于对最高位的解释方式:
- char (signed):最高位被视为符号位。能表示的范围是 -127 到 127(具体取决于编译器实现,通常补码为-128~127)。
- unsigned char:没有符号位概念,8个比特位全部用于数值表示。范围是 0 到 255。
在单纯的内存赋值、读写文件或处理网络字节流时,由于都是按“一个字节”读取,无论最高位是0还是1,原始的二进制数据不会发生变化。真正的区别发生在类型转换阶段,尤其是将单个字节赋值给更大的整型变量(如 int, long, unsigned int)时。
系统在进行隐式类型转换时会执行数值扩展:
- Signed char 扩展(符号扩展):如果原字符的最高位是1(即负数),系统在扩展至高32位(或16位)时,会用1填充高位的空余比特;如果是0,则用0填充。
- Unsigned char 扩展(零扩展):无论最高位是0还是1,系统在扩展时一律用0填充高位。
第1步:验证类型转换的行为差异
通过以下代码可以直观地看到,当输入相同的高位值时,int 与 unsigned int 接收到的数值完全不同。
#include <stdio.h>
#include <stdlib.h>

void f(unsigned char v) {
    char c = v;
    unsigned char uc = v;

    unsigned int a = c, b = uc;
    int i = c, j = uc;

    printf("----------------\n");
    printf("%%c: %c, %c\n", c, uc);
    printf("%%X: %X, %X\n", c, uc);
    printf("%%u: %u, %u\n", a, b);
    printf("%%d: %d, %d\n", i, j);
}

int main(int argc, char *argv[]) {
    // 测试高位为1的情况 (128)
    f(0x80);
    // 测试高位为0的情况 (127)
    f(0x7F);
    return 0;
}
运行上述程序,观察输出结果:
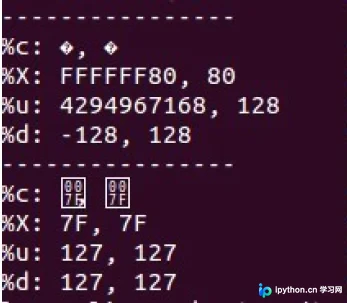
第2步:深度分析结果输出
结合图片中的打印信息,我们可以拆解具体的二进制演变过程:
1. 当输入值为 0x80 时(十进制128)
- 二进制表示:1000 0000
- 作为 signed char (c):因为最高位是1,系统将其视为负数。当赋给
unsigned int a或int i时,发生符号扩展。高24位全被补上1,变成 0xFFFFFFFF(unsigned int显示为 4294967295)和 0xFFFFFF80(int显示为 -128)。 - 作为 unsigned char (uc):不发生符号判断。当赋给
unsigned int b或int j时,发生零扩展。高24位补0,变成 0x00000080(4种显示格式均对应正常数值128)。
2. 当输入值为 0x7F 时(十进制127)
- 二进制表示:0111 1111
- 两种情况均无差别:因为最高位是0。无论是
signed char还是unsigned char,扩展后的高位都补0。此时 `a, b, i, j` 的值完全一致。
总结
在实际工程应用中,如果你需要存储原始的字节流数据(例如解析二进制协议、读取RAW图像文件或加密哈希值),强烈建议使用 unsigned char。这样可以避免在使用高位字节(≥0x80)时产生意外的符号扩展错误。以上就是C语言char与unsigned char的区别详细介绍,更多关于C语言数据类型优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









