

详解Go语言一致性哈希:原理与自定义实现

在分布式系统中,随着缓存节点的增加,如何最小化数据迁移是核心难题。传统哈希取模会导致全部Key失效,引发严重的缓存雪崩。本文深入解析一致性哈希算法如何通过“哈希环”与“虚拟节点”机制缓解该问题,并基于Go语言的groupcache源码逻辑,提供可运行的自定义实现代码。
背景:哈希取模的局限性
在构建分布式缓存集群时,我们需要将大量数据分散到多个节点上以提高容量和性能。最直观的路由策略是将 Key 的哈希值对节点总数取模(n = Hash(key) % N)。
假设我们有 3 个 Redis 节点,当插入 5 个数据时,各 Key 根据余数被分配到指定节点:
| Key的哈希值 | 模3的余 | 目标节点 |
|---|---|---|
| 10 | 1 | Redis1 |
| 4 | 1 | Redis1 |
| 6 | 0 | Redis0 |
| 8 | 2 | Redis2 |
| 15 | 0 | Redis0 |
然而,一旦加入第 4 个新节点(N变为4),所有数据的分布规则都会重写:
| Key的哈希值 | 模3的余 (旧) | 目标节点 (旧) | 模4的余 (新) | 目标节点 (新) | 是否变化 |
|---|---|---|---|---|---|
| 10 | 1 | Redis1 | 2 | Redis2 | 是 |
| 4 | 1 | Redis1 | 0 | Redis0 | 是 |
| 6 | 0 | Redis0 | 2 | Redis2 | 是 |
| 8 | 2 | Redis2 | 0 | Redis0 | 是 |
| 15 | 0 | Redis0 | 3 | Redis3 | 是 |
可以看到,新增一个节点导致几乎所有 Key 的目标节点都发生了改变。这将引发大规模缓存失效,迫使流量瞬间压垮后端数据库,即典型的“缓存雪崩”现象。为了解决这一问题,通常采用一致性哈希算法。
一致性哈希算法原理
一致性哈希的核心在于:在处理节点不变的情况下,保证相同的请求路由到相同的处理节点;而在节点变动时,尽可能让受影响的请求保持在原地。
基础原理:哈希环映射
该算法将一个长度为 2^32 的空间想象成一个首尾相连的圆环。具体操作步骤如下:
- 将所有物理计算节点(如 Redis 服务器)通过哈希函数映射到这个环上的特定位置。
- 将待路由的 Key 也通过同样的哈希函数映射到环上的位置。
- 从 Key 的位置开始顺时针查找,遇到的第一个节点即为目标处理节点。
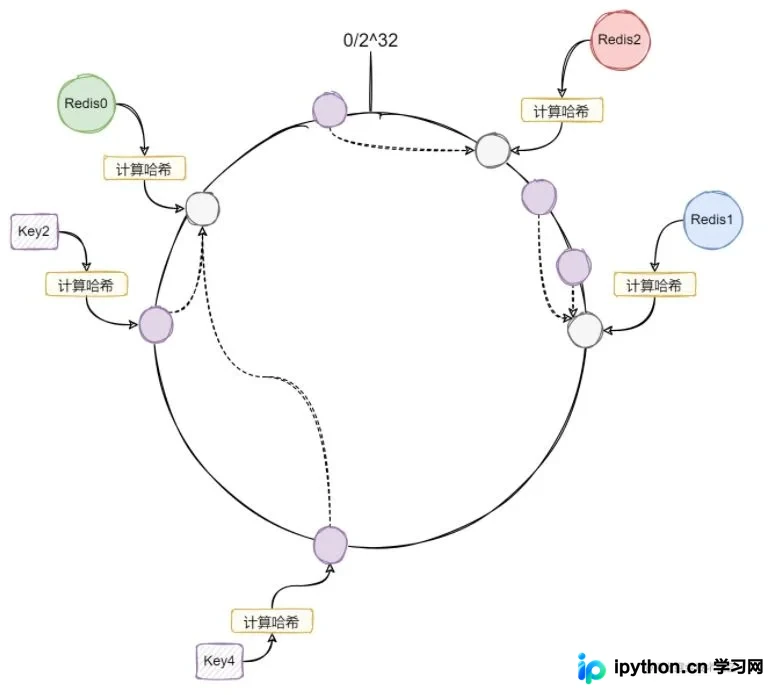
在这种逻辑下,如果仅增加一个新的 Redis3 节点,其插入位置只会截断部分顺时针方向的链路。观察下图可知,仅有极少量的 Key 需要重新分配到其他节点:
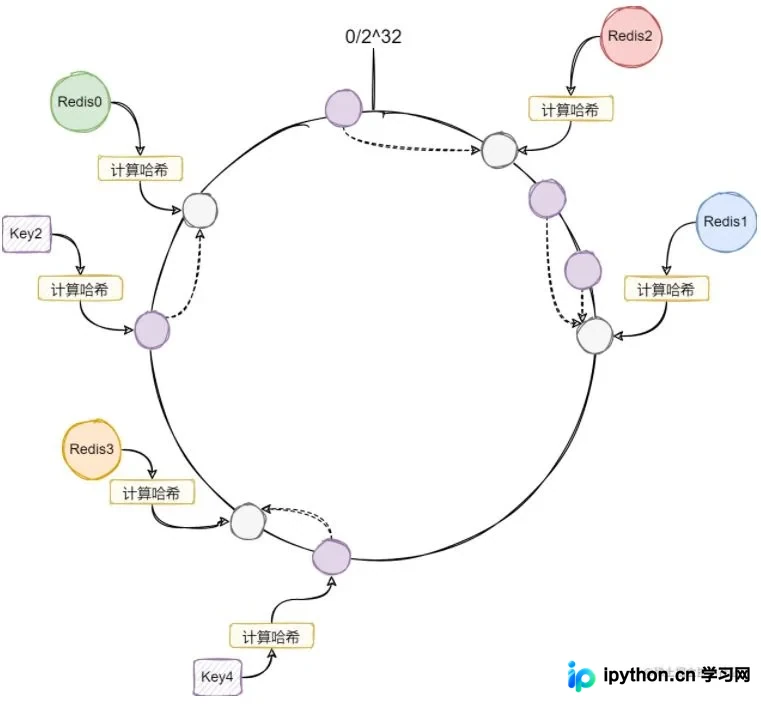
这种特性使得新增或下线节点时的数据迁移量控制在极低水平(理论上最少仅影响约 1/N 的数据),从而避免了大规模缓存失效。
缺陷与改进:引入虚拟节点
在上述理想模型中,由于哈希结果具有随机性,真实节点在环上的分布往往不均匀。这可能导致某些节点承载了绝大部分流量,而少数节点处于空闲状态,造成负载极度不均。
为解决此问题,必须引入虚拟节点(Virtual Nodes)。实际部署时,给每个物理节点生成几十甚至上百个虚拟节点(例如通过命名后缀区分),并将它们独立映射到哈希环的不同位置。这使得节点在环上的覆盖范围更加均匀,有效实现了负载均衡。
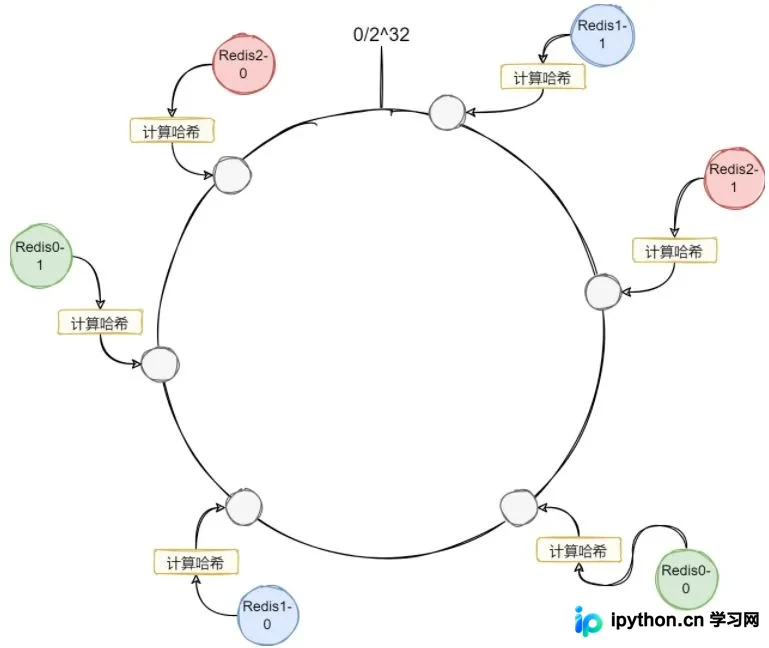
Go语言中的实现方式
Go 官方提供的嵌入式分布式缓存库 groupcache 中包含了一套成熟的一致性哈希实现。在实际开发中,我们通常可以直接引用相关逻辑或在其基础上进行定制。以下代码基于官方思路进行了精简重构,保留了核心的数据结构与操作逻辑。
结构体与接口定义
首先需要明确哈希环的内部结构。默认使用 CRC32 算法计算字节序列的哈希值,同时支持传入自定义哈希函数。结构体中包含用于模拟环形结构的数组以及保存真实节点映射关系的字典:
// Hash 函数签名,用于计算节点或 Key 的哈希值
type Hash func(data []byte) uint32

// 哈希环
// 注意:非线程安全,高并发场景需外部加锁保护
type HashRing struct {
	hash   Hash             // 哈希算法实例
	replicas int            // 每个真实节点的虚拟节点数量
	ring   []int            // 哈希环,按节点哈希值升序排列
	nodes  map[int]string   // key: 虚拟节点哈希值, value: 真实节点字符串
}
添加节点到环
这是初始化或扩容的关键步骤。遍历所有传入的真实节点,根据配置的副本数创建虚拟节点,计算其在环上的哈希值并存入排序好的数组中:
// Add 将新节点添加到哈希环
// 注意:若节点已存在且未先调用 Reset,重复添加会导致环内出现相同节点
func (m *HashRing) Add(nodes ...string) {
	for _, node := range nodes {
		// 为每个真实节点创建 replicas 个虚拟节点
		for i := 0; i < m.replicas; i++ {
			// 结合序号与节点名作为输入,计算哈希值
			hash := int(m.hash([]byte(strconv.Itoa(i) + node)))
			// 记录在环上
			m.ring = append(m.ring, hash)
			// 维护逆映射关系
			m.nodes[hash] = node
		}
	}
	// 执行排序以保证二分查找正确性
	sort.Ints(m.ring)
}
重置节点列表
由于 Add 方法缺乏去重判断,在进行全局配置变更或完全重建哈希环时,推荐使用 Reset 方法先清空内存再重新注入:
// Reset 清空并重置哈希环
func (r *HashRing) Reset(nodes ...string) {
	r.ring = nil
	r.nodes = map[int]string{}
	r.Add(nodes...)
}
路由获取 Key 对应的节点
获取路由的核心逻辑是计算 Key 的哈希值,随后在有序数组中进行二分查找,定位顺时针方向第一个大于等于 Key 哈希值的虚拟节点:
// Get 根据 Key 返回对应处理的真实节点名称
func (r *HashRing) Get(key string) string {
	if r.Empty() {
		return ""
	}

	// 计算 Key 的哈希值
	hash := int(r.hash([]byte(key)))

	// 二分查找:寻找 ring 中第一个值 >= hash 的下标
	idx := sort.Search(len(r.ring), func(i int) bool {
		return r.ring[i] >= hash
	})

	// 边界处理:如果 Key 的哈希值超过了环上最大的节点值
	// 由于是闭合环,应顺时针绕回至索引为 0 的第一个节点
	if idx == len(r.ring) {
		idx = 0
	}

	// 根据找到的虚拟节点哈希值,反查真实节点字符串
	return r.nodes[r.ring[idx]]
}
总结
一致性哈希算法通过空间换时间的思想,有效解决了分布式系统扩容时的数据抖动问题。虽然上述代码省略了部分异常检查和并发控制,但其核心结构清晰展示了哈希环的工作流。在实际生产环境中,建议参考 Go 官方 groupcache 模块的逻辑,并结合具体的业务需求(如动态权重、自动发现等)进行扩展。
完整示例代码地址:https://github.com/jiaxwu/gommon/blob/main/consistenthash/consistenthash.go
以上就是详解Golang一致性哈希算法原理与自定义实现的详细内容,更多关于Golang高级网络编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









