

MySQL InnoDB 间隙锁加锁规则与11个案例分析

本文详解MySQL InnoDB在可重复读(RR)隔离级别下的间隙锁(Gap Lock)与Next-Key Lock加锁机制。通过两个核心原则、两个优化规则和一处潜在逻辑差异,结合多个实际SQL执行场景,分析不同索引类型和操作语句下的锁范围变化,为排查锁等待和死锁问题提供直观参考。
间隙锁的基础概念
间隙锁只在可重复读(Repeatable Read)隔离级别下生效。所谓 Next-Key Lock,本质上是“间隙锁 + 行锁”的组合,其区间为前开后闭,例如 (5, 10] 表示大于 5 且小于等于 10 的范围。
若将隔离级别调整为“读已提交(Read Committed)”,间隙锁会被移除,仅剩行锁。为了补偿这种隔离级别下降可能带来的幻读风险,通常需配合 binlog 格式设置为 row(即 --binlog_format=row)。这种配置组合在保证数据一致性的同时缩小了锁的粒度,能有效减少不必要的阻塞。
Next-Key Lock 的加锁核心逻辑
在理解具体的加锁行为前,先明确三个关键结论:
- 基本单位(原则):加锁的基本单位是 Next-Key Lock,区间为左开右闭。
- 访问才加锁(原则):只有在查找过程中实际访问到的记录或区间才会被加上锁。如果使用了覆盖索引(无需回表),则主键索引上不会施加任何锁。
- 退化规则(优化):
- 等值等唯一索引:如果是唯一索引的等值查询,Next-Key Lock 退化为单纯的行锁。
- 等值普通索引:即使是普通索引,如果等值查询向右遍历时发现下一个记录不满足条件,Rightmost part 会退化为间隙锁。 - 范围扫描特性(注意):唯一索引上的范围查询可能会越过预期的结束点,一直扫描到第一个不满足条件的值为止。
案例一:唯一索引的等值间隙查询
假设查询条件为 id = 7,而表中不存在该记录。
根据原则,加锁起点是前一个存在的记录(id=5),终点是后一个存在的记录(id=10)。正常 Next-Key Lock 应为 (5, 10]。
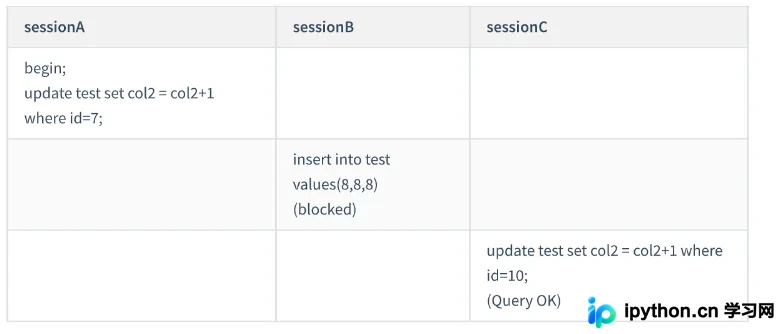
但由于这是等值查询,且 id=10 不满足条件,根据退化规则,Next-Key Lock 退化为间隙锁。最终加锁范围为:(5, 10)。
案例二:普通索引的等值查询
针对普通索引字段 col1 = 5 执行查询。
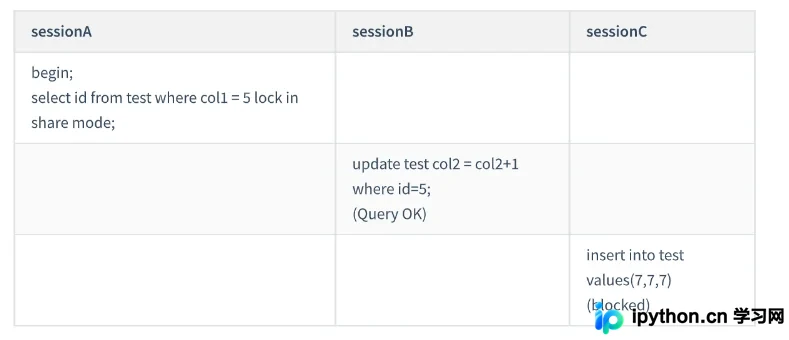
由于普通索引可能存在重复值,InnoDB 必须继续向右遍历直到确认没有更多匹配值。它会遍历到 col1=10 这一行并停止。根据退化规则,因为 col1=10 不是目标值,区间 (5, 10] 同样退化为间隙锁 (5, 10)。
此外,由于该查询仅依赖覆盖索引就能完成(未访问主键列),主键索引上不会加锁。因此其他会话对主键记录的更新不会受到干扰。
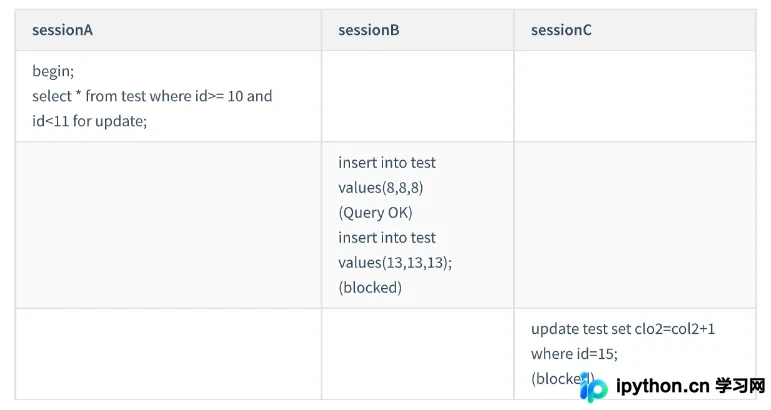
案例三:主键索引的范围查询锁
当在主键上进行范围查询(如 WHERE id >= 10 AND id < 15)时,初始定位 id=10 的行视为等值查询,因此该位置只加行锁。
随后继续向右扫描,直到找到不满足条件的 id=15 停下。此时,从上一个记录到当前停下的记录之间的区间 (10, 15] 会加上完整的 Next-Key Lock。这导致 id=10 的行锁加上后续的间隙锁共同构成了封锁区域。
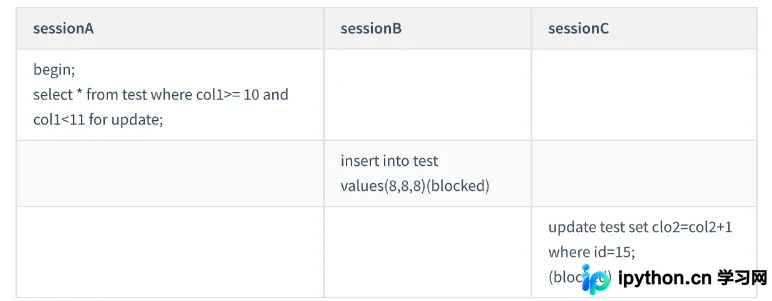
案例四:普通索引的范围查询
在非唯一索引上做范围查询(如 col1),情况有所不同。在定位起始记录 col1=10 后,因为没有唯一性保证,它无法直接断定扫描结束点,需要继续扫描至 col1=15。
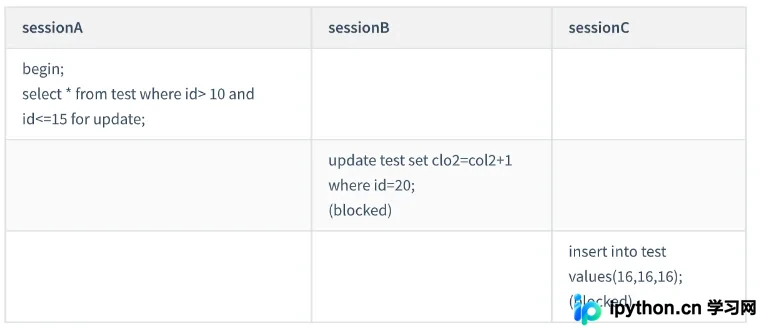
在此过程中,所有经过的区间 (5, 10] 和 (10, 15] 都会加上 Next-Key Lock。这意味着它不仅锁住了找到的行,还锁定了它们之后的下一个区间,以阻止其他事务插入中间数据。
案例五:唯一索引范围查询的特殊扫描逻辑
在进行唯一索引的范围查询时(如 WHERE id > 10),虽然预期锁定到 id=15 即可停止,但在某些引擎内部实现中,为了保证边界安全,会继续向后多扫描一行直到遇到真正的边界值(例如到 id=20 停下),并锁住中间的区间 (15, 20]。这是一种为了防范极端情况的保守设计。
案例六:存在并列值的非唯一索引 DELETE
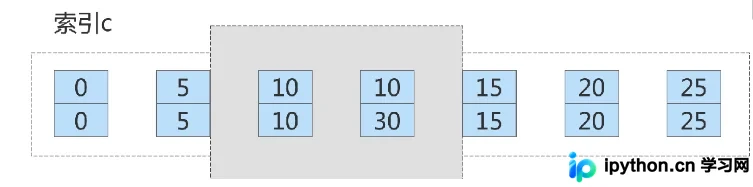
当普通索引中存在多条相同值得记录(如两条 col1=10)并执行 DELETE 时,加锁行为类似于 SELECT ... FOR UPDATE。
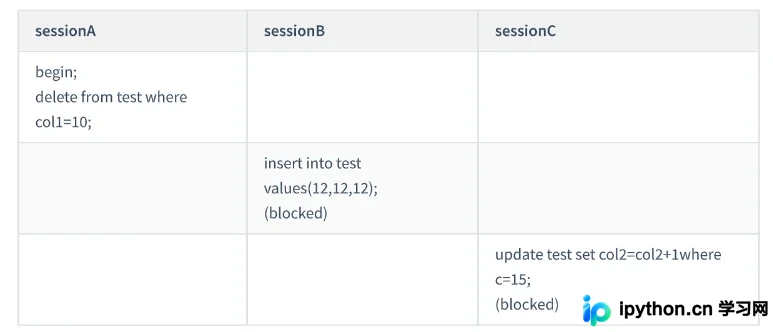
它会从上一行(如 col1=5)开始锁定区间,跨越所有的匹配记录,一直到下一个不同的值(如 col1=15)为止。最终形成一段连续的 Gap Lock,覆盖了这段范围内的所有空隙。
案例七:LIMIT 对加锁范围的影响
这是一个非常实用的实践技巧。如果查询带上了明确的 LIMIT 2 约束:
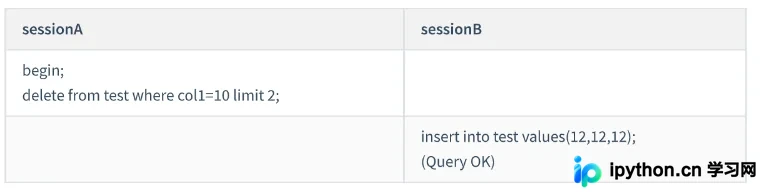
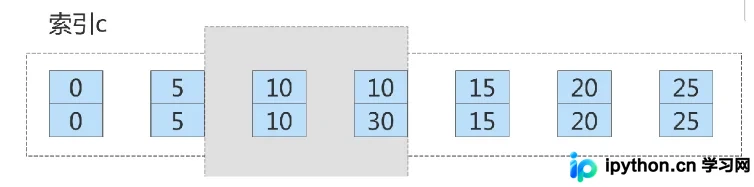
InnoDB 在取够了 2 条记录后会立刻终止扫描并释放资源(或者说不再继续向右寻找下一个记录来构造间隙锁)。因此,带上 LIMIT 不仅可以精确控制影响行数,还能显著缩小产生的间隙锁范围,降低死锁概率。
案例八:典型的死锁场景复现
观察以下交互过程:
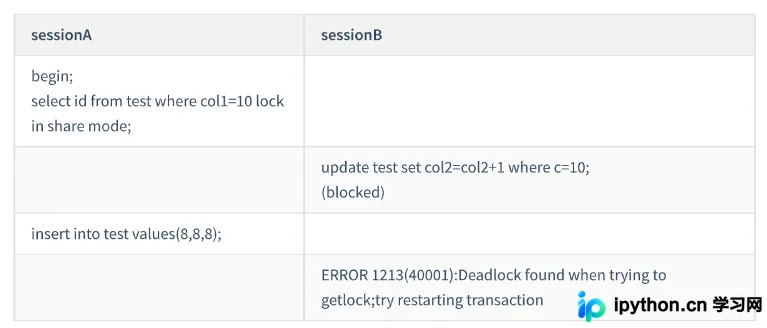
Session A 开启共享锁读取 col1=10 附近的区间;Session B 尝试更新同一区间的另一行。Session A 此时试图插入新的间隙记录,触发了两个会话互相等待对方持有的锁,最终由 InnoDB 的死锁检测机制判定其中一个回滚。
案例九:带有 ORDER BY 降序排列的间隙锁
当查询语句包含 ORDER BY col DESC 时,扫描方向是从大到小。
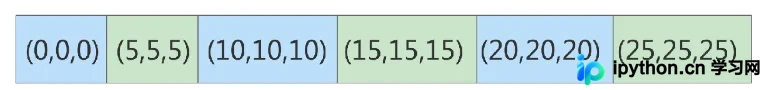
引擎首先会在索引树中找到比上限(如 <12)大的最小索引值 id=12(实际上没找到,停在 10, 15 之间),然后向左反向扫描。因为是反向遍历,最后停留在小于下限(如 >9)的最大值 id=10,并锁定其下方的相邻区间 (0, 5]。
案例十:排序涉及覆盖索引的情况
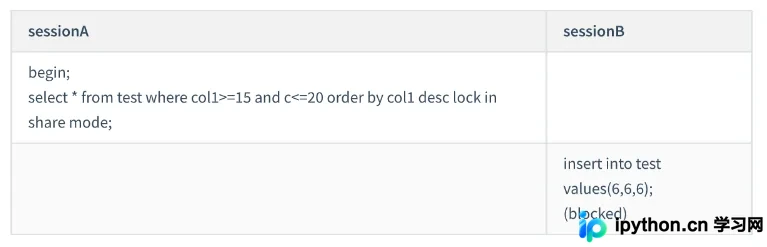
在按 col1 降序排序查询时,如果使用的是覆盖索引,主键索引依然不会被加锁,但辅助索引上的大范围间隙和 Next-Key Lock 会照常生效,依然能够有效拦截并发的插入操作。
案例十一:UPDATE 修改数据引发的连锁锁
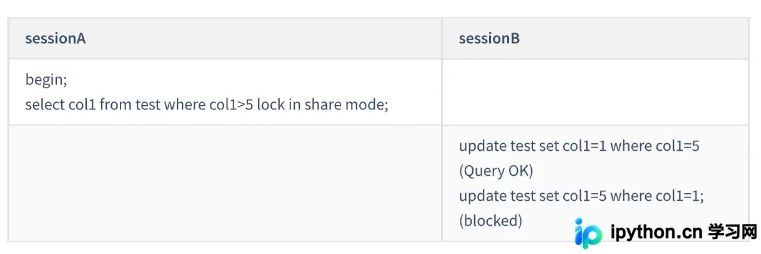
如果一条 UPDATE 语句改变了用于判断索引的列的值(例如将 col1=5 改为 1),这就相当于一次“删除旧值行 + 插入新值行”的操作。
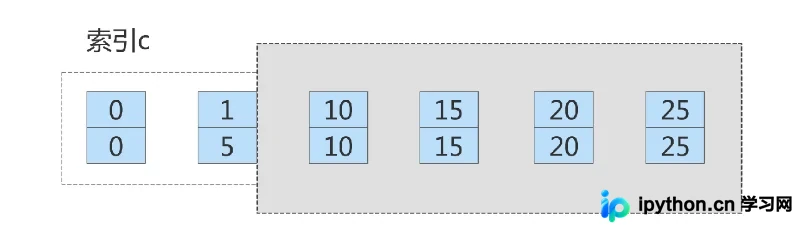
此时,后续试图在同一被锁定的间隙内插入新记录的并发事务就会陷入永久等待。因此,尽量避免在频繁被并发写入的范围内修改作为搜索条件的索引字段。
以上就是 MySQL 间隙锁加锁规则的详细内容,更多关于 MySQL InnoDB 锁机制避坑的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









