

Go语言rune类型详解:解决中文字符索引与截取乱码问题

发布时间:2026-10-15| 7人浏览过
在Go语言开发中,处理包含中文等多字节字符的字符串时,直接对字符串进行切片(Slice)操作常导致乱码。这是因为中文字符在UTF-8编码下占用多个字节,而默认遍历以字节为单位。本文将深入讲解rune类型(int32别名)的原理,并通过代码演示如何使用它正确获取和截取中文字符,确保程序输出的准确性。
rune与byte的核心区别
要理解rune的作用,首先需要明确它与byte在内存表示上的差异:
- byte类型:是
uint8的别名,仅占用1个字节,适合存储ASCII字符或单字节数据。 - rune类型:是
int32的别名,占用4个字节。它是Go语言中专门用于表示Unicode字符(Rune)的类型,能够兼容所有语言的字符,特别是中文字符。
当字符串中包含中文字符时,如果使用byte类型去统计长度或截取前N个字符,往往截断的是汉字的一部分字节,从而产生不可读的乱码。
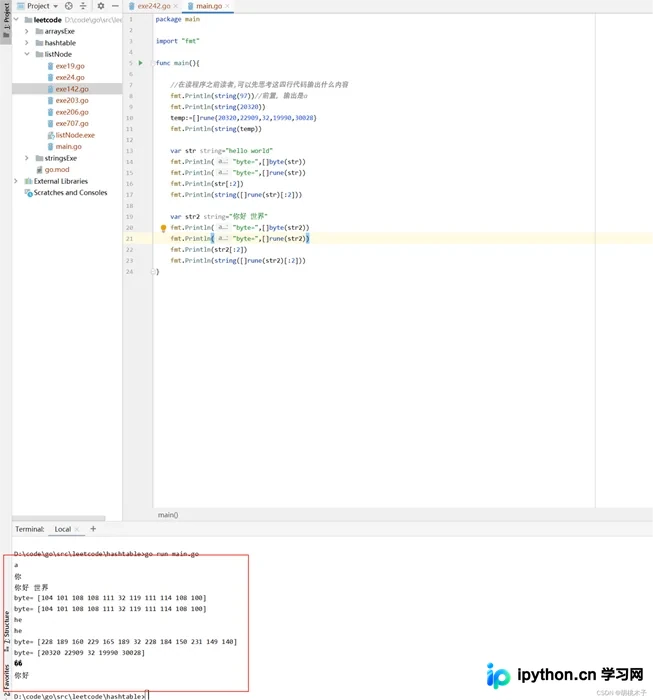
代码实操:中英文截取对比
通过以下实例代码,我们可以直观地看到[]byte和[]rune在处理英文与中文时的不同表现。建议读者先思考输出结果,再查看代码运行后的分析。
import "fmt"

func main(){
	// --- 基础转换演示 ---
	fmt.Println(string(97))      // 前置知识:ASCII码97对应字符'a'
	fmt.Println(string(20320))   // 汉字"中"的Unicode码点

	temp:=[]rune{20320,22909,32,19990,30028}
	fmt.Println(string(temp))    // 将rune切片转为字符串

	// --- 英文字符串处理 ---
	var str string="hello world"
	fmt.Println("英文byte=",[]byte(str))
	fmt.Println("英文rune=",[]rune(str))
	fmt.Println("直接截取前2字节:",str[:2])
	fmt.Println("按rune截取前2字符:",string([]rune(str)[:2]))

	// --- 中文字符串处理 ---
	var str2 string="你好 世界"
	fmt.Println("中文byte=",[]byte(str2))
	fmt.Println("中文rune=",[]rune(str2))
	fmt.Println("直接截取前2字节:",str2[:2]) // 极大概率乱码
	fmt.Println("按rune截取前2字符:",string([]rune(str2)[:2]))
}
结果分析与关键结论
- 英文环境一致:对于纯英文字符串,由于ASCII字符只占1个字节,因此使用
[]byte和[]rune转换后,其长度、索引位置和取值结果是相同的。 - 中文环境差异巨大:
[]byte操作:中文通常占用3个字节。如果直接截取前2个字节(如str2[:2]),会切断汉字的编码结构,输出结果为乱码(如??)。[]rune操作:[]rune会将字符串按Unicode字符转换为整型切片。此时每个汉字被视为一个独立的元素。使用string([]rune(str2)[:2])可以精准取出前两个完整的汉字,无需担心编码截断问题。
最佳实践建议
在进行字符串索引(Index)、切片(Slice)或长度计算(Len)之前,务必确认内容是否包含多字节字符。若有中文或其他非ASCII字符,优先使用[]rune()进行预处理转换,虽然会带来微小的性能开销,但能彻底杜绝乱码错误。
以上就是Go语言中rune类型解决中文截取乱码问题的详细内容,更多关于Go语言rune使用方法的技术资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









