

MySQL索引原理与慢SQL优化实战:从B+树到执行计划分析

在应用系统中,复杂的查询操作往往是性能瓶颈所在。本文从开发工程师视角出发,详解MySQL索引底层原理,包括B+树结构如何降低磁盘IO次数,并总结建立高效索引的五大核心原则。同时,提供标准化的慢查询排查流程,并通过两个典型实战案例,演示如何利用Explain工具、SQL重写策略及对业务场景的理解,彻底解决慢SQL问题。
MySQL索引原理
一般应用中读写比例约为10:1,插入和更新较少出现性能问题,而复杂的查询操作最容易引发延迟。因此,理解索引原理并优化查询语句是提升系统性能的关键。
第1步:理解索引的核心目的
索引的本质是提高查询效率。类比字典查词:若无索引,需遍历所有单词;有了索引,可通过首字母定位章节,大幅缩小搜索范围。数据库中的等值查询、范围查询(>、<、between)、模糊查询(like)及并集查询(or),均需通过特定数据结构将“随机查找”转化为“顺序扫描”,从而锁定目标数据。
第2步:掌握磁盘IO与预读机制
数据库数据存于磁盘,访问磁盘的成本远高于内存(约十万倍)。一次磁盘IO包含寻道时间、旋转延迟和传输时间,通常耗时数毫秒。然而,CPU每秒可执行数亿条指令,IO时间成为巨大瓶颈。
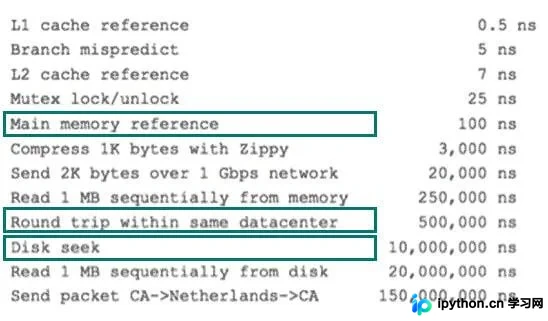
为解决此问题,操作系统采用“页(Page)”读取策略。当访问某一地址时,会将相邻数据一并加载至内存缓冲区(通常4KB或8KB)。这一局部预读原理直接决定了索引数据结构的设计:节点应尽量容纳更多键值,以单次IO获取更多索引信息。
第3步:剖析B+树数据结构
B+树是MySQL InnoDB引擎默认的索引结构,其设计目标是将磁盘IO次数控制在极小数量级(常数级)。
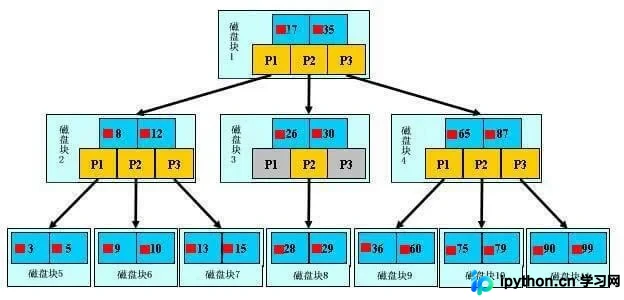
- 结构特点:非叶子节点仅存储指引方向的键值,不存真实数据;所有真实数据均存储在叶子节点,且叶子节点间通过指针连接,形成有序链表。
- 查找过程:以查找数据项29为例,先加载磁盘块1至内存(第1次IO),二分查找确定方向;再加载磁盘块3(第2次IO);最后加载磁盘块8(第3次IO)并找到数据。对于百万级数据,仅需3次IO即可完成查询,而无索引则需百万次IO。
- 关键性质:
- 树高最低化:IO次数取决于树高度 h = log(m+1)N。m为单节点数据项数量,取决于键值大小。因此索引字段应尽可能小(如int优于bigint),且真实数据放叶子节点,防止内层节点膨胀导致树高增加。
- 最左匹配特性:对于复合索引 (name, age, sex),查询必须从左侧开始。若缺少name,则无法利用该索引进行精准定位,只能扫描name相同的记录后再过滤age/sex。
建立索引的5大原则
第1步:遵循最左前缀匹配原则
MySQL会从左向右连续匹配,遇到范围查询(>、<、like等)即停止。例如索引(a,b,c,d),若查询条件为 a=1 and b=2 and c>3 and d=4,d字段将无法利用索引。若改为 (a,b,d,c) 索引,则所有条件均可命中。注意:范围查询后的字段即使存在索引也无法使用。
第2步:等值查询列序可乱序
若条件均为等值匹配(如 a=1 and b=2 and c=3),建立(a,b,c)索引后,MySQL优化器会自动重排列顺序以适配查询,无需严格对应书写顺序。
第3步:选择高区分度的列
区分度公式为 count(distinct col)/count(*)。值越分散,过滤效果越好。唯一键区分度为1,状态类字段可能接近0。作为Join关联字段或高频查询条件,区分度建议至少在0.1以上。
第4步:保持索引列“干净”,避免计算
不要在索引列上进行函数运算或类型转换。例如 from_unixtime(create_time) = '...' 会导致全表扫描,因为B+树中存储的是原始值而非函数结果。正确写法应将函数移至等号右侧:create_time = unix_timestamp('...')。
第5步:优先扩展已有索引
新建索引成本较高。若表中已有(a)索引,新增(a,b)联合索引时,可直接复用原索引结构,无需新建。修改现有索引通常比新建更经济且对事务影响更小。
慢查询优化基本步骤
- 复现问题:使用 SQL_NO_CACHE 禁用缓存,确认SQL实际执行时间。
- 单表定位:针对多表查询,估算各表返回行数,优先从数据量最小、区分度最高的表开始分析Where条件。
- 查看执行计划:使用
EXPLAIN命令,重点关注type、key和rows字段。 - 排序优化:若涉及 Order By Limit,确保排序字段有索引支持,减少文件排序(Using filesort)。
- 结合业务场景:了解数据分布规律和查询频率,有时违背常规区分度理论反而能解决问题。
- 实施优化:根据上述原则调整SQL写法或索引结构。
- 回归验证:再次运行测试,对比执行时间和逻辑结果一致性。
慢查询优化案例实战
案例一:复杂语句拆解与重写
背景:一条涉及子查询和多表Join的SQL,执行耗时1.87秒。
分析:
EXPLAIN显示,主表cm_log通过索引扫描出379条记录,但子查询derived2全表扫描了6万余条记录并构建虚拟表,最终因大量无用数据Join导致性能低下。
优化方案:原SQL使用了OR条件关联不同表逻辑。将其拆分为两个独立的SELECT语句,通过UNION合并(原语句含DISTINCT去重需求,故用UNION而非UNION ALL)。拆分后,每个分支都能精准匹配对应的表ID,避免笛卡尔积和无用扫描。
-- 优化后:拆分为两部分联合查询
select emp.id from cm_log cl inner join employee emp on cl.ref_table = 'Employee' and cl.ref_oid = emp.id where cl.last_upd_date >='2013-11-07 15:03:00' and cl.last_upd_date<='2013-11-08 16:00:00' and emp.is_deleted = 0
union
select emp.id from cm_log cl inner join emp_certificate ec on cl.ref_table = 'EmpCertificate' and cl.ref_oid = ec.id inner join employee emp on emp.id = ec.emp_id where cl.last_upd_date >='2013-11-07 15:03:00' and cl.last_upd_date<='2013-11-08 16:00:00' and emp.is_deleted = 0
结果:执行时间降至0.01秒,性能提升近200倍,执行计划显示Rows显著降低。
案例二:低区分度字段与业务场景的结合
背景:查询stage_poi表,WHERE条件为 accurate_result=1 AND sync_status IN (0,2,4)。初始执行耗时6.22秒,EXPLAIN显示rows高达361万,type为ALL(全表扫描)。
分析:
- accurate_result仅有-1,0,1三个值,sync_status分布也不均匀,区分度极低。按常规理论加索引无效甚至有害。
- 经与业务方沟通发现,该任务每5分钟执行一次,处理完将status置为1。这意味着大部分数据处于非目标状态,真正需要处理的“脏数据”只有约1000条。
优化方案:基于“数据不平衡”的业务事实,建立复合索引 idx_acc_status(accurate_result, sync_status)。
alter table stage_poi add index idx_acc_status(accurate_result,sync_status);
结果:配合业务数据的实际分布,索引能过滤掉海量非目标数据,执行时间缩短至0.20秒,速度提升30倍以上。
慢SQL优化没有万能药,关键在于理解数据库底层的B+树机制,善用Explain工具透视执行细节,并结合具体的业务数据特征进行针对性重构。以上就是MySQL数据库的索引原理与慢SQL优化的5大原则的详细内容,更多关于MySQL数据库的索引原理与慢SQL优化原则的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









