

MySQL删除重复数据并保留唯一值的方法与实例

当数据库表中出现冗余数据时,如何在不影响业务逻辑的前提下,精准删除重复项并保留唯一标识(如最小ID)的记录?本文将通过实例演示从识别重复数据到执行安全删除的完整流程,解决 MySQL 删除子查询报错的关键难题。
结果与目标
在处理业务数据或日志记录时,经常会遇到因系统异常或用户重复操作导致的重复数据问题。我们的目标是:依据特定字段(如 name)的值来判定重复,保留每组中 ID 最小的那条原始记录,并安全地删除其余冗余数据。
准备条件与测试环境
为了验证删除逻辑的安全性,首先建立一个简单的测试表 test,包含主键 id 和用于判重的 name 字段:
CREATE TABLE `test` (
  `id` varchar(32) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT '注解id',
  `name` varchar(255) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL COMMENT '名字',
  PRIMARY KEY (`id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Compact;

INSERT INTO test (id,name) VALUES (replace(uuid(),'-',''),'张三'),(replace(uuid(),'-',''),'张三');
真实操作顺序
第1步:确认数据现状
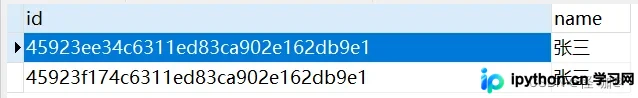
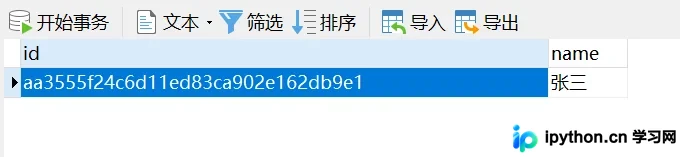
插入两条名称相同但 ID 不同的测试数据后,当前表状态如下:
第2步:识别重复的数据分组
在实际开发中,有时单一字段不足以判断重复,可利用 GROUP BY 配合 HAVING 子句筛选出计数大于 1 的数据组。若存在多个判定字段,同样适用此逻辑:
SELECT name FROM test GROUP BY `name` HAVING count( name ) > 1
第3步:获取每个重复组中的最小 ID
为了决定“留谁删谁”,我们需要找到每一组重复数据中 ID 最小的那一条作为基准:
SELECT min(id) as id FROM test GROUP BY `name` HAVING count( name ) > 1
第4步:构建待删除数据的查询逻辑
需要删除的数据特征为:属于重复组且不在保留名单(最小ID列表)中。基础查询逻辑如下:
SELECT * FROM test
WHERE name IN ( SELECT name FROM test GROUP BY `name` HAVING count( name ) > 1 )
AND id NOT IN (SELECT min( id ) FROM test GROUP BY `name` HAVING count( NAME ) > 1)
第5步:排查删除执行的致命错误
很多人会尝试直接将上述查询改写为 DELETE 语句,但这在 MySQL 中通常会直接报错。例如执行 update A表 set A列 = (select B列 from A表) 这类同层级交叉修改读取的操作会导致语法级别冲突:
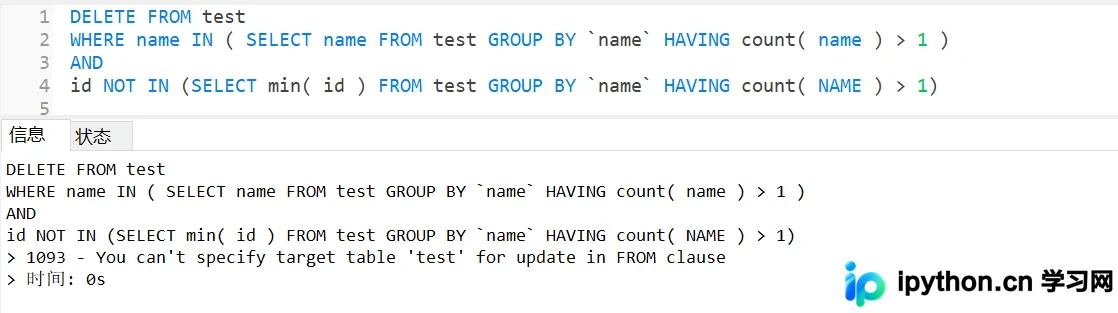
原因分析: MySQL 不允许在同一语句中既修改一张表,又同时在该表的子查询里读取该表。必须通过额外嵌套一层括号,使其生成虚拟临时表,从而切断读写冲突。
第6步:应用正确的删除写法
为了避免风险,执行前务必先使用 SELECT 预览结果。以下是两种安全的删除实现方式:
方式一:嵌套子查询法(直观清晰)
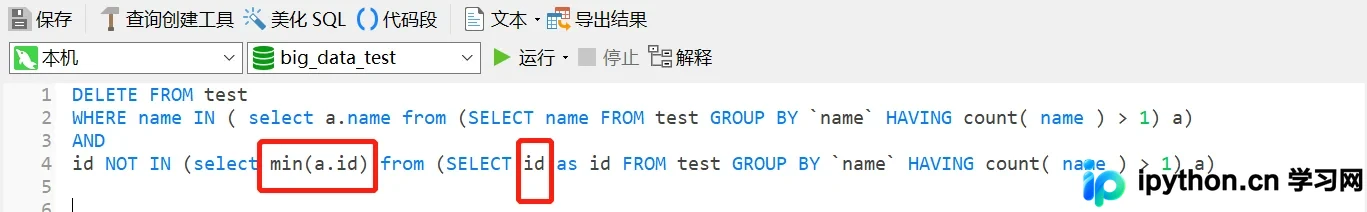
DELETE FROM test
WHERE name IN ( select a.name from (SELECT name FROM test GROUP BY `name` HAVING count( name ) > 1) a)
AND id NOT IN (select a.id from (SELECT min(id) as id FROM test GROUP BY `name` HAVING count( name ) > 1) a)
方式二:更简洁的子查询提取法
DELETE FROM test
WHERE id NOT IN (
	SELECT t.id FROM ( SELECT MIN(id) as id FROM test GROUP BY NAME ) t)
重要提醒: 在运行任何删除命令前,请务必备份当前数据或再次执行对应的 SELECT 查询确认无误。数据操作不可逆,谨慎为上!
原文有依据的排错
有一种极其危险且常见的写法会导致灾难性后果。某些人试图在外层包裹时取单条记录配合 NOT IN,这种写法极易破坏逻辑,导致整个表数据被清空。下面展示了错误操作的模拟过程及严重后果:
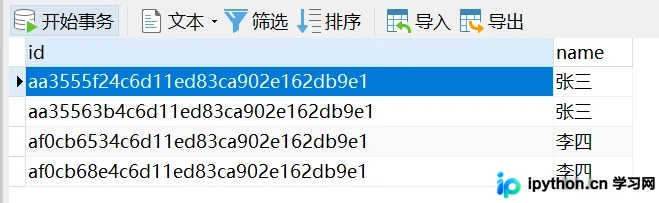
执行前表内共有四条数据,意图是每条重复组只留一条:
如果使用了错误的非嵌套或多表关联不当的写法,最终的执行结果可能是误删所有数据:
简要总结
以上就是在 MySQL 中安全删除重复数据并保留唯一记录的详细内容。掌握正确的子查询嵌套技巧与备份习惯,能有效避免生产环境的数据丢失事故。更多关于 MySQL 性能调优与复杂查询优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









