

C语言冒泡排序原理与实现细节

冒泡排序是一种基础的交换排序算法,其核心思想是通过重复走访待排序的数列,依次比较相邻两个元素的大小,若顺序错误则进行交换。经过 n-1 趟比较,最大的元素会像气泡一样逐渐“浮”到数列的顶端。本文将深入剖析 C 语言中冒泡排序的实现逻辑,包括双重循环的控制条件以及利用标志位优化算法性能的关键技巧。
冒泡排序的基本原理
冒泡排序(Bubble Sort)的工作流程非常直观。它从数列的第一个元素开始,依次比较相邻的两个元素。如果前一个元素大于后一个元素(针对升序排列),则交换它们的位置。接着移动到下一对相邻元素,继续进行比较和可能的交换。

这种比较过程会一直持续到数列的末尾。经过第一轮的完整遍历,数列中最大的元素会被交换到最后一个位置。随后的每一轮都会将剩余未排序部分中的最大值放到正确的位置。这个过程就像水中的气泡,较大的数值逐渐向数列末尾移动。
以一组无序数组 {2, 9, 1, 3, 7, 6} 为例,目标是将它们按从小到大的顺序排列。在第一趟排序中,通过不断的两两比较与交换,最大值 9 最终会被移动到数组的最末端。对于长度为 N 的数组,总共需要进行 N-1 趟这样的排序操作,才能让所有元素归位。
循环结构与比较次数分析
要实现冒泡排序,需要理解外层循环和内层循环各自的职责。这涉及两个关键变量:一个用于控制排序进行的趟数,另一个用于控制每一趟中进行比较的次数。
第1步:确定外层循环控制趟数
如果有 N 个元素,我们需要进行 N-1 趟排序。每一趟结束后,都有一个确定的最大元素被安置在最终位置,不再参与后续的比较。因此,外层循环通常控制着“还剩下多少个元素需要处理”或“已经完成了多少趟”。例如,可以让变量 p 从 N-1 递减至 1,表示当前未排序部分的范围。
第2步:确定内层循环的比较边界
在每一趟内部,我们需要遍历当前未排序的部分。假设当前未排序部分的长度对应的是索引范围 [0, p],那么我们需要比较相邻元素。A[i-1] 与 A[i] 进行比较,其中 i 从 1 遍历到 p。
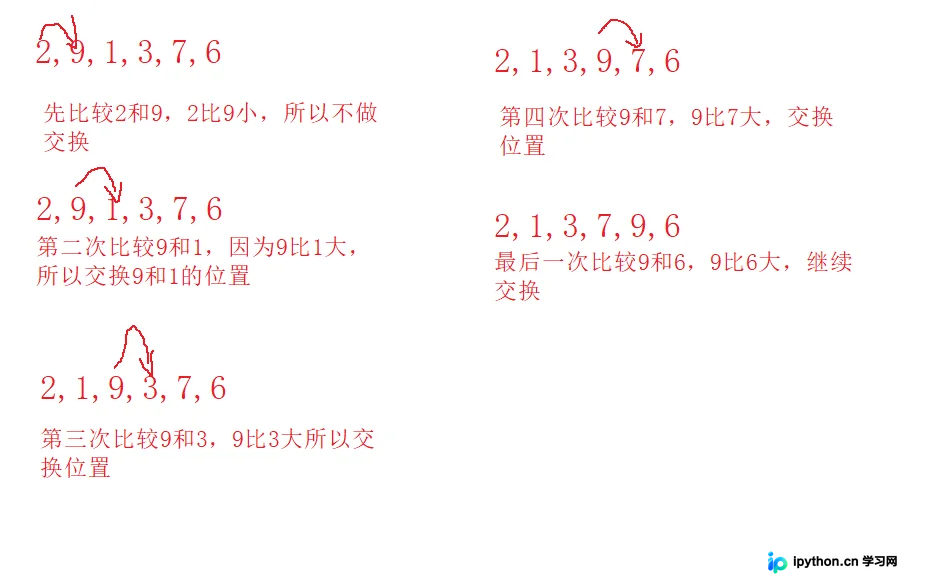
这里有一个重要的优化点:当某一趟排序完成后,原本位于末尾的最大值已经被放置妥当。下一趟排序时,我们不需要再对这个已经归位的最大值进行比较。因此,内层循环的范围会随着外层循环的进行而逐渐缩小。
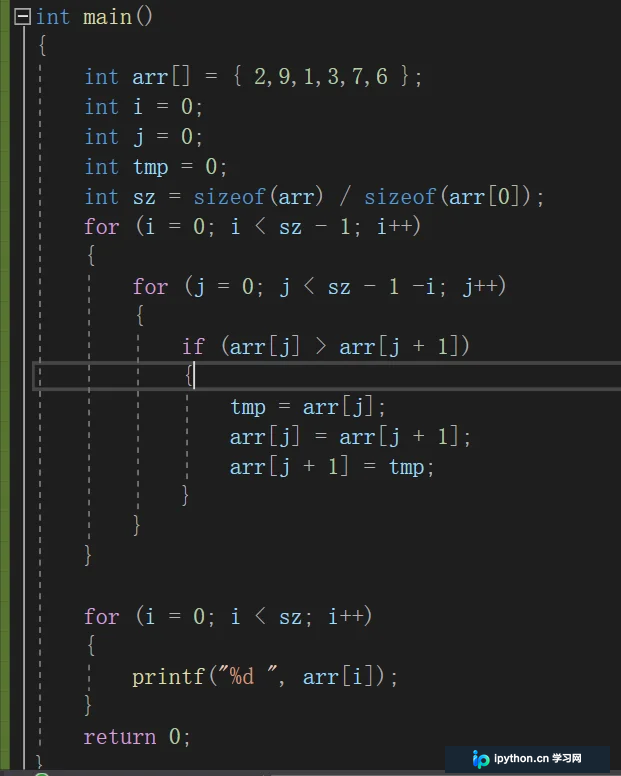
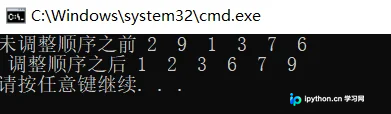
在编写代码时,必须清晰区分 i 和 j(或其他命名)所代表的物理意义:i 通常指向正在参与比较的后一个元素,而前一个元素则是 i-1。只有明确了排序次数(外层)与比较次数(内层)的关系,才能写出正确的边界条件。
带优化的冒泡排序实现
标准的冒泡排序无论数据是否已经有序,都会执行完整的 N-1 趟比较。然而,如果在某趟排序过程中没有任何元素发生交换,说明整个数组已经有序,此时可以提前终止循环,从而节省计算资源。
第1步:引入标志位 Flag
为了检测是否有元素交换,我们可以定义一个整型变量 flag。在每一趟开始之前,将 flag 初始化为 0。这代表假设当前这一趟没有发生任何交换。
第2步:执行比较与交换并更新 Flag
在内层循环中,如果发现 A[i-1] > A[i],则执行交换操作,并将 flag 设置为 1。这表明数组尚未完全有序,至少有一对相邻元素顺序错误,需要继续后续的排序过程。
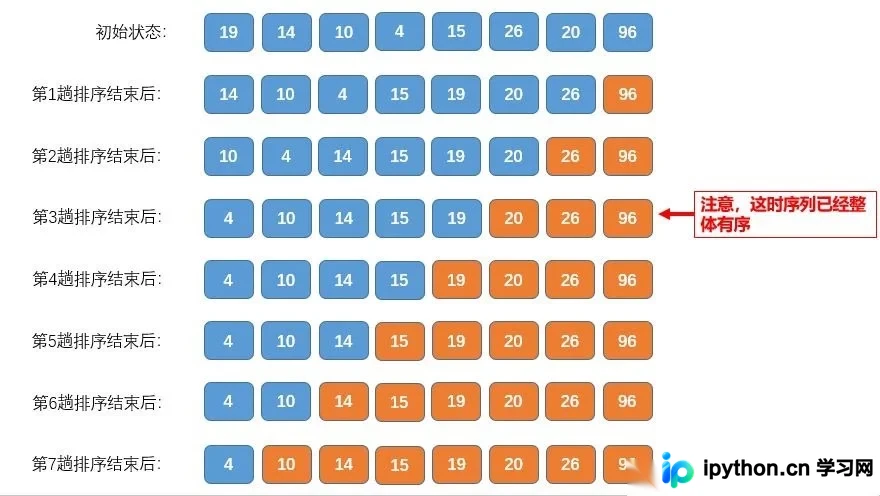
上图展示了优化后的执行逻辑:当冒泡进行到第四趟时,如果没有发生任何交换,标志位将保持为 0。程序检测到这一点后,立即跳出循环,避免了不必要的后续比较。
C语言代码实现
以下提供了两种常见的循环写法,它们都包含了基于 flag 的优化机制。第一种写法通过变量 p 从大到小递减来界定范围;第二种写法更常见于教材,通过 N-i-1 动态计算内层边界。
// 第一种循环方法:使用 p 从 N-1 递减
void BubbleSort(ElementType A[], int N) {
    for (int p = N - 1; p > 0; p--) {
        int flag = 0; // 初始化标志位
        for (int i = 1; i <= p; i++) {
            if (A[i - 1] > A[i]) { // 如果前面元素大于后面元素,则交换
                int temp = A[i - 1];
                A[i - 1] = A[i];
                A[i] = temp;
                flag = 1; // 标记发生了交换
            }
        }
        if (flag == 0) { // 如果本轮没有发生交换,说明数组已有序
            break; // 提前结束排序
        }
    }
}

// 第二种循环方法:使用 i 从 0 递增
void BubbleSort(ElementType A[], int N) {
    for (int i = 0; i < N; i++) {
        int flag = 0;
        // 每次比较的范围随着已排序元素增加而减少
        for (int j = 0; j < N - i - 1; j++) {
            if (A[j] > A[j + 1]) { // 注意这里是 j 和 j+1 的比较
                int temp = A[j];
                A[j] = A[j + 1];
                A[j + 1] = temp;
                flag = 1;
            }
        }
        if (flag == 0) {
            break; // 无交换,提前终止
        }
    }
}
需要注意的是,在第二种写法中,内层循环变量通常命名为 j,比较的是 A[j] 和 A[j+1],这与第一种写法中 A[i-1] 和 A[i] 的逻辑是等价的,只是索引偏移不同。无论采用哪种写法,核心都在于通过 flag 判断数组状态,并在最佳情况下将时间复杂度从 O(N²) 降低到接近 O(N)(当数组已经有序时)。
总结
冒泡排序虽然效率不如快速排序或归并排序高,但其逻辑简单易懂,是学习数据结构与算法的重要入门案例。掌握其双层循环的结构设计、边界条件的确定以及基于标志位的性能优化,对于理解更复杂的排序算法大有裨益。在实际应用中,如果数据量较小或数据基本有序,冒泡排序仍是一个可行的选择。 以上就是C语言冒泡排序原理与实现细节的详细内容,更多关于C语言基础编程与算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









