

详解MySQL单列索引和联合索引:最左前缀与失效场景

本文解析MySQL单列索引与联合索引的区别,重点讲解最左前缀原则及索引失效场景,对比B+Tree与Hash索引特性,帮助优化数据库查询效率。
索引基础与最左前缀原则
在MySQL数据库中,索引用于加速数据检索。利用索引中的附加列可以缩小搜索范围,但联合索引的使用逻辑不同于多个独立索引的组合。可以将联合索引的结构类比为电话簿:它首先按“姓”排序,同姓的人再按“名”排序。因此,提供“姓”即可快速定位,提供“姓”和“名”更精准,但若仅提供“名”而缺失“姓”,则无法有效利用索引。
创建联合索引时,必须严格考虑列的顺序。最左前缀原则是联合索引的核心规则:
- 定义:以最左边的列为起点,任何连续的左侧索引序列都能被匹配使用。
- 应用:在对联合索引的所有列或仅对前几列执行搜索时,效果显著;若仅对后续列搜索,索引通常失效。
- 排序策略:应将被查询中最频繁使用的列放在最左边。例如,若经常根据username查询,而age较少涉及,则索引结构应为(name, age),以保证扩展性和筛选力度。
第1步:理解联合索引的本质构建
当创建一个复合索引 (k1, k2, k3) 时,MySQL底层实际上创建了三个索引:(k1)、(k1, k2) 和 (k1, k2, k3)。这意味着只要查询条件包含了最左边的列,就可以利用该部分的索引能力。
第2步:验证最左前缀匹配的SQL示例
以下操作演示了如何创建索引以及不同查询条件下的命中情况:
1. 创建复合索引
目标:建立包含name和salary的联合索引。
ALTER TABLE employee ADD INDEX idx_name_salary (name,salary);2. 匹配部分前缀(仅第一列)
目的:验证仅使用索引第一列是否生效。
SELECT * FROM employee WHERE NAME='哪吒编程';结果:索引生效。因为符合最左前缀。
3. 跳过首列(索引失效)
目的:验证未从最左列开始查询时的行为。
SELECT * FROM employee WHERE salary=5000;结果:索引失效。因为缺少最左边的name列,无法利用联合索引。
4. 完整匹配(多列顺序)
目的:验证所有列均参与且顺序一致的情况。
SELECT * FROM employee WHERE NAME='哪吒编程' AND salary=5000;结果:索引完全生效。
5. 逆序查询(MySQL优化器处理)
目的:验证条件顺序颠倒时的表现。
SELECT * FROM employee WHERE salary=5000 AND NAME='哪吒编程';结果:虽然书写顺序违背最左原则,但MySQL执行计划会进行内部优化(重排SQL顺序),最终仍能正确利用索引。
联合索引与单列索引的选择
在多条件查询场景中,如果存在多个单列索引,优化器通常会选择一个最优的单列索引,或者尝试合并索引(Index Merge),但这往往不如单一联合索引高效。多个单列索引意味着底层需要维护多个B+树,占用更多磁盘空间,且在更新数据时需要维护多处索引结构,降低写入性能。
最佳实践:对于多条件联合查询,优先建立联合索引而非多个单列索引。
索引失效的常见场景
即使建立了正确的索引,以下操作可能导致索引失效,引发全表扫描:
1. 模糊查询的通配符位置
LIKE 子查询中,如果通配符 % 出现在字符串开头,索引将失效。因为它破坏了最左前缀的固定前缀匹配逻辑。
失效示例:
SELECT * FROM user WHERE name LIKE '%jack';生效示例:
SELECT * FROM user WHERE name LIKE 'jack%';2. OR 条件的使用限制
当 OR 语句前后的字段只有一个是索引时,整体索引失效。只有当 OR 两侧的字段都具有索引时,才可能生效。为避免复杂判断,建议在SQL优化中尽量避免使用 OR,可考虑使用 UNION ALL 替代。
3. 数据类型隐式转换
若查询字段的类型与索引列类型不一致,MySQL会自动进行隐式转换,导致索引失效。例如,索引列 varchar 类型,但在查询时未加单引号,可能被转换为数值型或其他类型,从而产生全表扫描。
4. 其他非等值判断
使用 IS NOT NULL 或范围查询(在某些特定配合条件下)也可能影响优化器的选择,需结合执行计划具体分析。
B+Tree 与 Hash 索引对比
MySQL常用的两种索引结构为B+Tree和Hash,它们适用于不同的查询场景。
Hash 索引的特点
Hash索引基于Hash表实现,通过计算Key的Hash值直接定位记录。其优势在于单次等值查询(=, IN, <>)效率极高,无需IO遍历。
局限性:
- 不支持范围查询:Hash值的大小关系与原键值无关,无法进行
>或BETWEEN查询。 - 不支持部分索引:联合索引中,Hash要么全部使用,要么不使用,无法利用最左前缀。
- 无法避免排序:不能利用Hash值进行
ORDER BY或GROUP BY的加速。 - 哈希冲突问题:大量冲突时性能下降明显,甚至需要进行表扫描。
B+Tree 索引的特点(InnoDB默认)
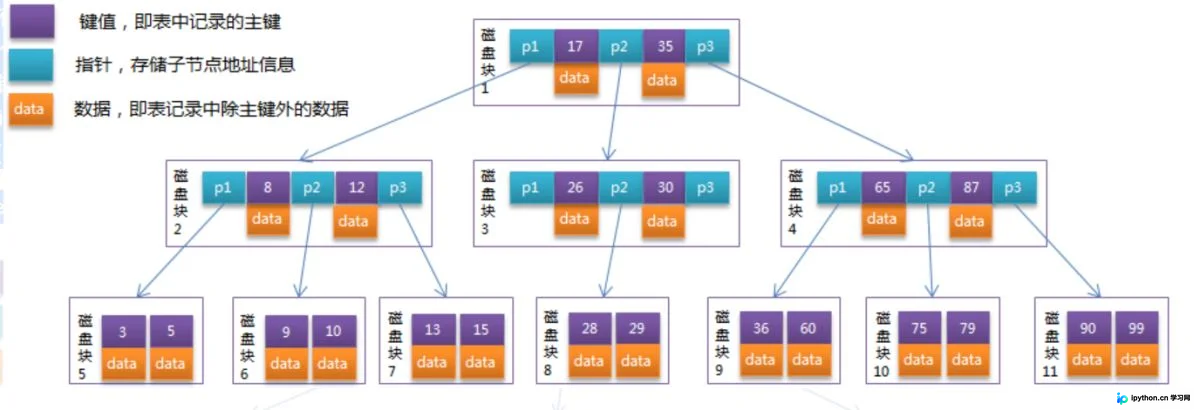
B+Tree是多路查找树的优化版,非叶子节点只存储键值,叶子节点存储数据或通过指针连接。其特点包括:
- 支持范围查询和排序:叶子节点通过链表连接,适合分页和范围检索。
- 高平衡性:高度通常为2-4层,能维护海量数据(如16KB页大小下,3层即可支撑十亿级记录)。
- IO效率低:根节点常驻内存,查找记录只需1-3次磁盘IO。
存储引擎简介
在选择索引策略前,需了解数据库存储引擎的差异:
InnoDB
支持事务(ACID)、外键和崩溃恢复。适用于要求数据完整性高、并发控制强以及频繁更新/删除的场景(如银行、售票系统)。它是MySQL 5.5之后的默认引擎。
MyISAM
插入速度快,占用空间和内存较低。适用于以读为主、对事务一致性要求不高的场景(如日志记录、查询统计)。但不支持事务和外键。
MEMORY
数据存储在内存中,速度极快,常用于临时表处理。
索引优化建议总结
- WHERE过滤:仅在
WHERE子句中频繁使用的字段才考虑建立索引。 - 区分度考量:数据量极少或区分度极低(如性别字段)的列,建立索引收益小,反而增加维护成本。
- 联合索引优于多单列:联合索引能减少磁盘I/O次数,并在写入时维护单一结构,效率更高。排序时应将高频且区分度高的列置于左侧。
- 避免冗余:不要为同一张表建立过多索引,以免拖慢写入速度。
以上就是MySQL单列索引和联合索引的详细解析,更多关于数据库优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









