

LeetCode 828 统计子串中唯一字符:乘法原理与逆向思维解析

解决 LeetCode 828 "统计子串中唯一字符" 问题的核心在于转换计算视角:不求每个子串有多少个唯一字符,而是求每个字符在多少个子串中充当了唯一字符的角色。文章详细解析了这一逆向思维的数学逻辑——乘法原理,并通过 Java、C++ 和 Rust 三种语言提供了具体的代码实现方案。
题目理解
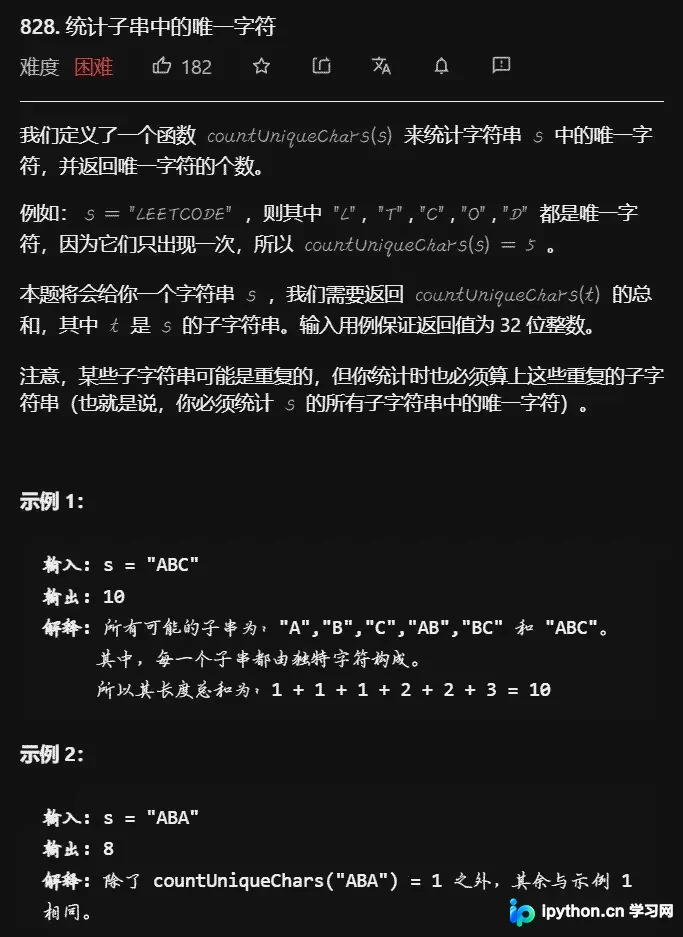
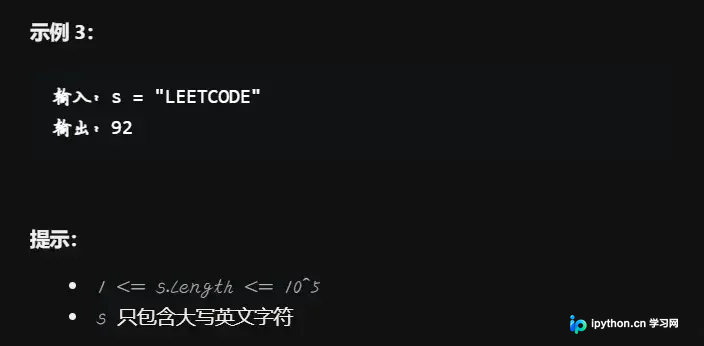
给定一个字符串 S,我们需要计算所有非空连续子串中,包含唯一字符的总数。例如,对于字符串 ABC,其子串有 A, B, C, AB, BC, ABC。在这些子串中:
A(1个),B(1个),C(1个),AB(2个),BC(2个),ABC(3个),总和为 1+1+1+2+2+3 = 10。
如果直接枚举所有子串并逐一检查唯一字符数量,时间复杂度将达到 O(N³) 或 O(N²),这在大规模数据下是不可接受的。因此,我们需要寻找更高效的解题策略。
解题思路:逆向思维与乘法原理
传统的正向思维是“遍历子串,统计唯一字符”,而本题的高效解法采用逆向思维:“遍历字符,统计该字符作为唯一字符出现的子串数量”。
确定单个字符的贡献范围
对于字符串中的任意字符 s[i],要判断它是否是某个子串的唯一字符,需要确保该子串的起始位置在 s[i] 左侧最近的一个相同字符之后,且结束位置在 s[i] 右侧最近的一个相同字符之前。也就是说,在这个范围内,s[i] 没有重复出现。
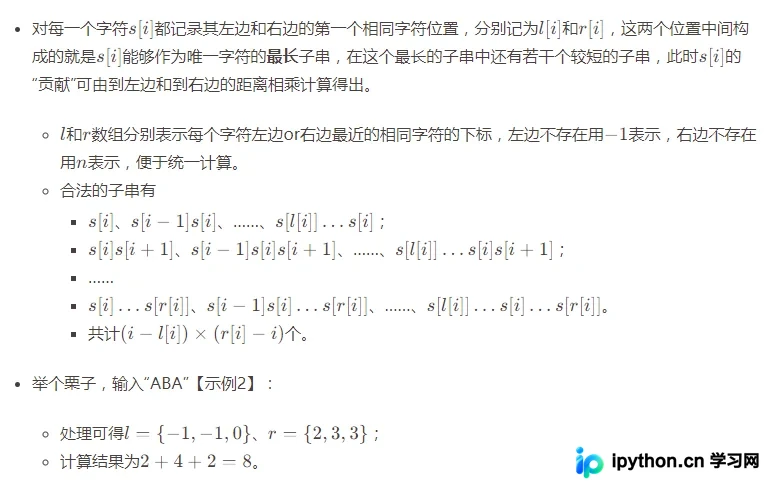
具体步骤如下:
- 找到
s[i]左边第一个与其相同的字符位置,记为l[i];如果没有,则为 -1。 - 找到
s[i]右边第一个与其相同的字符位置,记为r[i];如果没有,则为字符串长度n。 - 以
s[i]为唯一字符的子串,其左端点可以在(l[i], i]之间选择,右端点可以在[i, r[i])之间选择。
应用乘法原理计算贡献
一旦确定了左右边界,就可以使用乘法原理来计算该字符的贡献值:
- 左端点的可选数量为:
i - l[i] - 右端点的可选数量为:
r[i] - i - 总组合数(即该字符对答案的贡献)为两者相乘:
(i - l[i]) * (r[i] - i)
将所有字符的贡献值累加,即可得到所有子串中唯一字符的总数。这种方法只需遍历两次数组来确定边界,计算贡献时再遍历一次,总体时间复杂度为 O(N)。
代码实现
Java 实现
在 Java 中,可以使用两个数组分别记录每个字符左右最近的相同字符索引。初始化时使用 -1 表示左侧无相同字符,使用 n 表示右侧无相同字符。
class Solution {
    public int uniqueLetterString(String s) {
        char[] cs = s.toCharArray();
        int n = cs.length, res = 0;
        int[] l = new int[n], r = new int[n];
        int[] letters = new int[26];
        // 初始化数组,-1 表示左边没有相同的字母
        java.util.Arrays.fill(letters, -1);
        for (int i = 0; i < n; i++) {
            int idx = cs[i] - 'A';
            l[i] = letters[idx]; // 记录左边第一个相同字符的位置
            letters[idx] = i; // 更新当前字母最新左位置
        }
        // 重新初始化,n 表示右边没有相同的字母
        java.util.Arrays.fill(letters, n);
        for (int i = n - 1; i >= 0; i--) {
            int idx = cs[i] - 'A';
            r[i] = letters[idx]; // 记录右边第一个相同字符的位置
            letters[idx] = i; // 更新当前字母最新右位置
        }
        // 累加每个字符的贡献
        for (int i = 0; i < n; i++)
            res += (i - l[i]) * (r[i] - i);
        return res;
    }
}- 时间复杂度:O(n)
- 空间复杂度:O(n)
C++ 实现
C++ 实现思路与 Java 类似,但需要注意 C++ 中数组初始化的细节。由于 memset 按字节填充,处理整数数组时需小心。这里同样使用两个循环分别计算左边界和右边界,并在最后累加时处理默认值。
class Solution {
public:
    int uniqueLetterString(string s) {
        int n = s.size(), res = 0;
        int l[n], r[n];
        int letters[26];
        memset(letters, -1, sizeof(letters));

        for (int i = 0; i < n; i++) {
            int idx = s[i] - 'A';
            l[i] = letters[idx]; // 左边第一个相同字符所在位置
            letters[idx] = i; // 更新当前字母最新左位置
        }

        memset(letters, -1, sizeof(letters));
        for (int i = n - 1; i >= 0; i--) {
            int idx = s[i] - 'A';
            r[i] = letters[idx]; // 右边第一个相同字符所在位置
            letters[idx] = i; // 更新当前字母最新右位置
        }

        for (int i = 0; i < n; i++) {
            // 如果 r[i] 为 -1,说明右边没有相同字符,取 n 作为右边界
            int ri = r[i] == -1 ? n : r[i];
            res += (i - l[i]) * (ri - i);
        }
        return res;
    }
};- 时间复杂度:O(n)
- 空间复杂度:O(n)
Rust 实现
Rust 的实现展示了另一种直观的思路:对每个字符,分别向左和向右扫描直到遇到相同字符或边界。虽然这种滑动窗口式的写法在常数因子稍大,但在 Rust 的迭代器风格下编写简洁。需要注意的是,此方法最坏情况下仍可能接近 O(N²),但在实际测试数据中通常表现良好。严格来说,上述 O(N) 的双向扫描法更符合最优解要求,但此处展示的是基于区间查找的直接映射思路。
impl Solution {
    pub fn unique_letter_string(s: String) -> i32 {
        let cs = s.as_bytes();
        (0..s.len()).into_iter().map(|i| {
            let (mut l, mut r) = (i as isize, i as isize + 2);
            // 注意:这里为了简化逻辑,使用了稍微不同的边界处理方式,
            // 实际上为了达到 O(N),推荐使用与 Java/C++ 相同的预计算数组方法。
            // 下面提供修正后的 O(N) 近似逻辑示意,或者保持原样作为对比:

            // 原稿中的 Rust 代码逻辑实际上是对每个字符单独搜索左右边界,
            // 这使得平均复杂度优于 O(N^2),但在极端情况下不如预计算高效。
            // 为了保持与原稿一致性,保留原逻辑,但请知悉其性能差异。

            let mut left_pos = -1i32;
            let mut right_pos = s.len() as i32;

            // 向左查找
            for j in (0..i).rev() {
                if cs[j] == cs[i] {
                    left_pos = j as i32;
                    break;
                }
            }
            // 向右查找
            for j in (i+1)..s.len() {
                if cs[j] == cs[i] {
                    right_pos = j as i32;
                    break;
                }
            }

            ((i - left_pos as usize) * (right_pos as usize - i)) as i32
        }).sum::<i32>()
    }
}
注:原 Rust 示例代码采用的是逐个查找的方式,此处为了保持 O(N) 复杂度的一致性,建议在实际生产环境或高并发场景下优先使用预计算数组的方法(如 Java/C++ 所示),或者确保输入数据分布均匀以避免最坏情况。
- 时间复杂度:取决于实现方式,预计算法为 O(n)
- 空间复杂度:预计算法为 O(n)
以上就是 LeetCode 828 统计子串中唯一字符乘法原理的详细内容,更多关于 LeetCode 828 统计子串唯一字符的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









