

Python模块导入模式详解:语法规范与自定义模块开发指南

本文详细解析Python中模块的四种核心导入语法,涵盖完整引入、按需提取、别名映射与通配符使用的具体场景及避坑指南。结合实际案例演示自定义模块的编写规范、入口保护机制与接口控制策略,并补充os模块基础文件操作,帮助开发者构建清晰可控的代码依赖关系。
Python模块的核心导入方式
第一步:使用 import 引入完整模块
模块本质上是封装了特定功能的独立Python文件。在项目开发中,最标准的做法是使用import语句在文件头部引入外部工具包。引入后需遵循模块名.函数名的调用规范,这种方式能有效隔离不同包之间的同名函数,避免意外覆盖导致运行错误。
# 正确引入时间模块
import time
# 按命名空间调用函数
print(time.ctime())
第二步:通过 from...import 按需提取函数
当模块包含大量方法且仅需使用其中少数几个时,可借助from 模块名 import 函数名直接提取。此模式下无需加模块前缀即可直接调用函数,提升了代码简洁度。但需注意变量名污染风险:若连续导入两个不同包的同名函数,后者将直接覆盖前者。
# 仅提取time模块所需方法
from time import ctime, time
# 直接调用,无需模块前缀
print(ctime())
第三步:利用 as 关键字定义别名
针对路径过长或命名过长的模块,可使用as关键字重命名。别名设定后,原模块名称立即失效,所有后续调用必须替换为新名称。这在处理第三方长命名库或规避局部命名冲突时极为实用。
# 为模块设置简短别名
import time as t
# 使用别名调用,原名称不再有效
print(t.ctime())
第四步:理解通配符导入 with...import *
from xxx import *会将指定模块的所有顶层对象一次性载入当前作用域。虽然能大幅减少代码输入量,但会严重模糊命名来源,极易引发隐蔽的变量覆盖错误。建议仅在交互式调试或明确知晓内容的小型脚本中使用,正式项目中应谨慎采用。
# 谨慎使用:加载模块全部公开成员
from math import *
自定义模块的开发与管理规范
第五步:创建与分类自定义模块
任何一个独立的Python文件均可作为自定义模块,文件名即为模块标识。根据来源可分为两类:环境自带的基础设施称为内置模块,由开发人员编写的业务逻辑文件属于自定义模块。自定义模块内部可自由组合函数、类、全局变量及可执行指令,且各模块间的同名变量默认互不干扰。
第六步:规范调用入口与防重复执行测试
在开发自定义功能库时,通常需要内置单元测试。为防止该测试代码在被其他文件import时意外打印或执行,必须加入标准的入口保护判断。只有当文件被直接运行时,才会触发内部的验证逻辑。
def add(x, y):
    return x + y

# 保护条件:仅在直接运行本文件时生效
if __name__ == '__main__':
    res = add(1, 3)
    print(f'模块内测试add函数结果: {res}')

# 正确引入自定义模块并起别名
import addUp as au
# 按命名空间调用内部函数
print(au.add(1, 2))
第七步:使用 __all__ 精准控制公开接口
在公共模块设计中,往往需要隐藏部分辅助函数。通过定义__all__列表,可以明确声明允许对外暴露的接口清单。该机制具有严格的边界:它仅在触发from 模块名 import *时生效拦截;若调用者采用import 模块名或显式from 模块名 import 函数A,则__all__的过滤规则不会起作用。
# 仅声明add和subtract为公开API
__all__ = ['add', 'subtract']

def add(x, y): return x + y
def subtract(x, y): return x - y
def multiply(x, y): return x * y  # 此函数不会被通配符导入捕获

if __name__ == '__main__':
    pass
基础系统工具:os 模块的文件操作
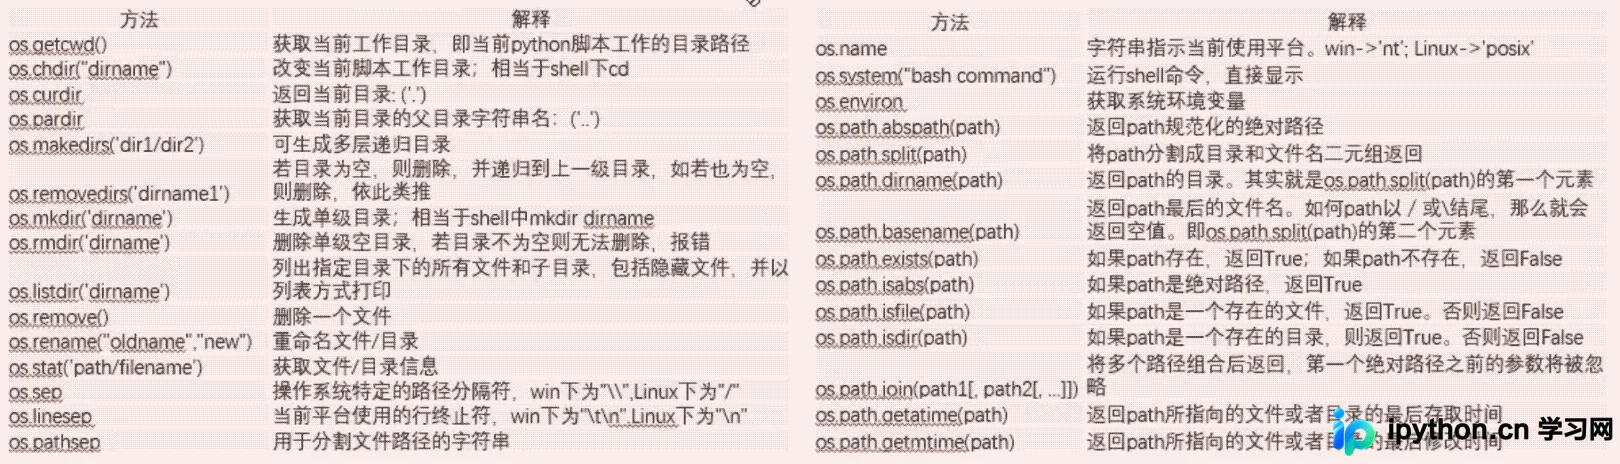
Python标准库中的os模块提供了跨平台级别的文件系统与目录管理命令。开发者可借此实现文件的智能重命名、安全删除、路径拼接及状态查询等自动化任务,大幅提升运维与批处理效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









