

C语言整形数据存储:原码补码与大小端详解

C语言中整型数据在内存中以二进制补码形式存储,涉及原码、反码的计算以及大端/小端字节序的差异。理解这些底层机制对于掌握指针操作、类型转换及排查数值计算错误至关重要。
数据类型与存在意义
C语言拥有丰富且严谨的数据类型系统,不同类型的本质区别在于其占据的内存大小以及对内存的解读视角。
基本数据类型概述
- 字符类型:
char,占用1个字节。 - 短整型:
short,通常占2个字节。 - 整型:
int,通常占4个字节。 - 长整型:
long,在32位系统中通常为4字节,64位Linux/GNU环境常为8字节(Windows保持4字节);long long保证至少8字节。 - 浮点型:
float(单精度,4字节)和double(双精度,8字节)。
值得注意的是,C语言标准并未定义专门的“字符串类型”。字符串在C中被视为字符数组,并以 '\0' 作为结束标志处理。
类型的三大作用
确定数据类型不仅仅是为了区分变量名,它决定了编译器行为的三个核心维度:
- 开辟空间大小:决定变量在栈或堆上分配的字节数(如
int占4字节)。 - 内存访问视角:决定了指针解引用时读取几个字节(如
char*读1字节,int*读4字节)以及指针步进的字节数。 - 数值解释规则:决定了对应内存比特流是有符号还是无符号,是整数还是浮点数。
有符号与无符号类型
在整型家族中,除特定平台外,signed(有符号)和 unsigned(无符号)涵盖了正负数的范围差异。
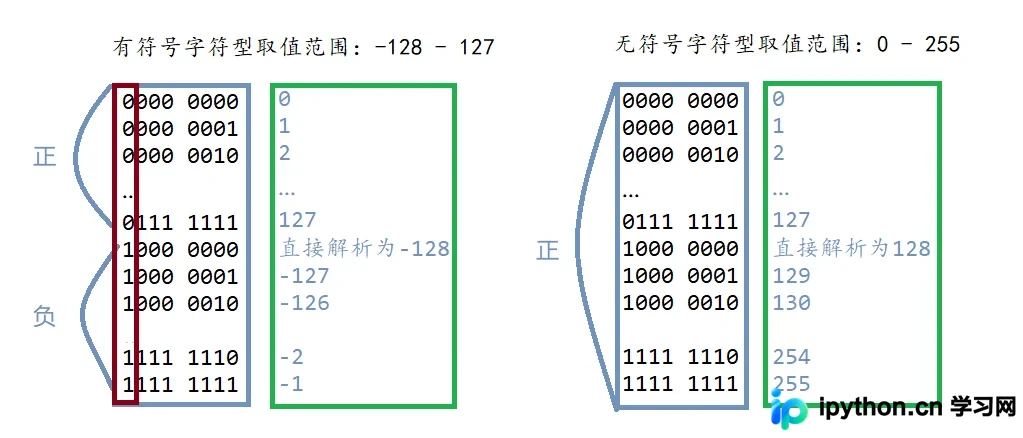
- signed:最高位为符号位,其余为数值位。可表示负数和正数。
- unsigned:所有位均为数值位,仅表示非负数,范围比同长度 signed 更大。
关于 char 的特殊性:
C标准未规定 char 默认是否有符号,这取决于编译器实现。现代主流编译器(如Visual Studio)通常将 char 默认为 signed char。但在跨平台代码中,显式指定 signed char 或 unsigned char 是更安全的选择。
整型的内部存储:原码、反码与补码
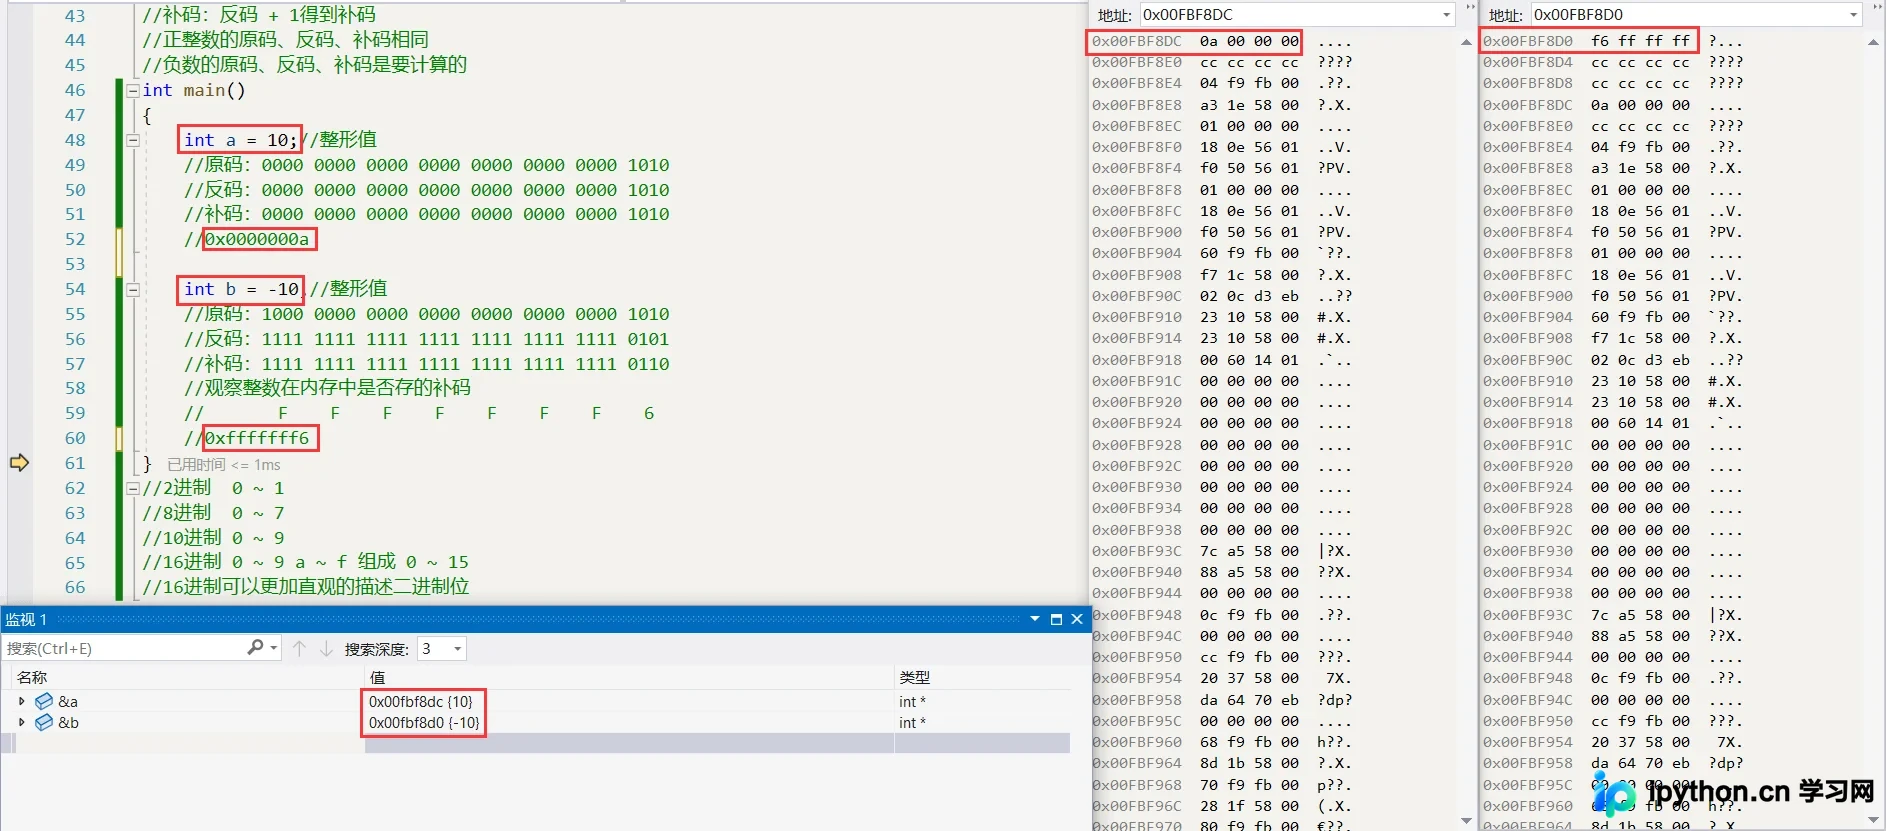
当我们声明一个整型变量时,内存中实际存放的是什么?以 int a = 10; 为例,直接写入二进制的十进制值并非最终结果。计算机内部统一采用补码来存储和处理数值。
三种二进制表示法
所有整型均包含符号位(最高位,0为正,1为负)和数值位。
- 原码:直接将绝对值转换为二进制,最高位放符号。
例如 +10 的原码(32位):0000...0000 1010。
例如 -10 的原码:1000...0000 1010。 - 反码:正数反码等于原码;负数反码为原码符号位不变,其余按位取反。
例如 -10 的反码:1111...1111 0101。 - 补码:正数补码等于原码;负数补码为反码加1。
例如 -10 的补码:1111...1111 0110。
通过调试器查看内存,可以发现变量 -10 的十六进制显示为 0xFFFFFF F6(即 F6 对应 0110),这正是其补码形态。
为什么使用补码?
引入补码主要有两个工程优势:
- 符号位与数值域统一:符号位可以直接参与数学运算,无需单独判断符号。
- 简化硬件设计:CPU只需要加法器。减法可以通过加上负数的补码来实现(即 $A - B = A + (-B)$)。如果使用原码,减法电路会变得极其复杂。
大小端模式与大端小端图示
了解内存中的内容后,还需关注内容的排列顺序。由于内存按字节编址,而多字节类型(如 int)跨越多个地址单元,便产生了字节序问题。
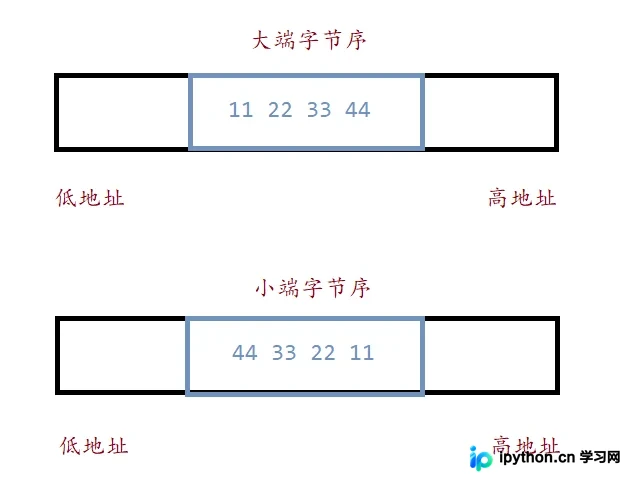
- 大端(Big-Endian):数据的高位字节存放在内存的低地址处。符合人类的阅读习惯(从左到右,从高位到低位)。
- 小端(Little-Endian):数据的低位字节存放在内存的低地址处。这是 x86/x64 架构的主流方式。
以 0x11223344 在小端模式下(假设起始地址为 0x00):0x00: 44, 0x01: 33, 0x02: 22, 0x03: 11。
如何检测当前机器的大小端?
利用联合体的特性或指针的强转可以简洁地实现检测逻辑。以下使用指针技巧展示:
int check_sys() {
    int a = 1;
    // 使用 char* 指针访问第一个字节(最低地址)
    if (*(char*)&a == 1) {
        return 1; // 小端存储,最低位是1,放在低地址
    } else {
        return 0; // 大端存储,最低位是0,高位置于低地址
    }
}

int main() {
    int ret = check_sys();
    if (ret == 1) {
        printf("小端\n");
    } else {
        printf("大端\n");
    }
    return 0;
}
该示例基于 int 为4字节,值为1时,无论大小端,最低有效位(LSB)的二进制总是 00000001。在小端模式下,这个 01 位于低地址;在大端模式下,它位于高地址。
练习案例:截断、提升与溢出
理解存储原理后,我们通过几个经典题目来验证对类型转换和内存布局的理解。
案例1:signed 与 unsigned char 的输出差异
int main() {
    char a = -1; // -1 的补码为全 1 (0xFF)
    signed char b = -1;
    unsigned char c = -1;

    // %d 需要打印有符号整数,触发整形提升
    printf("a=%d, b=%d, c=%d\n", a, b, c);
    return 0;
}
解析:
1. a 和 b 是有符号字符,赋值 -1 时在内存中存为 0xFF。当传给 printf 的 %d 时,发生有符号整形提升,高位补符号位1,结果为 32位的 0xFFFFFFFF,即 -1。
2. c 是无符号字符,存为 0xFF。传给 %d 时,发生无符号整形提升,高位补0,结果为 32位的 0x000000FF,即 255。

案例2:char 越界存储 (%u 打印)
int main() {
    char a = -128;
    // -128 补码:1000 0000 0000... 1000 0000 -> 截断存为 1000 0000
    // 1000 0000 作为 char 是有符号的 -128
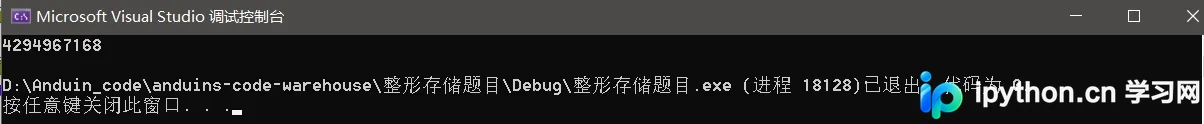
    printf("%u\n", a); // %u 打印无符号数
    return 0;
}
解析:
内存中存储的是 1000 0000 (0x80)。
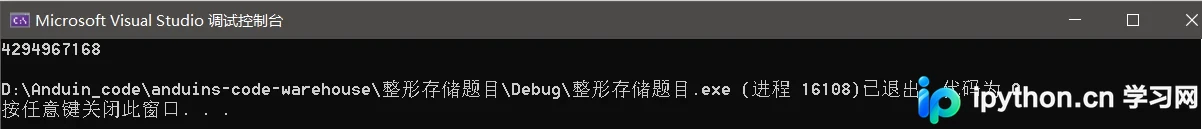
当使用 %u 打印时,首先进行无符号提升(因为参数传递到变参函数前不会自动转为unsigned,但格式化说明符 %u 告诉 printf 将其看作无符号数处理提升)。或者更直观地看:如果是 unsigned char 存了 0x80,提升后为 0x00000080。但这里是 signed char,先进行有符号提升变成 0xFFFFFF80,然后按照无符号数格式输出,结果即为 0xFFFFFF80 对应的十进制值:4294967168。
案例3:正溢出与死循环陷阱
int main() {
    // 情况1: i + j
    int i = -20;
    unsigned int j = 10;
    printf("%d\n", i + j); // 结果: -10

    // 情况2: 无符号自减导致的死循环
    unsigned int i = 9;
    for (; i >= 0; i--) { // 永远大于等于0
        printf("hello world\n");
    }
    return 0;
}
解析:
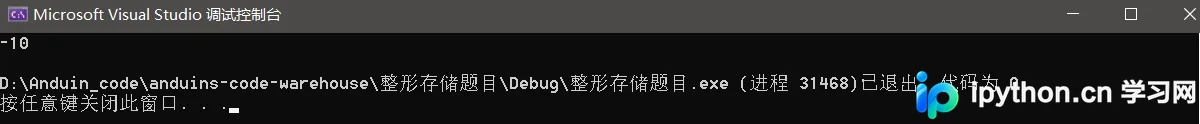
1. i + j:因为有 unsigned int,根据整型提升规则,int 会被提升为 unsigned int。即 -20 被当作无符号大整数与 10 相加,最后用 %d 强制解释结果。实际上在二进制层面,它们正常相加得到代表 -10 的补码序列,若用 %u 会输出巨大数字,用 %d 则还原回 -10。
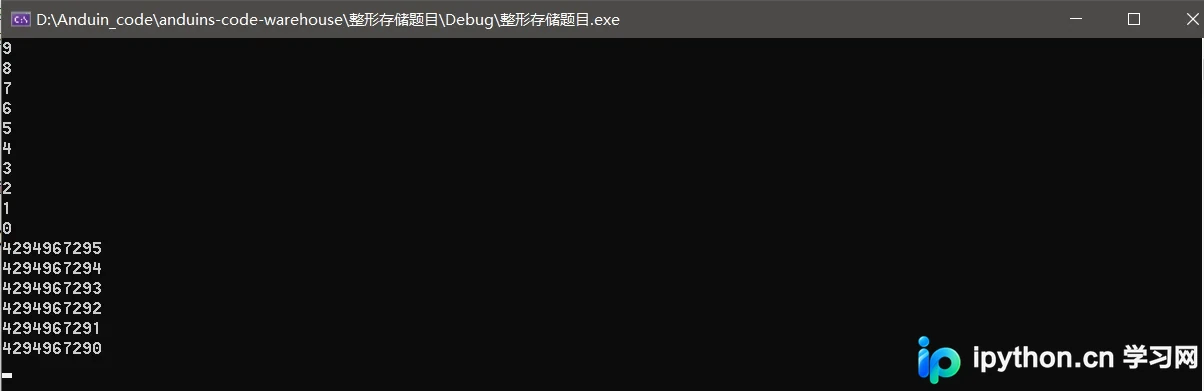
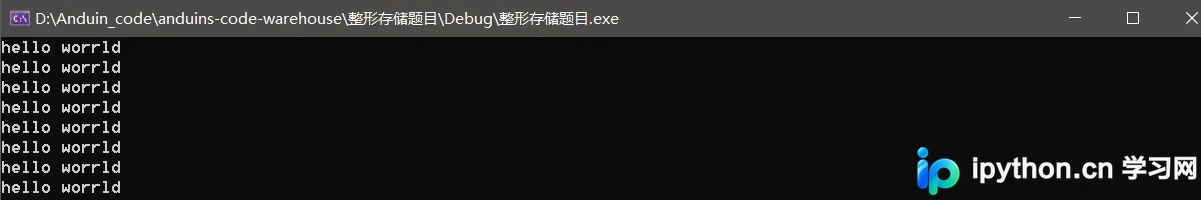
2. for 循环:变量 i 定义为 unsigned int。条件 i >= 0 对于无符号数永远成立。当 i 减到 0 再次执行 i-- 时,会发生无符号下溢,0 - 1 变为该类型的最大值(如 0xFFFFFFFF),导致无限循环。
案例4:字符串长度计算陷阱
int main() {
    char a[1000];
    int i;
    for (i = 0; i < 1000; i++) {
        a[i] = -1 - i;
    }
    printf("%d\n", strlen(a));
    return 0;
}
解析:
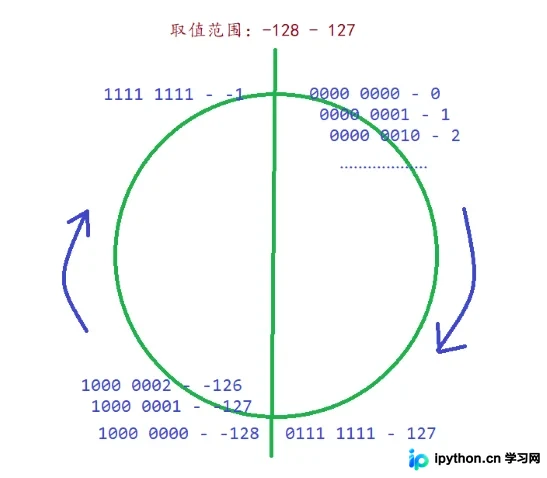
该循环依次向数组填入 -1, -2, ..., -128。到达 -128(二进制 1000 0000)后,下一次赋值为 -129。
由于 char 只有8位,发生截断。 -129 的补码是 1111 1111 1000 0001,截取后8位 1000 0001,这代表有符号数的 -127。
以此类推,值会在 -128 到 127 之间不断循环变化,永远不会出现 0(即 '\0' 结束符),直到填满整个数组或被其他数据覆盖。此题若无后续赋值,strlen 将越过数组边界继续查找直到遇到随机的 0,造成未定义行为。

案例5:全局与局部变量同名隐藏
unsigned char i = 0; // 全局变量
int main() {
    int i = 0; // 局部变量,屏蔽了全局的 i
    for (i = 0; i <= 255; i++) {
        printf("hello world\n");
    }
    return 0;
}
解析:
虽然全局定义了 unsigned char i,但在 main 内使用了 int i。循环条件是 int 类型的比较,因此这是一个普通的死循环(只要不干预,一直打印),并不会像我们预期那样利用 unsigned char 的特性在255后归零终止循环,因为这里的 i 已经是 32 位的 int。
总结
掌握C语言的整型存储不仅是笔试考点,更是编写健壮代码的基础。无论是处理网络协议包(涉及大小端)、嵌入式寄存器配置(涉及截断和移位),还是防止逻辑错误(如溢出判断),清晰理解原码补码转换与存储规则都是关键一步。
以上就是C语言整形在内存中存储原理的详细分析,更多关于C语言底层机制的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









