

Python 并行化执行详细解析

针对计算耗时过长或物理行为模拟等场景,Python 原生线程受 GIL 限制难以发挥多核优势。本文通过 N 体问题与数学累加案例,演示如何拆分任务并利用 multiprocessing.Pool 实现多进程并行执行。内容涵盖任务划分策略、跨进程通信、结果汇总及关键参数调优,附带完整可运行代码与性能对比验证方法。
为何需要 Python 并行化执行
常规脚本顺序执行在面临海量数据处理、复杂物理规律推演或高精度数值计算时极易成为性能瓶颈。由于 CPython 的全局解释器锁(GIL)机制,多线程在 CPU 密集型任务中实际无法并行运算。将计算逻辑拆解为独立模块,并通过操作系统级多进程调用独立内存空间,是提升单节点算力的直接路径。
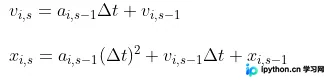
基线对照:串行 N 体问题模拟
以经典的多体引力相互作用为例,串行计算需逐个遍历粒子,更新其加速度、速度与位置。该过程存在大量重复的矩阵运算,随着粒子数量 $N$ 呈指数级增长。
import numpy as np
import time
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

def remove_i(x, i):
    "从坐标数组中移除指定索引的粒子"
    shape = (x.shape[0]-1,) + x.shape[1:]
    y = np.empty(shape, dtype=float)
    y[:i] = x[:i]
    y[i:] = x[i+1:]
    return y

def calc_acceleration(i, x, G, m):
    "计算第 i 个粒子的瞬时加速度"
    x_i = x[i]
    x_j = remove_i(x, i)
    m_j = remove_i(m, i)
    diff = x_j - x_i
    mag3 = np.sum(diff**2, axis=1)**1.5
    result = G * np.sum(diff * (m_j / mag3)[:, np.newaxis], axis=0)
    return result

def timestep(x0, v0, G, m, dt):
    "执行一步动力学演化"
    N = len(x0)
    x1 = np.empty(x0.shape, dtype=float)
    v1 = np.empty(v0.shape, dtype=float)
    for i in range(N):
        a_i0 = calc_acceleration(i, x0, G, m)
        v1[i] = a_i0 * dt + v0[i]
        x1[i] = a_i0 * dt**2 + v0[i] * dt + x0[i]
    return x1, v1

def initial_cond(N, D):
    x0 = np.random.rand(N, D)
    v0 = np.zeros((N, D), dtype=float)
    m = np.ones(N, dtype=float)
    return x0, v0, m

def simulate_serial(N, D, S, G, dt):
    fig = plt.figure()
    ax = Axes3D(fig)
    x0, v0, m = initial_cond(N, D)
    for s in range(S):
        x1, v1 = timestep(x0, v0, G, m, dt)
        x0, v0 = x1, v1
        t = 0
        for p in x0:
            ax.scatter(p[0], p[1], p[2], c=["black", "green", "red"][t % 3])
            t += 1
    plt.show()

start = time.time()
simulate_serial(2, 3, 100, 9.8, 1e-3)
print("串行总耗时:", time.time() - start)
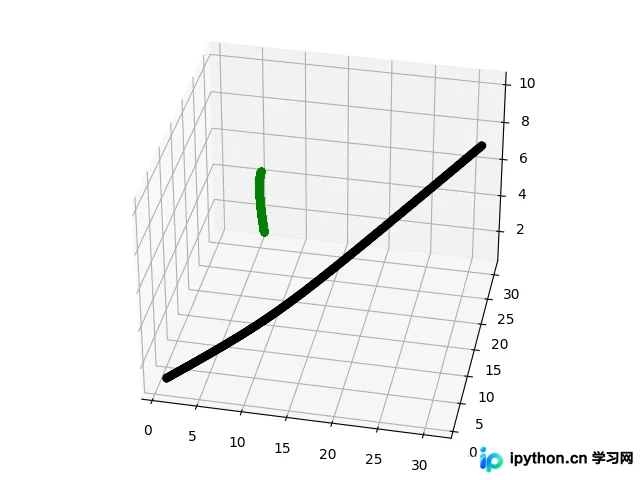
上述代码逻辑清晰,但在粒子数增加后,主循环会持续占用单一 CPU 核心。可视化输出呈现连续的运动轨迹叠加,直观展示了计算过程的累积效应。
多进程并行改造实操流程
第1步:评估硬件环境并设定基础参数
在引入并行化前,需确认目标机器的逻辑处理器数量。Windows/Linux 任务管理器可查看核心数。需注意启用超线程的 Intel/AMD CPU 在调度密集型浮点运算时,有效并行度常约为物理核心的一半。同时,32 位 Python 进程默认内存上限为 2GB,大规模数组需切换至 64 位解释器以避免溢出。
第2步:搭建任务分发与执行框架
使用 multiprocessing.Pool 管理工作进程池。将待处理的数据切分为互不依赖的子集,通过 apply_async 或 map 投递至空闲进程。此模板可适配任何具备纯函数特征的计算逻辑。
import datetime
import multiprocessing as mp

def accessional_fun():
    with open("accession.txt", "r") as f:
        return float(f.read())

def worker_task(name, param):
    "各进程独立执行的计算单元"
    base_val = accessional_fun()
    result = sum(n + base_val * 2 for n in param)
    return {name: result}

if __name__ == '__main__':
    start_time = datetime.datetime.now()
    # 获取可用核心数
    num_cores = int(mp.cpu_count())
    print(f"当前系统逻辑核数: {num_cores}")

    # 定义并发池大小(通常为 cpu_count 或略低)
    pool = mp.Pool(min(num_cores, 8))

    # 任务字典:名称对应待处理数据块
    task_dict = {
        'task1': list(range(10, 300)),
        'task2': list(range(300, 600)),
        'task3': list(range(600, 900)),
        'task4': list(range(900, 1200)),
        'task5': list(range(1200, 1500)),
        'task6': list(range(1500, 1800)),
        'task7': list(range(1800, 2100)),
        'task8': list(range(2100, 2400)),
        'task9': list(range(2400, 2700)),
        'task10': list(range(2700, 3000))
    }

    # 异步提交任务
    async_results = [pool.apply_async(worker_task, args=(k, v)) for k, v in task_dict.items()]
    # 阻塞获取返回值
    final_results = [r.get() for r in async_results]
    pool.close()
    pool.join()

    end_time = datetime.datetime.now()
    elapsed = (end_time - start_time).total_seconds()
    print(f"多进程计算共消耗: {elapsed:.2f} 秒")
    print(final_results)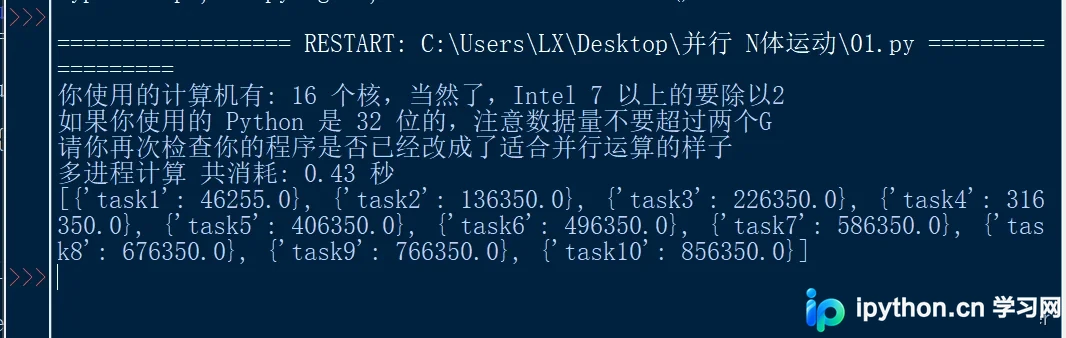
第3步:编写独立计算逻辑并汇总结果
当业务逻辑涉及密集三角函数或线性代数运算时,可直接应用相同模式。通过对比串行与并行版本的时间戳差值,可量化加速比。注意确保子进程间无共享状态冲突,所有中间变量必须在局部作用域内生成。
import math
import time
import multiprocessing as mp

def math_worker(name, chunk):
    "轻量级数学累加任务"
    total = 0.0
    for val in chunk:
        total += math.cos(val) + math.sin(val)
    return {name: total}

if __name__ == '__main__':
    # --- 并行部分 ---
    t_start_mp = time.time()
    cores = mp.cpu_count()
    pool = mp.Pool(cores)
    chunks = {f'p{i}': list(range(i*3e6, (i+1)*3e6)) for i in range(10)}
    res_list = [pool.apply_async(math_worker, args=(k, v)).get() for k, v in chunks.items()]
    pool.close(); pool.join()
    t_end_mp = time.time()
    par_speed = t_end_mp - t_start_mp

    # --- 串行对照部分 ---
    t_start_seq = time.time()
    seq_total = sum(math.cos(i)+math.sin(i) for i in range(30000000))
    t_end_seq = time.time()
    seq_speed = t_end_seq - t_start_seq

    print(f"并行耗时: {par_speed:.2f}s | 串行耗时: {seq_speed:.2f}s | 加速比: {seq_speed/par_speed:.2f}x")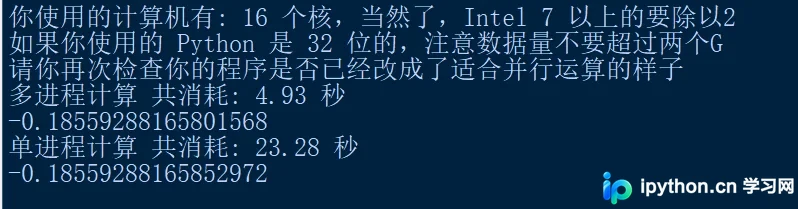
第4步:配置跨节点分布式并行(可选)
对于单机内存或算力触及天花板的超大规模仿真,可升级至基于消息传递接口(MPI)的集群方案。mpi4py 允许在不同物理机器上启动独立进程并同步状态。以下为基础调度骨架,实际部署需配合 mpirun 命令绑定网络接口。
from mpi4py import MPI
from types import FunctionType
import numpy as np

COMM = MPI.COMM_WORLD
rank = COMM.Get_rank()
size = COMM.Get_size()

def master_dispatcher(tasks, func):
    """Rank 0 负责分发任务与收集结果"""
    results = []
    for idx, t in enumerate(tasks):
        COMM.send(t, dest=(idx % (size-1))+1, tag=idx)
    for _ in range(len(tasks)):
        status = MPI.Status()
        data = COMM.recv(source=MPI.ANY_SOURCE, tag=MPI.ANY_TAG, status=status)
        results.append(data)
    return results

def slave_compute(func, payload):
    """工作进程接收指令并返回计算值"""
    return func(payload)

if __name__ == '__main__':
    if rank == 0:
        data_range = list(range(128))
        out = master_dispatcher(data_range, lambda x: x**2)
        print("集群聚合完成", out[:5])
    else:
        while True:
            msg = COMM.recv(source=0, tag=MPI.ANY_TAG)
            if msg is None: break
            COMM.send(slave_compute(lambda x: x**2, msg), dest=0)
    MPI.Barrier()
性能验证与常见排错指南
成功部署并行化后,可通过监控系统的 CPU 利用率曲线确认进程是否真正满负荷运转。若出现加速不明显的情况,请优先排查以下环节:
- 数据序列化开销:频繁向主进程回传超大列表会导致管道阻塞。应仅返回必要标量或切片,或使用共享内存(
shared_memory)传递数组。 - 任务粒度失衡:拆分过小的计算块会增加进程调度成本。建议每个子任务的预计运行时间不低于 10ms 以保证收益覆盖通信损耗。
- 非纯函数干扰:子进程内若包含全局变量读写或文件句柄争夺,将引发死锁。所有状态必须作为参数显式传入。
以上就是 Python 并行化执行详细解析的详细内容,更多关于 Python 多进程编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









