

MySQL联合索引的最左匹配原则验证与使用指南

在 MySQL 性能优化中,合理使用索引至关重要。本文基于真实测试场景,深入解析联合索引的“最左匹配原则”。通过构建测试表并多次运行 EXPLAIN,直观展示从单列索引到多列联合索引的命中差异,特别针对包含 LIKE 范围查询时的失效情况提供确切结论,助您避开常见的索引设计误区。
实验环境准备
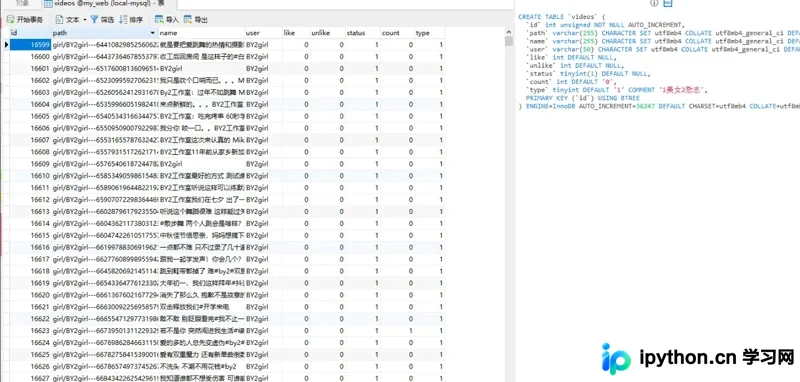
为了准确验证索引机制,我们首先需要创建一个包含多字段的测试表。该表模拟了一个典型的业务数据模型(如视频元数据),其中包含了字符串、整数和枚举类型字段。
以下 SQL 语句定义了测试表结构:
CREATE TABLE `videos` (
  `id` int unsigned NOT NULL AUTO_INCREMENT,
  `path` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci DEFAULT NULL,
  `name` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci DEFAULT NULL,
  `user` varchar(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci DEFAULT NULL,
  `like` int DEFAULT NULL,
  `unlike` int DEFAULT NULL,
  `status` tinyint(1) DEFAULT NULL,
  `count` int DEFAULT '0',
  `type` tinyint DEFAULT '1' COMMENT '1美女2励志',
  PRIMARY KEY (`id`) USING BTREE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;
接下来插入适量数据以支持统计查询。我们将使用 EXPLAIN 关键字来分析 SQL 的执行计划,而不实际执行完整的查询返回结果,从而快速判断索引的使用情况。
单列索引的有效性验证
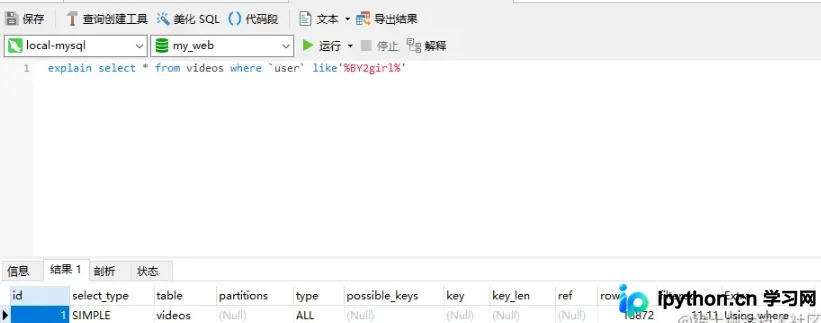
首先,我们在未创建任何额外索引的情况下,对字段 user 进行模糊查询。此时观察 EXPLAIN 的输出,可以看到 MySQL 选择了全表扫描。
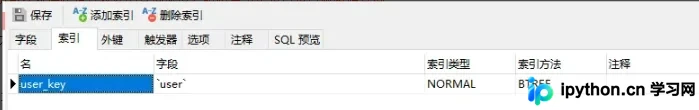
随后,我们专门为 user 字段添加一个 BTREE 索引。BTREE 是 MySQL InnoDB 默认的索引类型,适合范围查询和排序。
再次执行相同的查询,对比加索引前后的 EXPLAIN 结果:
explain select count(*) from videos where `user` like '%BY2girl%';
无索引时:

有索引时:

结果显示,key 列已显示使用了自定义索引名称 user_key。这证明了单列索引能显著提升查询效率,但同时也带来了存储空间的开销和写入性能的损耗。
多个单一索引的局限性
如果为每个高频查询字段都建立独立索引,虽然单个查询可能命中,但在复杂条件下往往只能使用其中一个索引,无法发挥多字段组合过滤的优势。
我们在表中再分别添加针对 path 和 name 字段的独立索引:
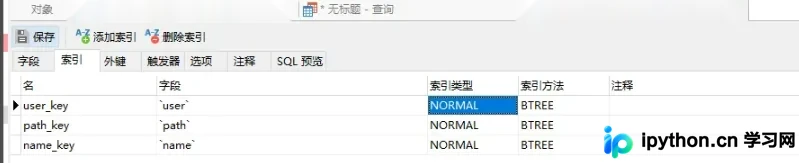
当执行同时涉及这三个字段的查询时:
explain select * from videos where `user` ='BY2' and `path` = 'BY2' and `name` = 'BY2'
MySQL 可能会同时扫描多个索引并进行合并,或者根据优化器选择最优的一个。

然而,一旦引入范围查询(如 LIKE '%...%'),情况就发生了变化。尝试在中间条件使用模糊匹配:
explain select * from videos where `user` ='BY2' and `path` like '%BY2%' and `name` = 'BY2'

由此可见,虽然 MySQL 优化器会尝试将等值查询放在前面以提高效率,但这依赖于优化器的自动改写能力,并非所有场景都能如愿。更重要的是,过多的单列索引会增加维护成本。相比之下,联合索引是更高效的解决方案。
联合索引的核心:最左匹配原则
联合索引是将多个字段组合在一起建立的索引。其核心规则被称为“最左前缀匹配”:即查询条件必须从索引的最左边字段开始,并且不能跳过中间的字段,直到遇到范围查询为止。
创建一个包含 user, path, name 三个字段的联合索引:
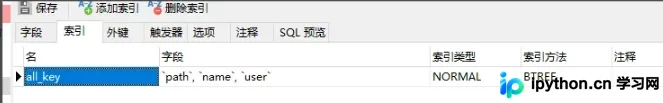
第1步:验证完整命中场景
目的:确认严格按顺序且均为等值查询时,能否利用整个联合索引。
操作:使用 = 精确匹配三个字段。
explain select * from videos where `user` ='BY2' and `path` = 'BY2' and `name` = 'BY2'
结果:

结论:完美命中联合索引。只要是从左到右连续的等值查询,都能有效利用索引。
第2步:验证中间中断场景
目的:测试当范围查询出现在中间位置时,是否还能继续向右匹配。
操作:user 为等值,path 为 LIKE 范围,name 为等值。
explain select * from videos where `user` ='BY2' and `path` like '%BY2%' and `name` = 'BY2'
结果:

结论:索引在 path 处停止匹配。由于 path 是范围查询,MySQL 无法再利用其后的字段建立有序的 B+Tree 查找路径,因此后面的 name 条件无法使用索引。很多人误以为优化器会将 user 和 name 换到前面去,但测试证明这是不可靠的假设。
第3步:验证范围查询在末尾的场景
目的:确认如果范围查询位于最后,前面的字段是否依然生效。
操作:user 和 path 为等值,name 为 LIKE 范围。
explain select * from videos where `user` ='BY2' and `path` = 'BY2' and `name` like '%BY2%'
结果:

结论:user 和 path 成功利用了联合索引的前两部分。name 虽然触发了范围查询导致自身之后的字段失效(本例中 name 是最后一项),但它本身参与的区间扫描也算作索引的使用过程(具体执行计划中 key_len 会有所体现,但在此简化演示中重点在于前两个字段被命中)。
常见误区澄清
在上述验证中,我们发现即使 SQL 语句中 WHERE 条件的书写顺序与联合索引的建立顺序不同,MySQL 优化器在某些简单场景下(如仅由等值查询组成)可能会调整逻辑执行顺序以尝试利用索引。但是,**最左匹配原则的判断依据是“索引本身的物理结构顺序”,而不是 SQL 语句中词法的先后顺序。**
如果你定义的是 (A, B, C) 联合索引:
WHERE A=1 AND B=1 AND C=1:命中 (A, B, C)WHERE B=1 AND A=1:通常只能用到 A 部分(若优化器不调整顺序则可能只用到 A,取决于具体版本和优化器策略,建议养成按索引顺序书写的习惯)WHERE A=1 AND C=1:由于跳过了 B,只能用到 A 部分WHERE A=1 AND B > 1000:由于 B 是范围,C 无法使用索引
总结
通过对 MySQL 联合索引的深度实践与 EXPLAIN 分析,我们验证了最左前缀匹配原则的确切含义:只有从索引最左侧开始、且不包含中断性范围查询(如 LIKE '%...' 或 BETWEEN)的连续字段,才能高效利用联合索引。在实际开发中,应尽量保持查询条件顺序与联合索引定义顺序一致,并尽量避免在中间字段使用模糊搜索,必要时可考虑覆盖索引或重新审视业务需求。
以上就是验证 MySQL 中联合索引最左匹配原则的详细内容,更多关于 MySQL 索引优化技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









