

MySql常见查询方式详解

本文系统梳理MySQL核心数据查询技术,涵盖从简单的数据新增到复杂的聚合统计、分组过滤及多表关联。通过具体SQL语句实例,解析 count、sum、group by、having、inner/left/right join 及自连接等关键操作的实际应用与执行顺序。
数据新增
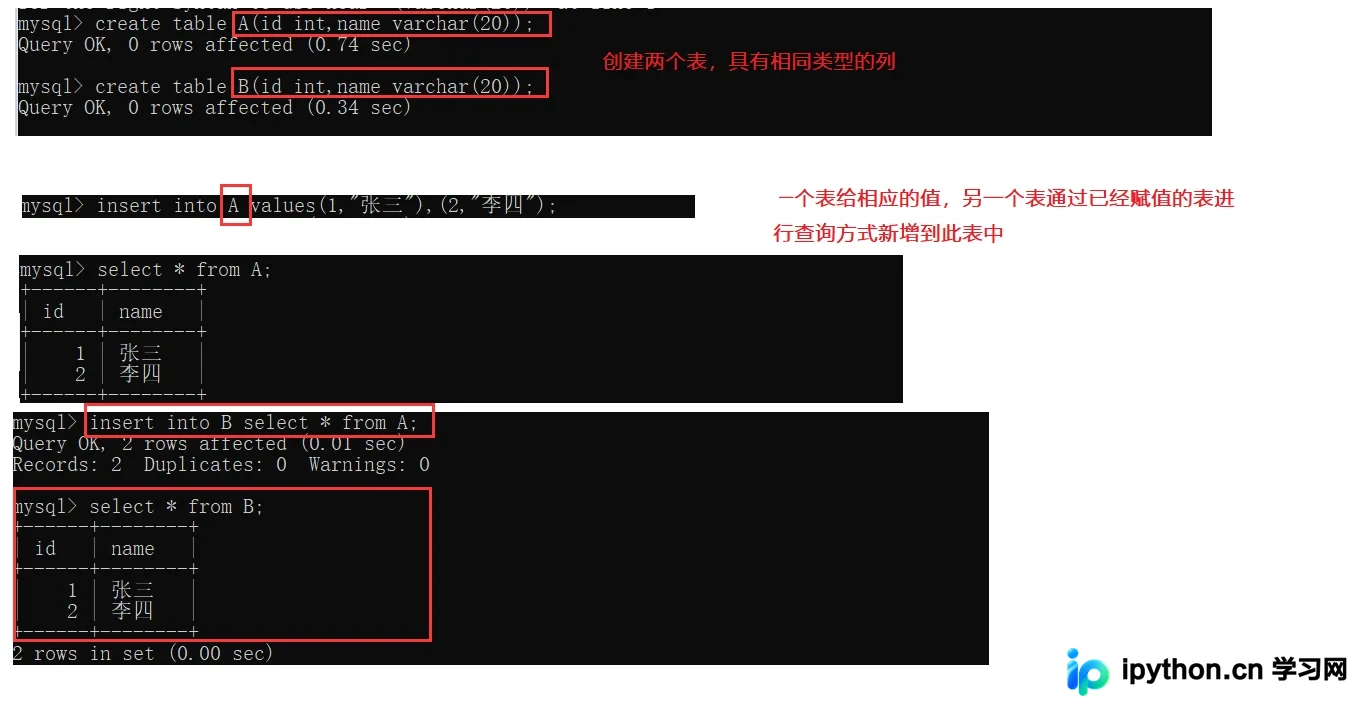
除了常规的 INSERT INTO 逐条插入,MySQL支持将查询结果直接存入新表或现有表中。这种写法常用于数据备份或日志迁移。
INSERT INTO B SELECT * FROM A;
// 将A表的所有信息通过查询后,批量新增到B表中
聚合查询
聚合函数用于对一组值执行计算并返回单个值,是统计分析中最常用的工具。
记录总数与数值求和
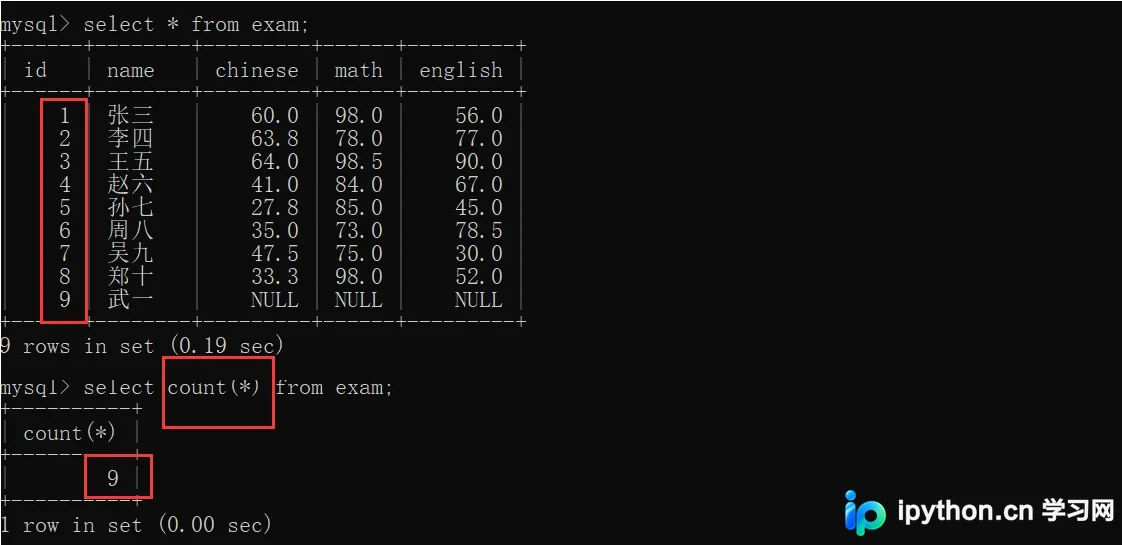
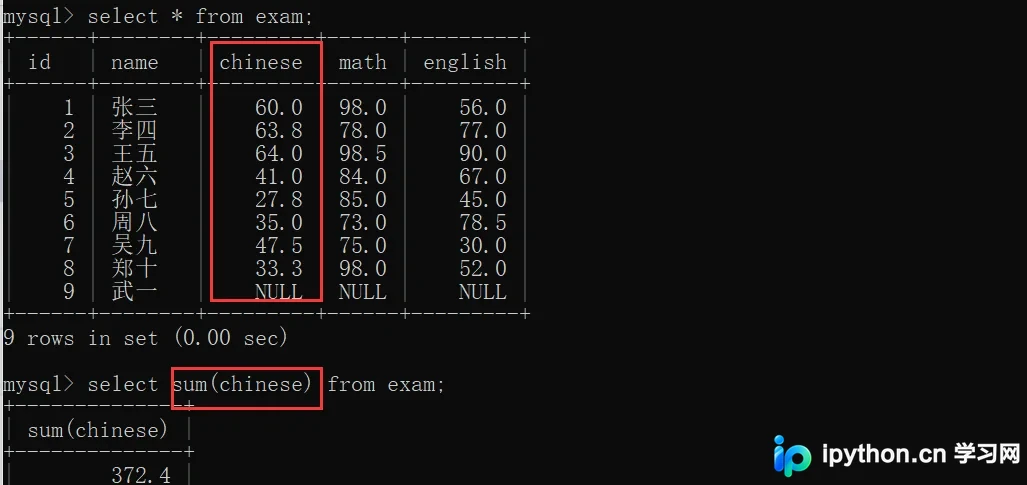
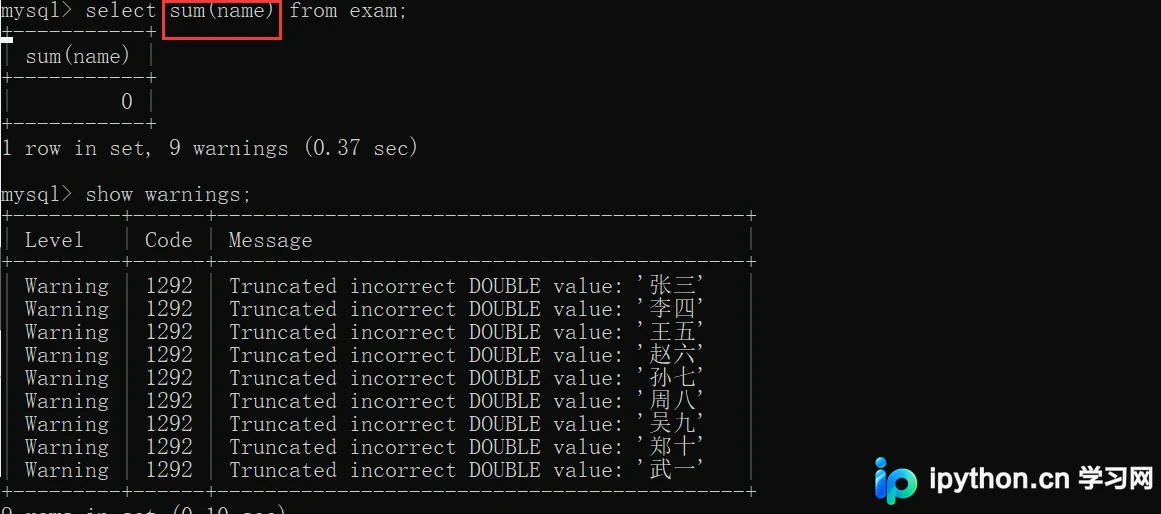
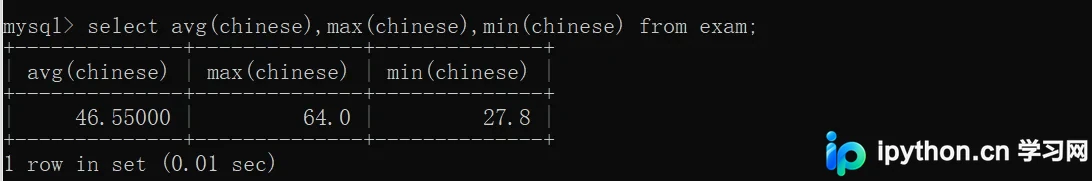
COUNT() 用于统计查询结果集中的行数(总记录数)。SUM() 则用于计算某一列的总和,但仅适用于数值型字段,对非数字内容无意义。
平均值与极值
AVG() 返回平均值,MAX() 返回最大值,MIN() 返回最小值。这三个函数同样主要针对数值类型进行计算,也可用于日期或字符串类型的比较排序。
分组查询
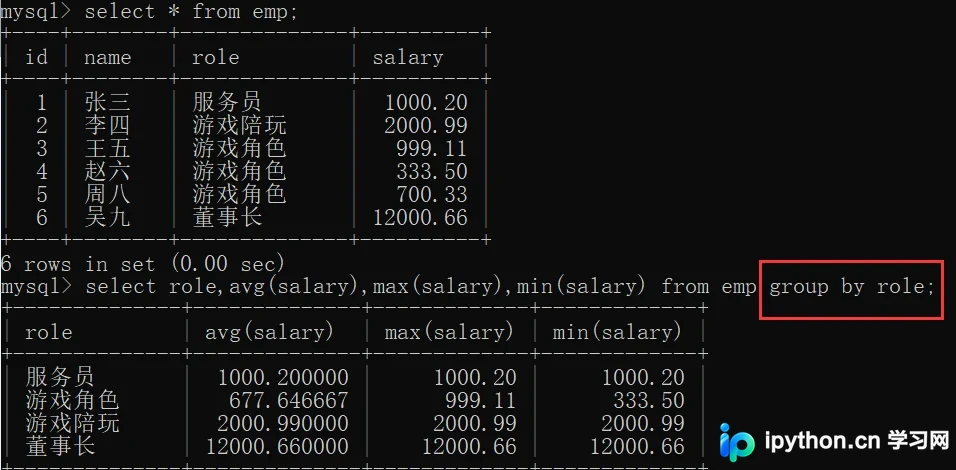
当需要按特定条件归类数据时,需使用 GROUP BY 子句。其执行逻辑是先根据指定条件对数据进行分组,随后对每个分组单独执行聚合函数计算。
SELECT * FROM 表名 GROUP BY 分组条件;
条件筛选:WHERE 与 HAVING 的区别
在数据过滤中,正确选择前置还是后置过滤至关重要,主要区别在于执行阶段:
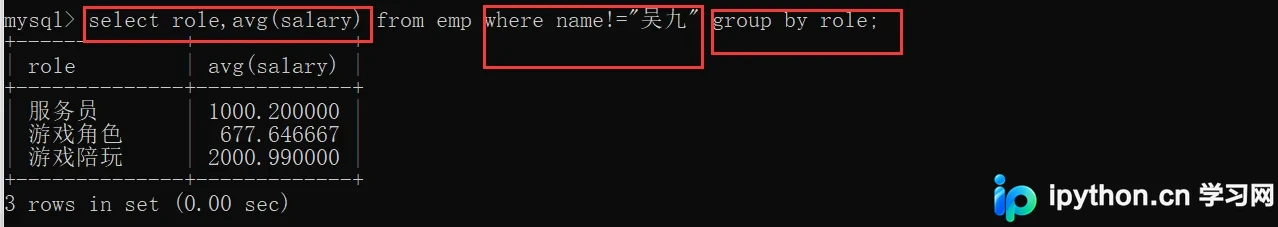
- WHERE:在分组之前执行。它用于过滤参与分组的原始记录。
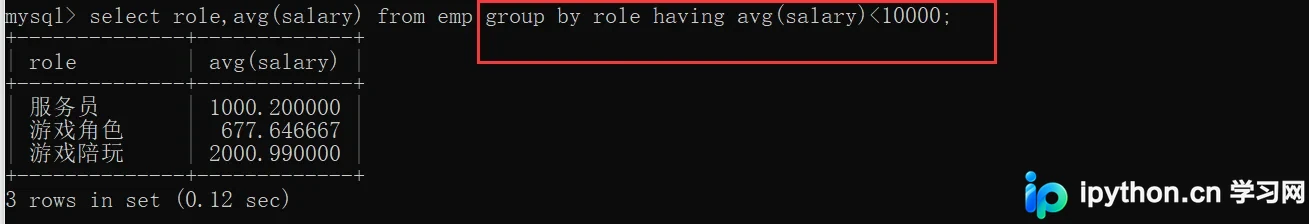
- HAVING:在分组之后执行。必须搭配
GROUP BY使用,用于对分组后的聚合结果(如平均薪资、总销量)进行条件筛选。
场景演示:基于角色薪资的平均值筛选
假设需要计算各角色的平均薪资,并希望排除特定人员或设定薪资门槛:
1. 使用 WHERE(分组前过滤):若要求排除“吴九”这个人,无论他薪资高低都不参与平均值的计算,应先用 WHERE 剔除该记录,再进行分组求均值。
2. 使用 HAVING(分组后过滤):若要求“只保留平均薪资在10000以下的角色”,这必须先算出每个角色的平均薪资后才能判断,因此必须使用 HAVING 进行后置筛选。
多表联合查询
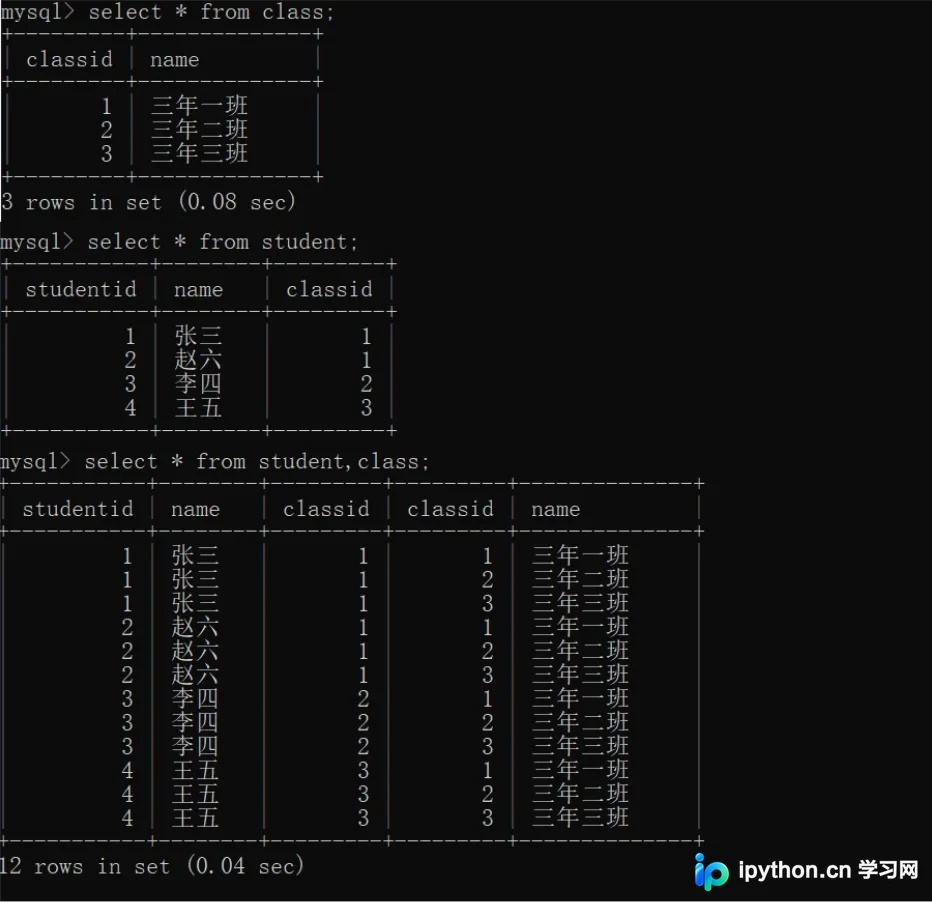
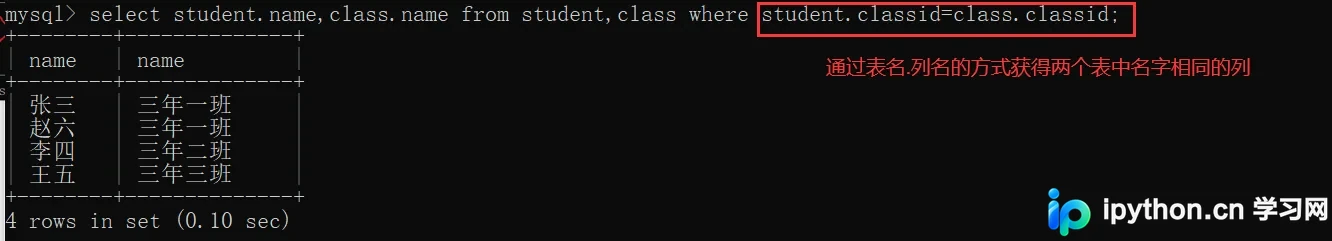
之前的查询均为单表操作。多表查询的核心基础是**笛卡尔积**,即将两个表的每条记录分别组合,生成新的记录集合。由于通常不需要所有组合,我们需要通过连接条件筛选有效数据。
连接方式详解
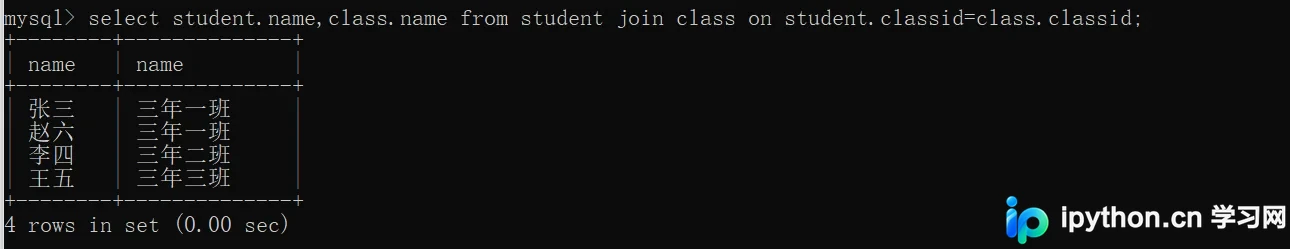
早期的老式写法是多表逗号分隔配合 WHERE 约束,这被称为“隐式内连接”。现代开发推荐使用标准的 JOIN ... ON 语法,语义更清晰且支持内外连接。
- 内连接 (INNER JOIN):
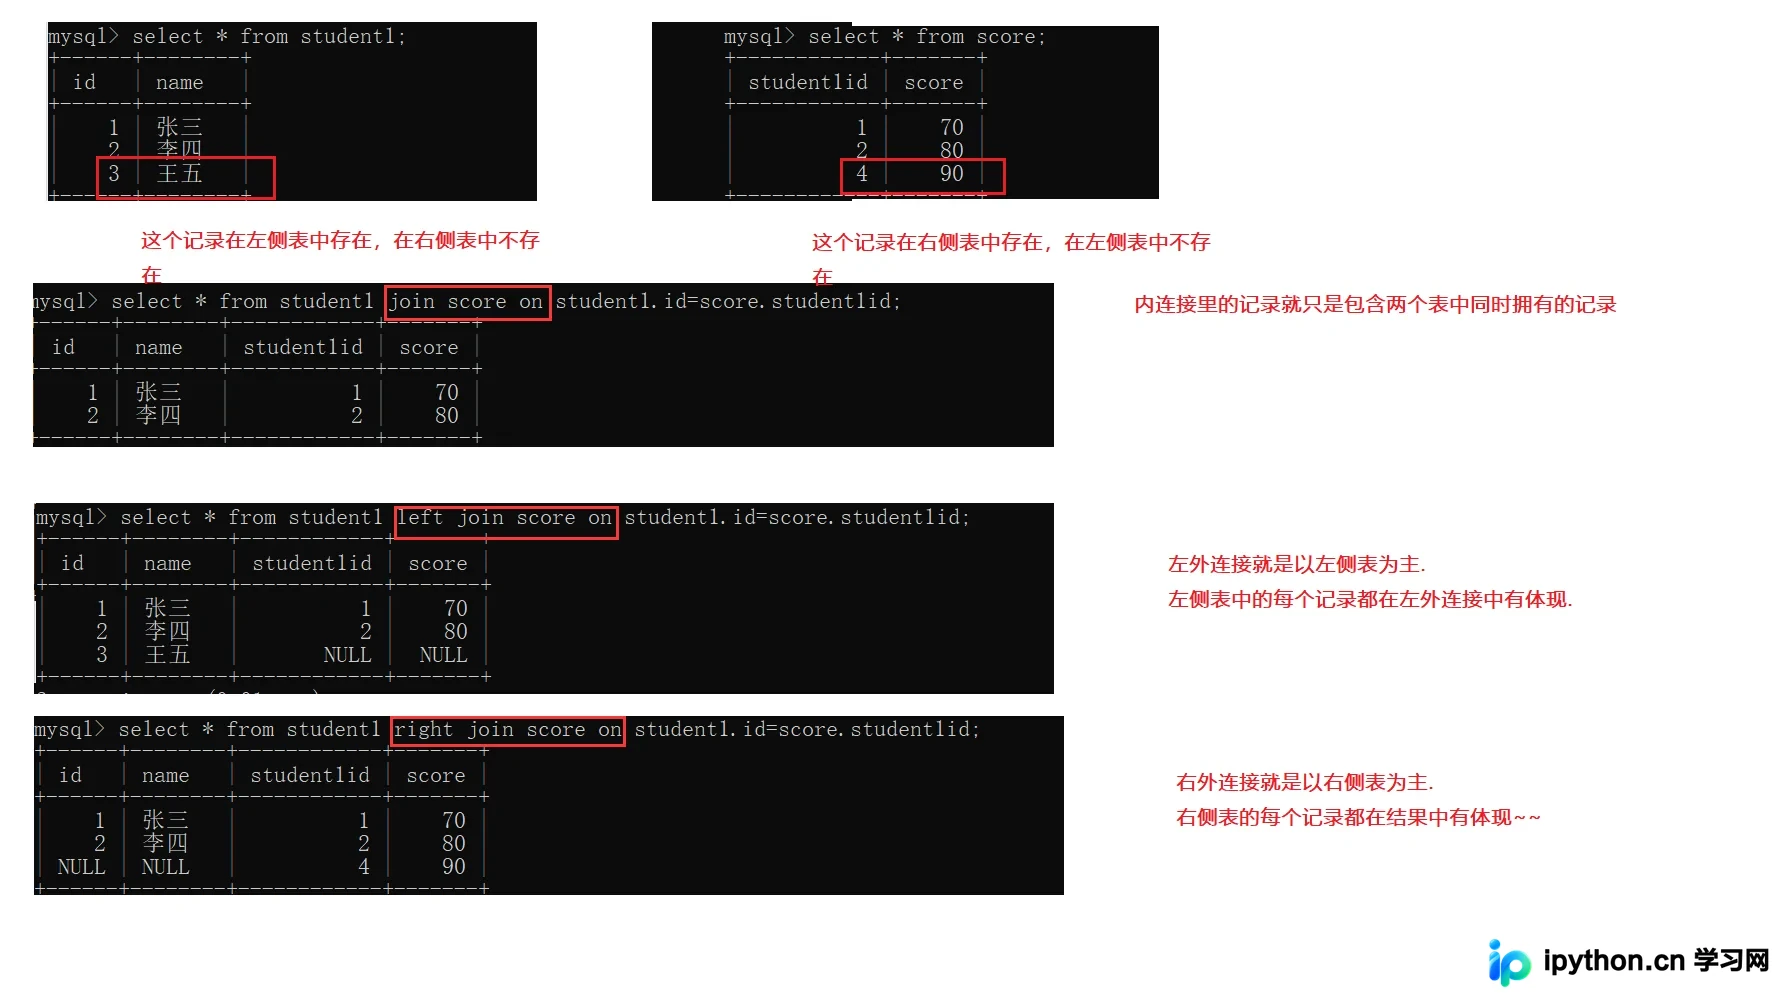
FROM 表1 INNER JOIN 表2 ON 条件。仅返回两个表中匹配成功的记录。INNER关键字可省略,默认即为内连接。 - 左外连接 (LEFT JOIN):
FROM 表1 LEFT JOIN 表2 ON 条件。以左表为主,返回左表所有记录,右表若无匹配则填 NULL。 - 右外连接 (RIGHT JOIN):
FROM 表1 RIGHT JOIN 表2 ON 条件。以右表为主,返回右表所有记录。
自连接
自连接是指同一张表自我关联。常出现在有层级关系或同表横向对比的场景中(如:比较同一学生不同科目分数)。
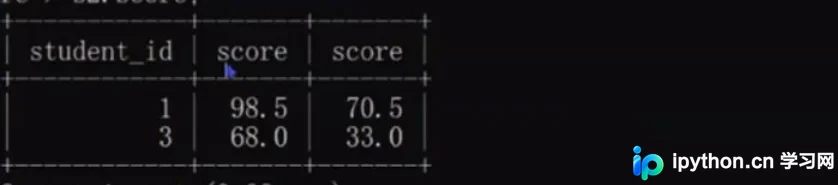
例如:查询所有“语文”成绩高于“数学”成绩的学生信息。思路是先将表取两个别名(s1代表语文,s2代表数学),通过学生ID建立关联并过滤对应课程ID。
SELECT s1.student_id, s1.score, s2.score
FROM score AS s1, score AS s2
WHERE s1.student_id = s2.student_id
  AND s1.course_id = 3   -- 假设3为语文
  AND s2.course_id = 1   -- 假设1为数学
  AND s1.score > s2.score;
结果集合并查询
当需要从多个查询中提取满足任一条件的数据时,可使用 UNION 操作符,或在简单条件下直接使用 OR。
UNION:自动去除结果集中的重复行。UNION ALL:保留所有记录,包含重复项,速度通常比UNION稍快。
示例:查询 ID小于3 或 名字为“英文”的课程。
-- 方式一:使用 UNION 拼接两个查询
SELECT * FROM course WHERE id < 3
UNION
SELECT * FROM course WHERE name='英文';
-- 方式二:使用 OR 逻辑词(简单条件推荐)
SELECT * FROM course WHERE id < 3 OR name='英文';
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









