

C语言文件操作之fread函数详解

本文详细解析 C 语言标准库中核心的 fread 函数,阐述其在二进制和文本文件读写中的应用。内容涵盖函数原型参数详解、大文件循环读取策略、缓冲区边界处理技巧以及 Windows 平台下文本与二进制模式的差异分析。
函数定义与作用
fread 函数主要用于将外部文件的数据块读取到内存缓冲区中。它与 fwrite 对应,两者既可用于二进制文件,也可用于文本文件。相比之下,getc/putc、fscanf/fprintf 等函数通常仅适用于文本流操作。其函数原型定义如下:
size_t fread(void *buffer, size_t size, size_t count, FILE *stream);void *buffer:目标内存地址,数据将被读入此缓冲区。size_t size:每个数据单元的字节数。若缓冲为char数组,通常为sizeof(char);若为int数组,则为sizeof(int)。size_t count:期望读取的最大单元个数。FILE *stream:指向已打开文件的指针。
返回值类型为 size_t,表示成功读取的实际单元数量。实际读取的总字节数为返回计数乘以单元大小。size 为 0 时行为未定义,应避免传入。
第1步:基本读取与缓冲区填充
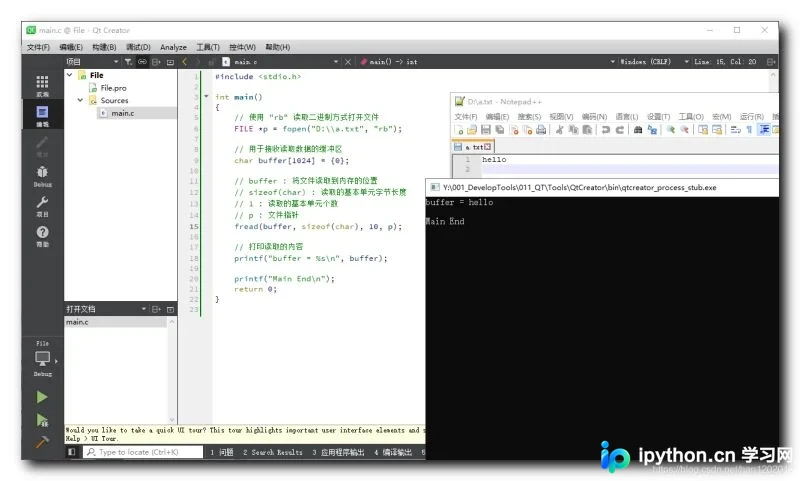
当一次性读取足够容纳整个文件的缓冲区时,可直接调用该函数。示例代码使用 "rb" 二进制模式打开文件,将读取到的内容打印输出:
#include <stdio.h>

int main()
{
    // 以二进制只读方式打开文件
    FILE *p = fopen("D:\\a.txt", "rb");
    if (!p) {
        perror("Open file failed");
        return 1;
    }

    // 初始化接收数据的缓冲区
    char buffer[1024] = {0};

    // 读取整个缓冲区大小的数据
    fread(buffer, sizeof(char), sizeof(buffer), p);

    printf("buffer = %s\n", buffer);

    fclose(p);
    printf("Main End\n");
    return 0;
}
受限缓冲区的循环读取策略
在处理体积庞大的文件时,受限于内存容量,无法一次性加载全部数据,此时需要通过循环配合 feof() 进行分块读取。但需注意,feof() 的正确判断时机会影响程序逻辑。
第2步:直接循环读取导致的乱码问题
若直接使用 while(!feof(p)) 结构并在循环内部执行读取,容易出现逻辑错误。例如在每次迭代前清空 char buffer[4] 缓冲区:
while(!feof(p)){
    memset(buffer, 0, sizeof(buffer));
    fread(buffer, sizeof(char), sizeof(buffer), p);
    printf("buffer = %s\n", buffer);
}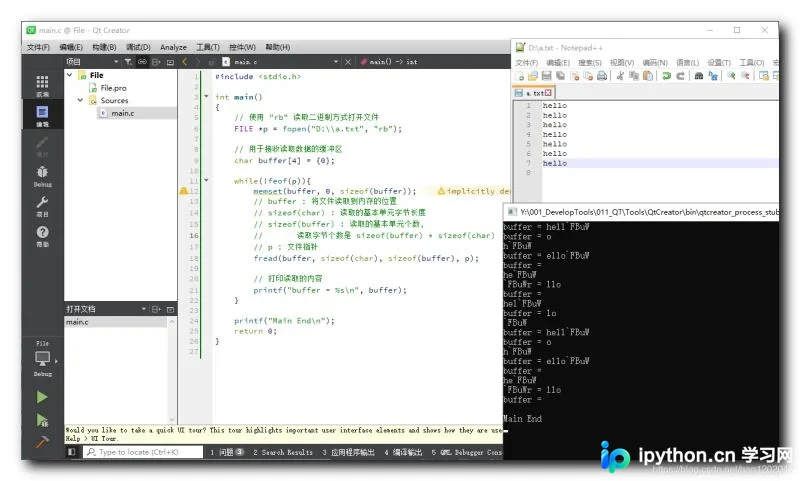
上述方式可能导致打印出的字符串包含非法字符形成乱码。原因是每次读取固定字节后可能截断末尾字节,使得缓冲区内不包含以 '\0' 结尾的有效字符串序列。
第3步:优化读取长度消除乱码
为确保每次读取的数据能被正确打印为字符串,可将读取的大小设定为 sizeof(buffer) - 1,预留一个字节存储空终止符:
while(!feof(p)){
    memset(buffer, 0, sizeof(buffer));
    fread(buffer, sizeof(char), sizeof(buffer) - 1, p);
    printf("buffer = %s\n", buffer);
}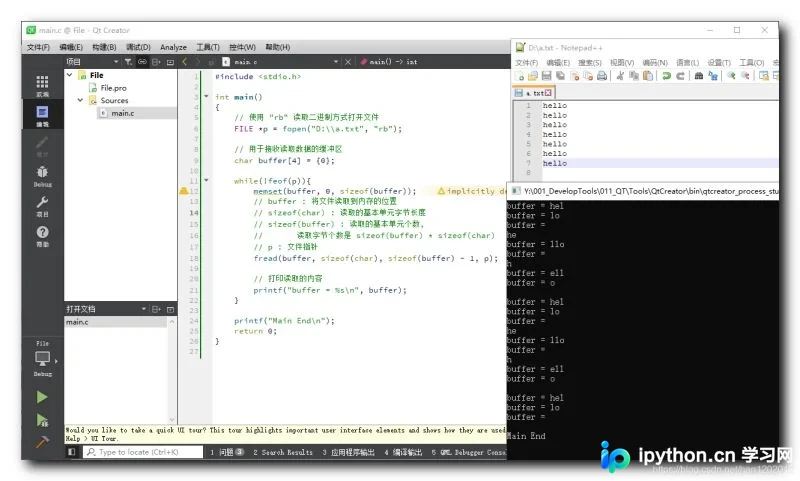
这样处理后,最后保留的空格正好作为结束标志,能够准确还原文本内容。但在严格的标准二进制读取场景下,仍需根据实际业务需求决定是强制对齐还是按字节偏移处理。
返回值与实际读取量的判断
理解返回值有助于检测异常中断或确认到达文件尾部。
第4步:小文件读取验证
如果文件剩余可用字节少于请求读取的总量,fread 仍会尝试读取直到 EOF 或达到请求上限。若分配了一个 1KB 的缓冲去读取只有几个字节的小文件:
size_t count = fread(buffer, sizeof(char), sizeof(buffer) - 1, p);
printf("buffer = %s , read count = %u\n", buffer, count);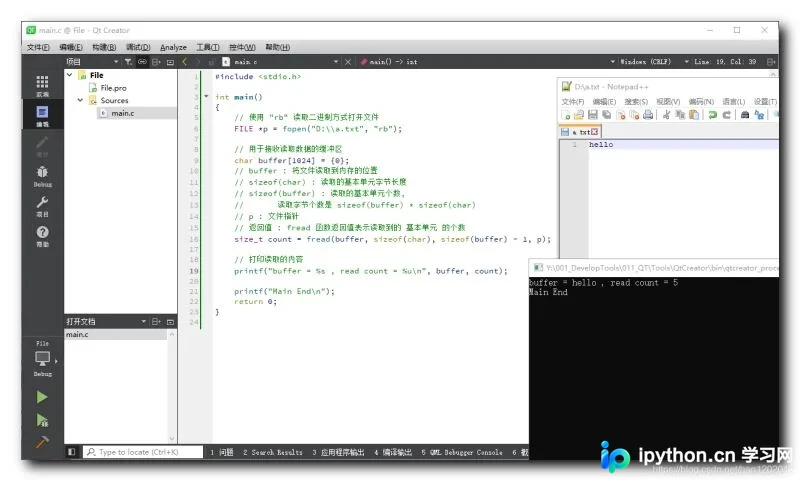
此时的返回值即为实际获取到的单元数量,可借此判断是否已经耗尽文件流。
第5步:单元不对齐导致的 0 读取
如果请求读取的基本单元大于文件剩余数据量且不能整除时,可能产生意外结果。例如下方代码试图按 4 字节单元(即 sizeof(int))读取仅有少量数据的文本:
// 假设 a.txt 内容极短,不足 int 宽度
size_t count = fread(buffer, sizeof(int), sizeof(buffer) - 1, p);
printf("buffer = %s , read count = %u\n", buffer, count);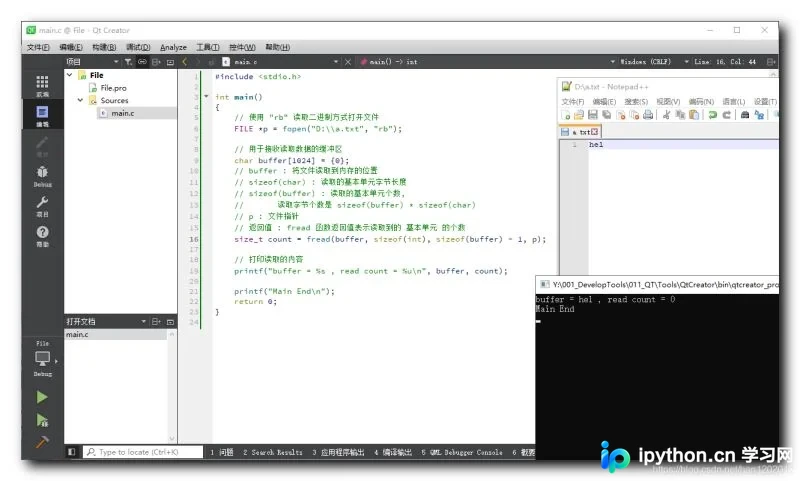
由于剩余数据不够构成完整的第一个单元,此次调用成功读取的单元数为 0。
第6步:重复读取空文件状态
一旦文件指针抵达末端,后续再发起读取请求同样会返回 0:
count = fread(buffer, sizeof(char), sizeof(buffer) - 1, p); // 第一次
printf("First fread : read count = %u\n", count);

// 再次调用
size_t second_count = fread(buffer, sizeof(int), sizeof(buffer) - 1, p);
printf("Second fread : read count = %u\n", second_count);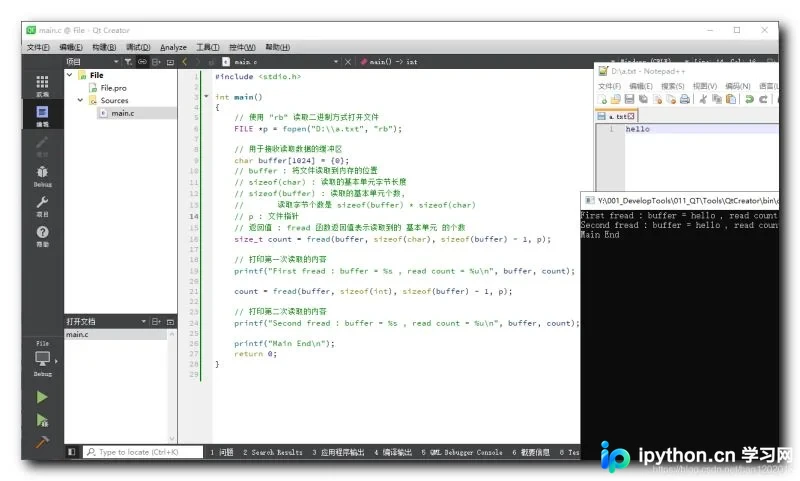
Windows 下的 “r” 与 “rb” 模式区别
在 Linux / Unix 环境中,文本文件和二进制文件没有本质差异。然而,在 Windows 平台上,两种打开方式对特定控制字符进行了特殊处理。
第7步:二进制模式 (“rb”) 的行为
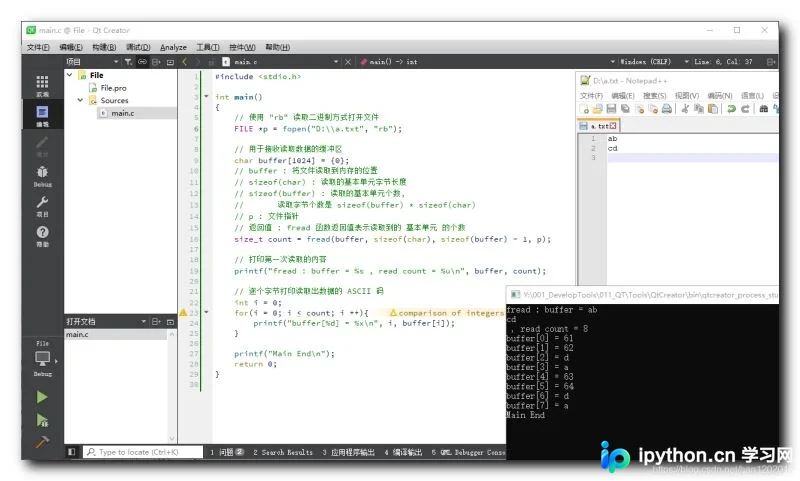
通过 fopen(..., "rb") 打开后,换行符被完整保留为 "\r\n"(回车+换行),ASCII 值分别是 0x0d 和 0x0a:
FILE *p = fopen("D:\\a.txt", "rb");
...
fread(buffer, sizeof(char), sizeof(buffer) - 1, p);
// 遍历打印每个字节的十六进制 ASCII 编码
fread : buffer = ab cd , read count = 8 buffer[0] = 61 buffer[1] = 62 buffer[2] = d buffer[3] = a ...
第8步:文本模式 (“r”) 的行为
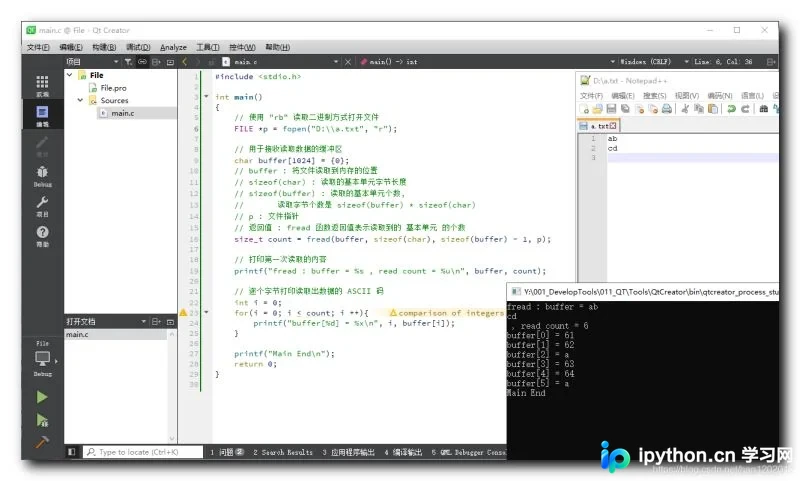
而使用 fopen(..., "r") 时,C 运行时库会自动将 "\r\n" 转换替换为单个 "\n",因此读取的内容长度和数值均会发生变化:
FILE *p = fopen("D:\\a.txt", "r");
...
fread(buffer, sizeof(char), sizeof(buffer) - 1, p);
fread : buffer = ab cd , read count = 6 buffer[0] = 61 buffer[1] = 62 buffer[2] = a // 原 0x0d 被吞掉,此处变为 0x0a (LF) ...
总结
在使用 fread 时,务必注意缓冲区溢出风险,特别是当涉及变长文件或未知长度数据时。正确处理 Windows 平台的格式转换差异也是开发跨平台程序的关键点。以上就是 C 语言文件操作中关于 fread 函数的详细内容,更多关于 C 语言文件读写与流控制方面的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









