

Java HashMap底层实现原理与元素添加流程详解

本文详细解析了Java中HashMap的底层数据结构演变及核心操作流程。重点对比了JDK 1.7和JDK 1.8的区别,阐述了数组加链表(或红黑树)的实现机制。通过源码分析,深入梳理了put方法中的哈希计算、碰撞处理、链表转红黑树的阈值判定以及扩容等关键步骤,帮助开发者掌握其内部运作逻辑。
HashMap 底层架构演进
HashMap 是 Java 中最常用且高频考查的数据结构之一。其底层实现在不同的 JDK 版本中发生了显著变化,理解这种演变对于深入掌握集合框架至关重要。
从 JDK 1.7 到 JDK 1.8 的变迁
在 JDK 1.7 中,HashMap 采用 数组 + 链表 的结构来存储数据。当发生哈希冲突时,新元素会被追加到链表尾部(头插法或尾插法视具体实现细节而定,但核心为链式解决冲突)。
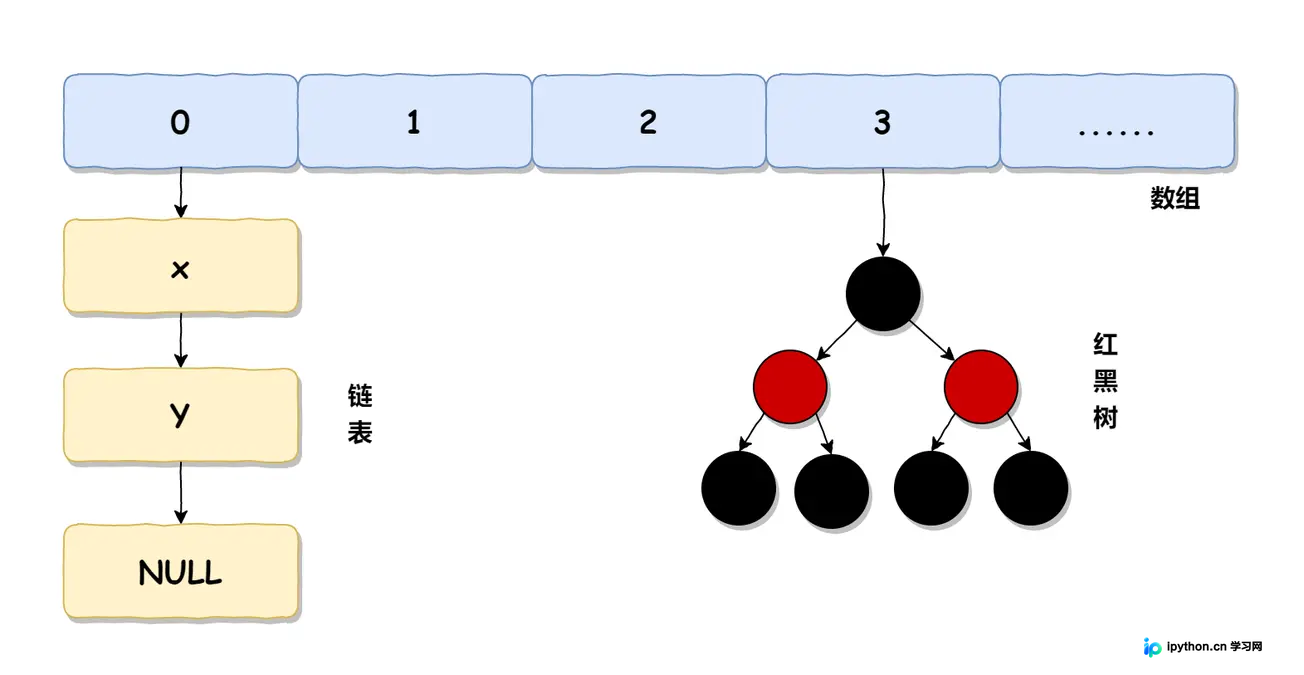
在 JDK 1.8 及更高版本中,HashMap 采用了 数组 + 链表 + 红黑树 的混合结构。这是为了优化在最坏情况下的查询性能。当链表长度达到一定阈值时,链表会转换为红黑树,将时间复杂度从 O(n) 降低至 O(logn)。
核心组件与数据存储
JDK 1.8 版本的底层结构如下图所示:
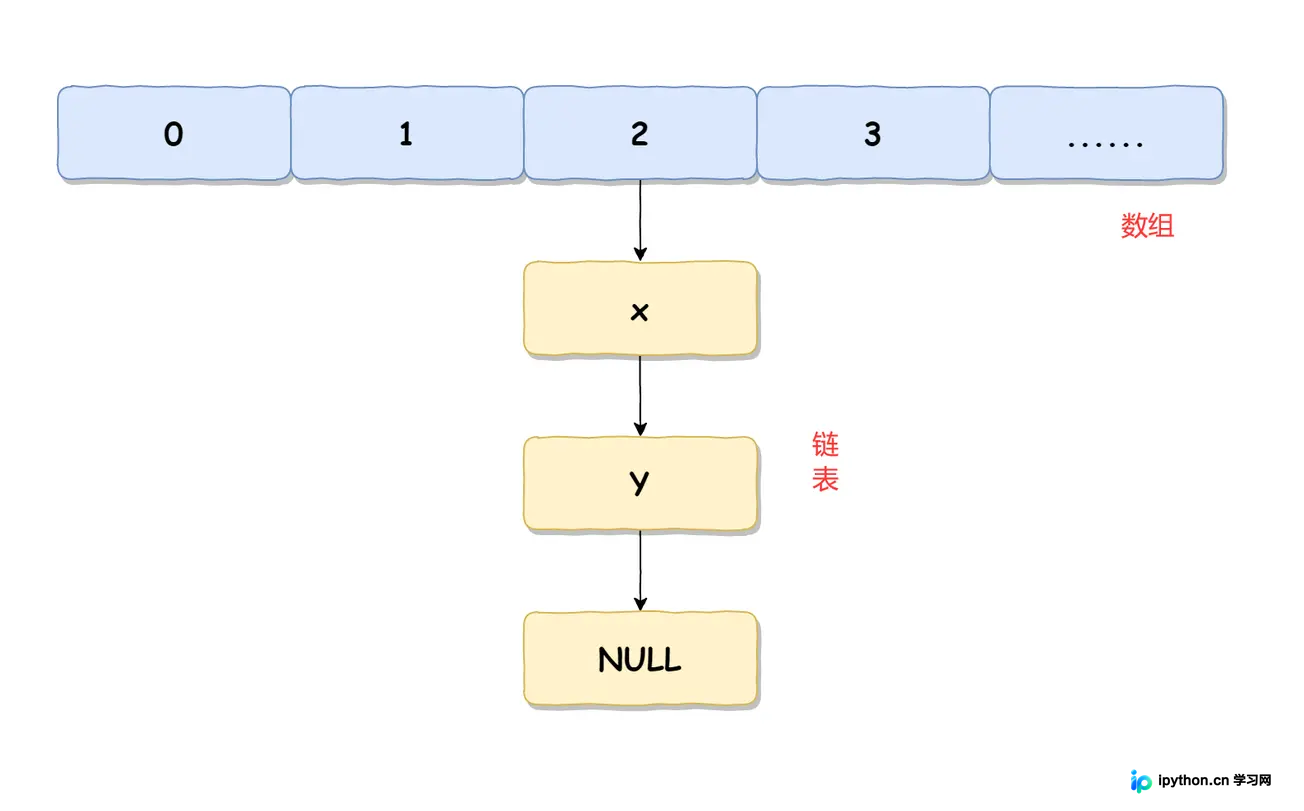
与之对应的 JDK 1.7 版本结构如下:
在 HashMap 中,每个存储单元被称为一个“节点”(Node),它是构成哈希桶的基本单位。每个 Node 包含以下四个核心属性:
hash:键值的哈希码,用于快速定位和判断相等性。key:存储的键对象。value:存储的值对象。next:指向下一个节点的指针,用于处理哈希冲突时的链表连接。
元素添加(put)流程解析
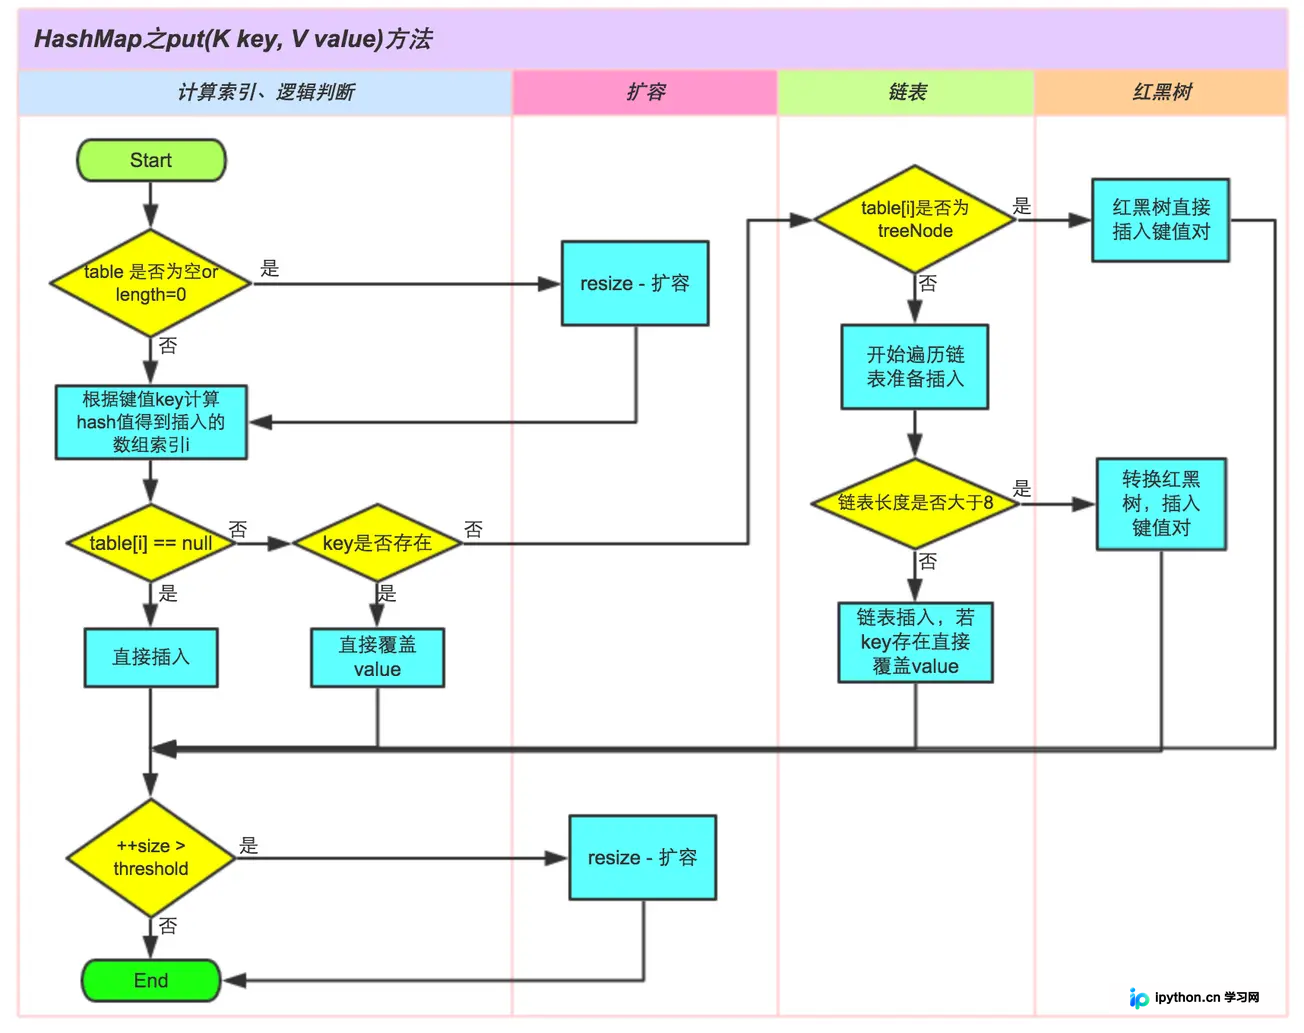
向 HashMap 中添加元素的核心方法是 put(K key, V value)。该过程涉及哈希计算、位置寻址、冲突处理等多个环节。以下是基于 JDK 1.8 源码的详细执行步骤:
第 1 步:初始化与空表检查
调用 putVal 方法进行实际插入。首先检查底层的哈希表(table)是否为空或长度为 0。如果是,则调用 resize() 进行初始化,创建默认容量(通常为 16)的数组空间。
第 2 步:定位数组索引并直接插入
计算出待插入元素的哈希值后,利用位运算 (n - 1) & hash 确定其在数组中的索引位置 i。
如果 table[i] 为空(即该位置没有发生哈希冲突),则直接创建一个新节点并将其赋值给 table[i],插入完成。
第 3 步:处理哈希冲突
如果目标索引位置不为空,说明发生了哈希冲突,此时需要判断该位置的节点类型:
- 覆盖旧值:如果该位置首节点与新插入节点的 key 相同(
hashCode相同且equals比较为真),则替换该节点的值(Value)。这由p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))逻辑控制。 - 红黑树插入:如果该节点是
TreeNode类型(即已转化为红黑树),则调用putTreeVal方法按树规则插入。 - 链表插入与转换:如果是普通链表,则从头开始遍历。若遍历过程中发现相同 Key 则退出循环;若找到链表尾部仍未发现重复 Key,则在末尾追加新节点。
注意树化条件:在将节点加入链表后,如果链表长度binCount超过临界值TREEIFY_THRESHOLD - 1(即长度为 8),并且当前数组长度小于 64,会先尝试扩容;只有当数组长度达到 64 以上时,才会真正调用treeifyBin将链表转换为红黑树。
第 4 步:计数与扩容判断
成功插入新节点后,修改计数器 modCount。接着检查当前元素数量(size)是否超过了设定的阈值(threshold,默认为容量 × 0.75)。如果超出阈值,则触发 resize() 方法进行扩容,通常是翻倍原数组容量,并重新计算所有元素的哈希位置。
整个插入过程的流程图如下所示:
为什么引入红黑树?
在 JDK 1.7 中,如果大量数据的 Hash 码分布不均导致集中在同一个索引位置,链表会变得非常长,使得查询和插入操作的时间复杂度退化为 O(n)。这在数据量巨大时严重影响性能。
为解决此问题,JDK 1.8 引入了红黑树作为备选方案。红黑树作为一种自平衡二叉查找树,其查询、插入和删除的时间复杂度稳定在 O(log n)。虽然构建红黑树有一定开销,但在极端情况下能显著优于链表,从而保障了 HashMap 的整体性能稳定性。
哈希算法的关键实现
为了尽量减少哈希冲突,JDK 1.8 对键(Key)的哈希算法进行了优化。其源码逻辑如下:
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
算法解读:
该方法首先获取 Key 原有的 hashCode(),然后将其无符号右移 16 位,并与自身进行异或(XOR)运算。由于 Java 的 int 类型占 32 位,右移 16 位刚好是高位与低位各占一半。这种高低位混合的操作,增加了哈希值的随机性,使得即使HashCode本身差异不大,经过异或运算后的最终索引也能更均匀地分布在数组空间中。
总结
HashMap 的底层实现经历了从“数组+链表”到“数组+链表+红黑树”的演进。在 JDK 1.8 中,通过结合红黑树的优势,有效解决了哈希冲突严重时的性能瓶颈问题。在元素添加流程中,系统会智能判断是否需要树化以及何时触发扩容。掌握这些底层逻辑,不仅有助于应对技术面试,更能指导在实际开发中合理设置初始容量与加载因子。
以上就是关于Java中HashMap底层实现原理与元素添加流程的详细内容,更多关于Java中的HashMap应用技巧的资料请关注本站其它相关文章!免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









