

MySQL 数据归档神器 pt-archiver 使用指南

在 MySQL 日常运维中,历史数据清理与迁移是高频需求。手动执行删除不仅存在锁表风险,且在大事务场景下容易导致主从延迟。本文介绍强大的开源归档工具 pt-archiver,通过源码级原理解析与多种参数组合的性能对比,演示如何实现安全、可控的大规模数据归档与清理。
什么是 pt-archiver
pt-archiver 是 Percona Toolkit 套件中的核心组件之一。Percona Toolkit 由 Percona 公司维护,专为 MySQL 和 MongoDB 设计,其中包含 pt-online-schema-change(在线 DDL)和 pt-table-checksum(一致性校验)等知名工具。
掌握该工具的使用,是 DBA 实现生产环境安全维护的关键技能。
安装与环境准备
Percona Toolkit 官方提供各发行版的软件包。推荐使用 Linux Generic 二进制版本,无需复杂编译即可运行。
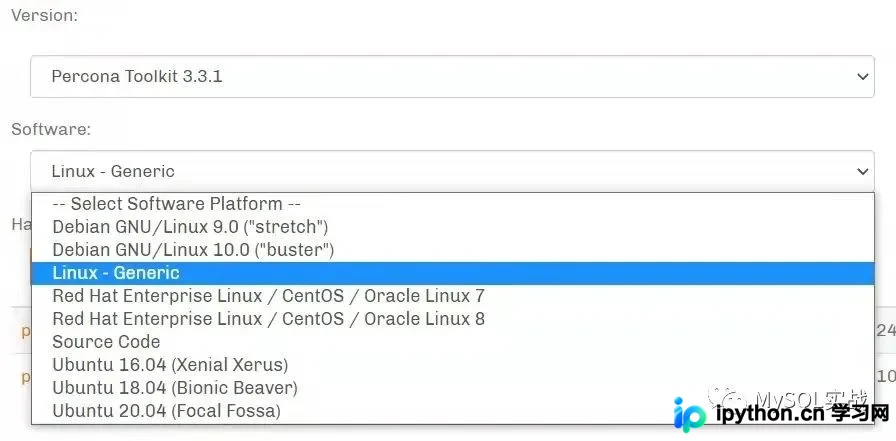
以 Linux Generic 为例,安装步骤如下:
# 1. 下载与解压
# cd /usr/local/
wget https://downloads.percona.com/downloads/percona-toolkit/3.3.1/binary/tarball/percona-toolkit-3.3.1_x86_64.tar.gz --no-check-certificate
tar xvf percona-toolkit-3.3.1_x86_64.tar.gz
cd percona-toolkit-3.3.1

# 2. 安装依赖 (CentOS/RHEL)
yum install perl-ExtUtils-MakeMaker perl-DBD-MySQL perl-Digest-MD5

# 3. 编译安装
perl Makefile.PL
make
make install
简单入门与基础概念
最简单的用法是将源库全量数据迁移至目标库,同时删除源数据:--where "1=1" 表示选中所有行。
pt-archiver \
--source h=192.168.244.10,P=3306,u=pt_user,p=pt_pass,D=employees,t=departments \
--dest h=192.168.244.128,P=3306,u=pt_user,p=pt_pass,D=employees,t=departments \
--where "1=1"
D SN 格式说明
--source 和 --dest 后跟的是 DSN (Data Source Name),即连接参数缩写:
D: 库名t: 表名h: 主机 IPP: 端口u/p: 用户名/密码
实现原理
分析 pt-archiver 的运行日志可以发现,其核心逻辑采用类似分布式系统“两阶段提交”的思想,确保数据安全:
- 查询与传输:利用主键索引有序读取一行(Source),插入到目标库(Dest),成功后 Commit 目标库。
- 安全删除:再次查询确认,然后对 Source 执行基于主键的 DELETE,最后 Commit。
关键点:即使指定条件无索引,由于强制按主键排序扫描(ORDER BY Primary Key)和定位删除,不会产生全表扫描或长时间锁表。
批量归档操作
单条 INSERT/DELETE 在大量数据时效率极低。在线上环境中应使用批量模式:
pt-archiver \
--source ... \
--dest ... \
--where "1=1" \
--bulk-delete --limit 1000 --commit-each --bulk-insert
关键参数解析:
--bulk-delete:使用单次 SQL 语句批量删除满足条件的行。--limit 1000:每批次处理 1000 条记录。--commit-each:仅对当前批次执行一次 Commit 操作,减少 IO 开销。--bulk-insert:将数据写入临时文件后,使用高效的LOAD DATA INFILE导入目标库。
注意:
1. 启用 --bulk-insert 需确保目标库开启了 local_infile=ON。
2. 若发生主键冲突等错误,LOAD DATA INFILE 默认可能不直接报错中断,需谨慎校验环境。
不同参数的速度对比
基于 20 万行数据的测试结果显示,参数的选择对耗时影响巨大:
| 参数组合策略 | 大致耗时 (s) |
|---|---|
| 逐行处理 (默认慢速模式) | 约 850.0 |
| 只加批量删除,不加逐批提交 | 约 422.0 |
+ --commit-each (批量读删+单批提交) |
约 46.6 |
+ --bulk-insert (最高效) |
约 6.5 ~ 7.6 |
结论:--bulk-delete --limit 1000 --commit-each --bulk-insert 是当前最高效的组合。空事务(Bulk Insert 但不 commit-each)依然需要提交数千次,代价高昂。
常见应用场景与用法
(1)纯删除模式(清理历史数据)
如果不需要保留副本,直接使用归档工具进行物理删除,命令需添加 --purge 标志:
pt-archiver --source h=... --where "created_at < '2023-01-01'" --purge --primary-key-only --bulk-delete --limit 1000 --commit-each--primary-key-only 使得 SELECT 只查主键,极大地降低了查询带宽与内存消耗。
(2)归档导出为本地 CSV 文件
若不写入另一张 MySQL 表,可导出为标准 CSV:
pt-archiver --source h=... --where "1=1" --bulk-delete \
--file '/tmp/%Y-%m-%d-%D.%t.csv'
文件名支持格式化占位符,如 %Y(年)、%D(库名)、%t(表名)。文件可通过标准 SQL 加载入库。
如何避免造成主从复制延迟
大量的 DELETE 操作极易导致 Binlog 积压从而引发从库延迟。pt-archiver 支持自动限速:
--check-slave-lag h=192.168.244.20,P=3306,u=...,p=... --max-lag 1s当从库延迟超过设定的阈值(默认 1 秒)时,程序会自动暂停工作,等待从库追平,恢复后再继续。可多次使用该参数监控多个从节点。
总结与安全建议
--bulk-insert 虽然极速,但吞没了详细的错误堆栈。相比之下,默认的逐行 INSERT 能够明确提示主键冲突或类型转换错误。因此,在生产高危操作中,最稳妥的流程是:先归档(不删) → 验证数据一致性(pt-table-sync) → 再确认删除。配合严格的字符集与列名校验 (--check-charset/--check-columns),能最大程度降低误操作风险。
以上就是 MySQL 数据库中使用 pt-archiver 进行数据归档的实现方法,更多关于数据库维护优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









