

Go语言Goroutine并发原理与GMP调度模型详解

发布时间:2026-10-16| 6人浏览过
Go语言凭借高效的并发能力成为后端开发首选。本文深入剖析Goroutine底层原理,详解GMP调度模型运作机制,并通过代码实例演示如何避免闭包陷阱及使用sync.WaitGroup确保线程安全同步。
一、基础概念与并发优势
第1步:理解并发与并行的区别
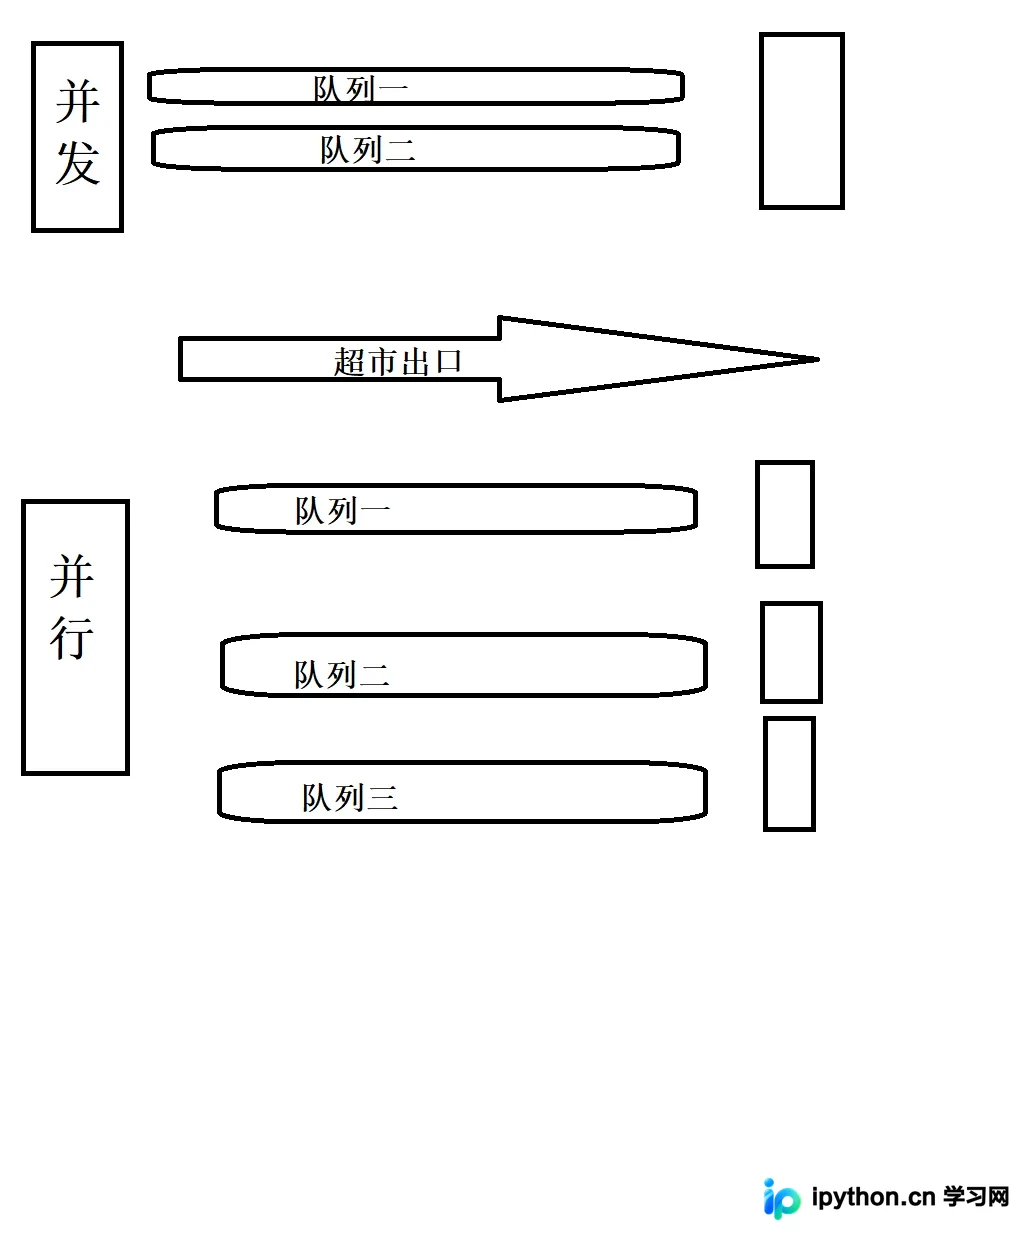
区分“并发”与“并行”是理解Go语言并发的基础:
- 并发(Concurrency):指同一时间段内处理多个任务。例如单核CPU通过快速切换时间片来轮流执行多个任务,给用户造成同时处理的错觉。
- 并行(Parallelism):指同一时刻物理上同时执行多个任务。例如多核CPU同时运行多个线程。
第2步:Go与Java线程模型的差异分析
Go语言在并发资源消耗上的优势,主要源于其用户态线程设计:
- Java线程模型:主要依赖操作系统内核线程。创建和切换线程开销较大,资源占用固定且较高。
- Go Goroutine:属于用户态线程。初始栈大小仅为2KB,可根据需要动态扩张至1GB。这种轻量级特性使得Go可以轻松创建数十万甚至百万级的Goroutine,而无需依赖庞大的JVM环境。
二、GMP调度模型原理解析
第3步:掌握G、M、P三者角色定义
Go语言的调度器(Scheduler)通过GMP模型将Goroutine映射到系统线程上运行:
- G (Goroutine):代表一个具体的协程。包含执行的函数、参数以及上下文切换所需的寄存器信息(如SP、PC)。在源码中对应
runtime.g结构体。 - M (Machine):代表操作系统内核线程。由操作系统管理和调度,负责真正执行G中的代码。Go调度器最多可创建约10000个M,源码对应
runtime.m。 - P (Processor):逻辑处理器。它是连接G和M的桥梁,维护本地 runnable G队列。
- P的数量由环境变量GOMAXPROCS决定。
- Go 1.5之后,默认值为当前系统的CPU逻辑核心数;此前默认为1。
- 可通过runtime.GOMAXPROCS(n)显式指定P的数量。
三、实战避坑与同步控制
第4步:识别Goroutine闭包变量捕获陷阱
在使用匿名函数启动Goroutine时,若直接引用循环变量,会因所有Goroutine共享同一变量地址而导致结果异常。
// 错误示范:所有输出可能为相同的最后一个循环值
for i := 0; i < 10; i++ {
    go func() {
        fmt.Println(i) // i 会被竞争修改
    }()
}修正方法:在循环内部将变量值传递给匿名函数参数,或创建局部副本:
for i := 0; i < 10; i++ {
    val := i // 创建副本
    go func(v int) {
        fmt.Println(v)
    }(val)
}
第5步:使用sync.WaitGroup实现线程同步
为防止主进程提前结束导致未完成的Goroutine被强制终止,需使用sync.WaitGroup进行等待同步。
关键步骤如下:
- 初始化:声明
var wg sync.WaitGroup。 - 增加计数:在主线程每次启动新Goroutine前调用
wg.Add(1)。 - 减少计数:在每个Goroutine结束时调用
wg.Done(),推荐使用defer wg.Done()确保必定执行。 - 阻塞等待:主线程调用
wg.Wait(),直到计数器归零后继续执行。
package main

import (
	"fmt"
	"math/rand"
	"sync"
	"time"
)

var wg sync.WaitGroup

func worker(id int) {
	defer wg.Done()
	// 模拟异步耗时操作
	sleepTime := time.Duration(rand.Intn(3)) * time.Second
	time.Sleep(sleepTime)
	fmt.Printf("Worker %d completed\n", id)
}

func main() {
	startCount := 10
	wg.Add(startCount)

	for i := 0; i < startCount; i++ {
		go worker(i)
	}

	wg.Wait()
	fmt.Println("All goroutines finished.")
}
通过以上原理梳理与代码实践,开发者可以更稳健地利用Go语言的高并发特性构建高性能后端服务。
以上就是Go语言Goroutine并发底层原理与GMP调度模型的详细内容,更多关于Go语言并发编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









