

C++中函数重载详解:原理与编译器名字修饰机制

C++中的函数重载允许在同一作用域内定义多个同名但参数列表不同的函数。本文将从概念出发,结合代码示例与编译器底层机制,解析为何C++能支持重载而C语言不能,重点介绍GCC下的名字修饰规则。
函数重载的核心概念
函数重载是C++中的一种重要特性,指在同一作用域中声明多个功能相似的同名函数。构成重载必须满足以下条件:
- 函数名相同;
- 参数列表不同,包括:
参数个数、参数类型或参数顺序至少有一项存在差异。
这一机制主要用于处理实现逻辑类似但数据类型不同的场景,例如针对不同数值类型(int, float等)执行相同的数学运算。
函数重载的实际应用
第1步:基于参数类型不同的重载
当同名函数拥有不同的参数类型时,编译器会在调用时根据实参类型自动匹配最合适的函数版本。例如,定义两个名为 Add 的函数,一个接受 int 和 int,另一个接受 double 和 double。
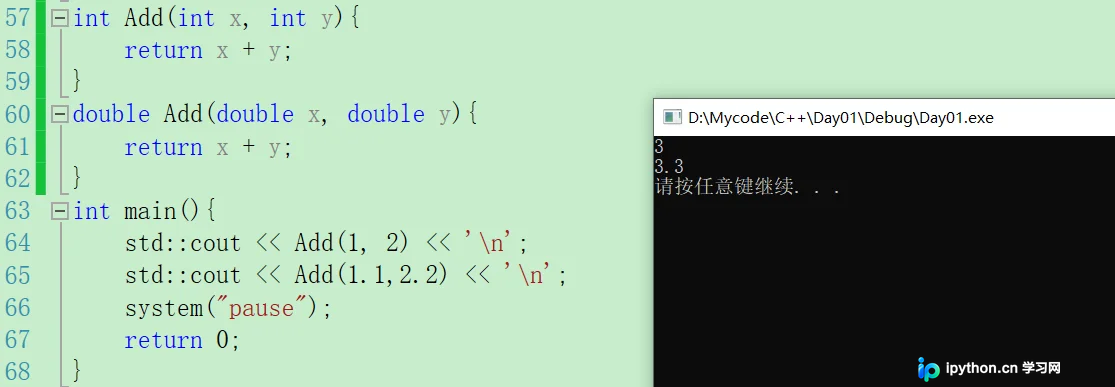
在调用 Add(1, 2) 时,编译器会识别出整数类型并匹配第一个函数;调用 Add(1.1, 2.2) 时则匹配第二个函数。这种自动匹配极大地简化了代码结构,避免了命名冲突。
第2步:基于参数个数不同的重载
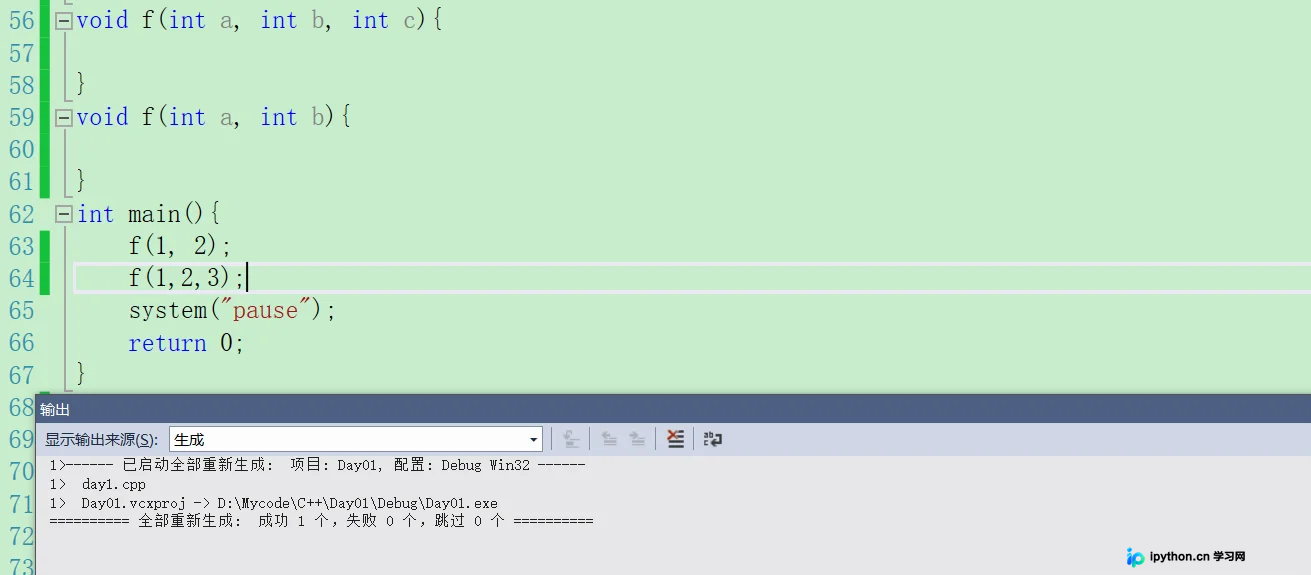
除了类型,参数的数量也是区分重载的重要依据。即使参数类型相同,只要参数个数不同,即为不同的重载函数。以下代码展示了两种参数个数的重载形式,均能正常编译和执行。
第3步:避免缺省参数导致的歧义
在使用缺省参数时需谨慎,否则可能导致“调用不明确”错误。如果在上述第二个例子中,将其中一个函数的最后一个参数设为缺省参数,此时若只传递两个参数,编译器将无法确定应调用哪个函数。
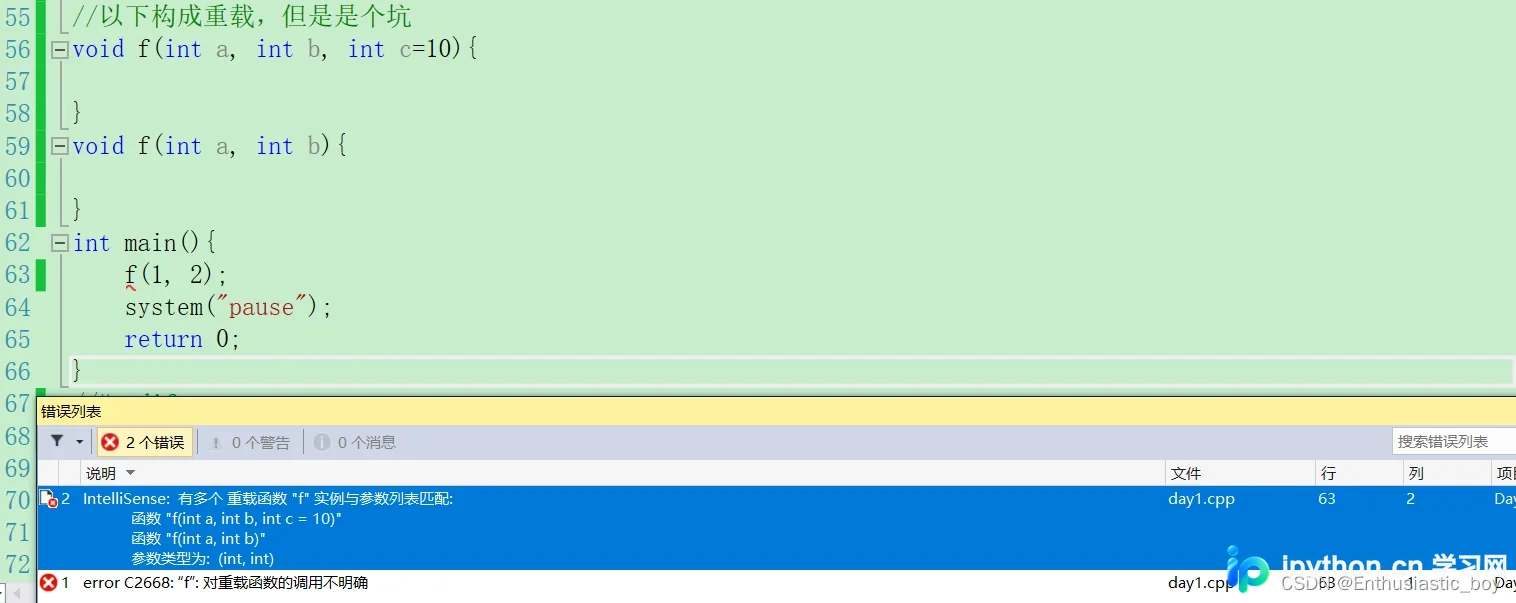
虽然这两个函数在语法上符合重载的定义(参数个数/类型组合不同),但在实际调用点,由于缺省参数的存在,调用方提供的实参既可以是“非重载函数”的参数集,也可以是“重载函数+缺省值”的参数集。编译器无法二选一,从而报错。解决此问题的方法是明确参数列表,避免在重载组合中使用可能产生歧义的缺省参数。
为什么C++支持重载而C语言不支持?
理解这一问题的关键在于程序构建的流程。一个C/C++程序从源码到可执行文件需经历:预处理、编译、汇编、链接四个阶段。
在多文件项目中,如果 a.cpp 调用了 b.cpp 中定义的函数,在编译 a.cpp 生成目标文件 a.o 后,a.o 中并不包含该函数的具体地址,因为函数定义在 b.cpp 生成的 b.o 中。链接器 的作用正是在此时介入,它扫描 a.o 对未定义符号的引用,并在 b.o 的符号表中查找对应的函数地址,最终将二者链接在一起。
问题在于:链接器如何识别哪个函数地址属于哪个源函数名称?这就涉及到了函数名修饰规则(Name Mangling):
Linux环境下的GCC vs G++演示
Windows下VS编译器的修饰规则较为复杂且晦涩,而在Linux环境下,GCC/G++的修饰规则相对直观,更适合用来理解底层原理。我们通过实验观察同一个简单函数在不同编译器下的行为。
第4步:观察C语言编译器的行为
当使用C语言编译器(如 gcc)编译包含同名但不同参函数的代码时,或者仅编译常规C函数时,链接器看到的函数名保持不变。
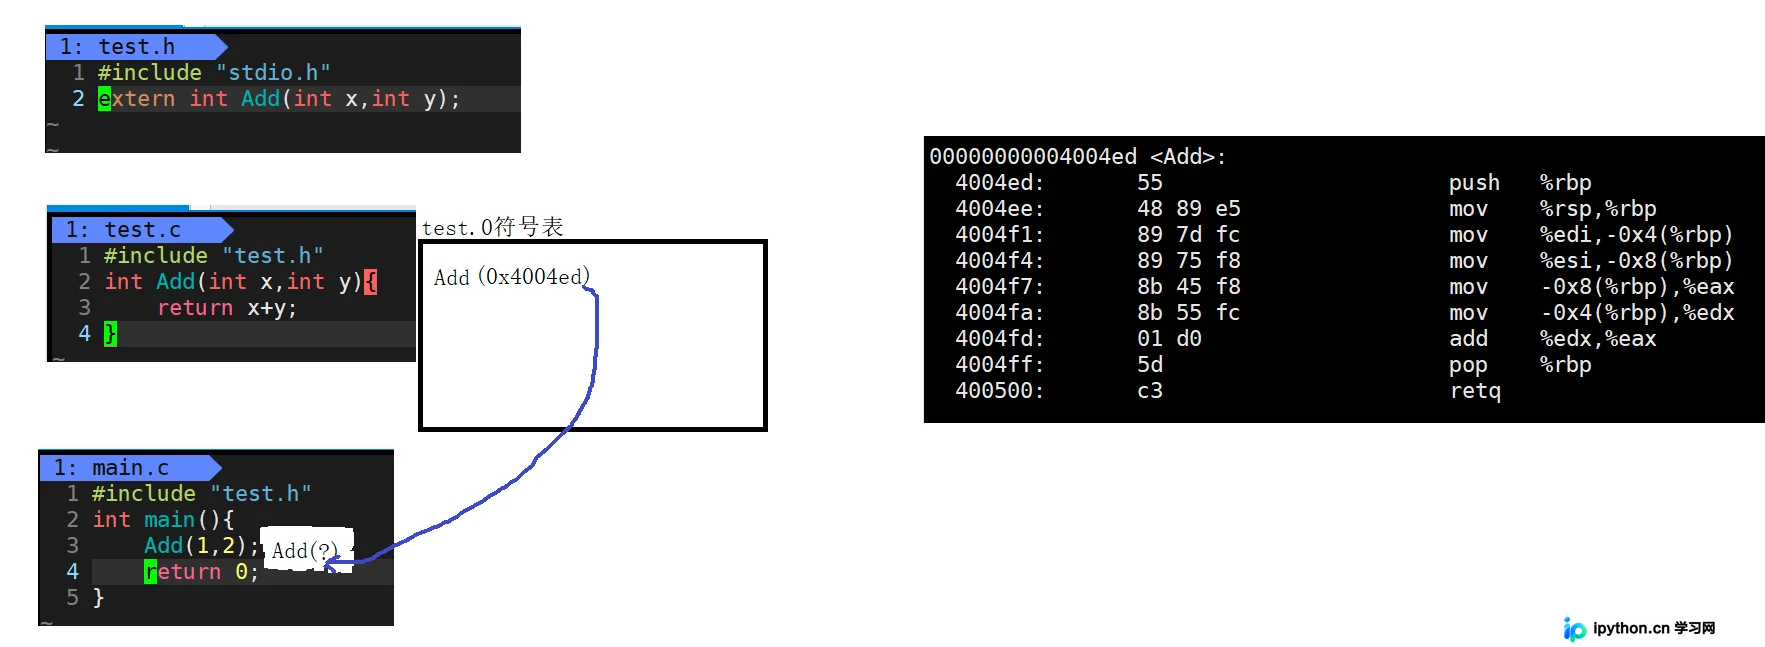
这意味着,如果使用C编译器尝试实现重载,所有同名函数的内部标识符都是完全一样的。链接器无法区分这些同名函数,因此C语言天然不支持函数重载。
第5步:观察C++编译器的名字修饰机制
当使用C++编译器(如 g++)编译同名但参数不同的函数时,编译器会在内部对函数名进行“修饰”。
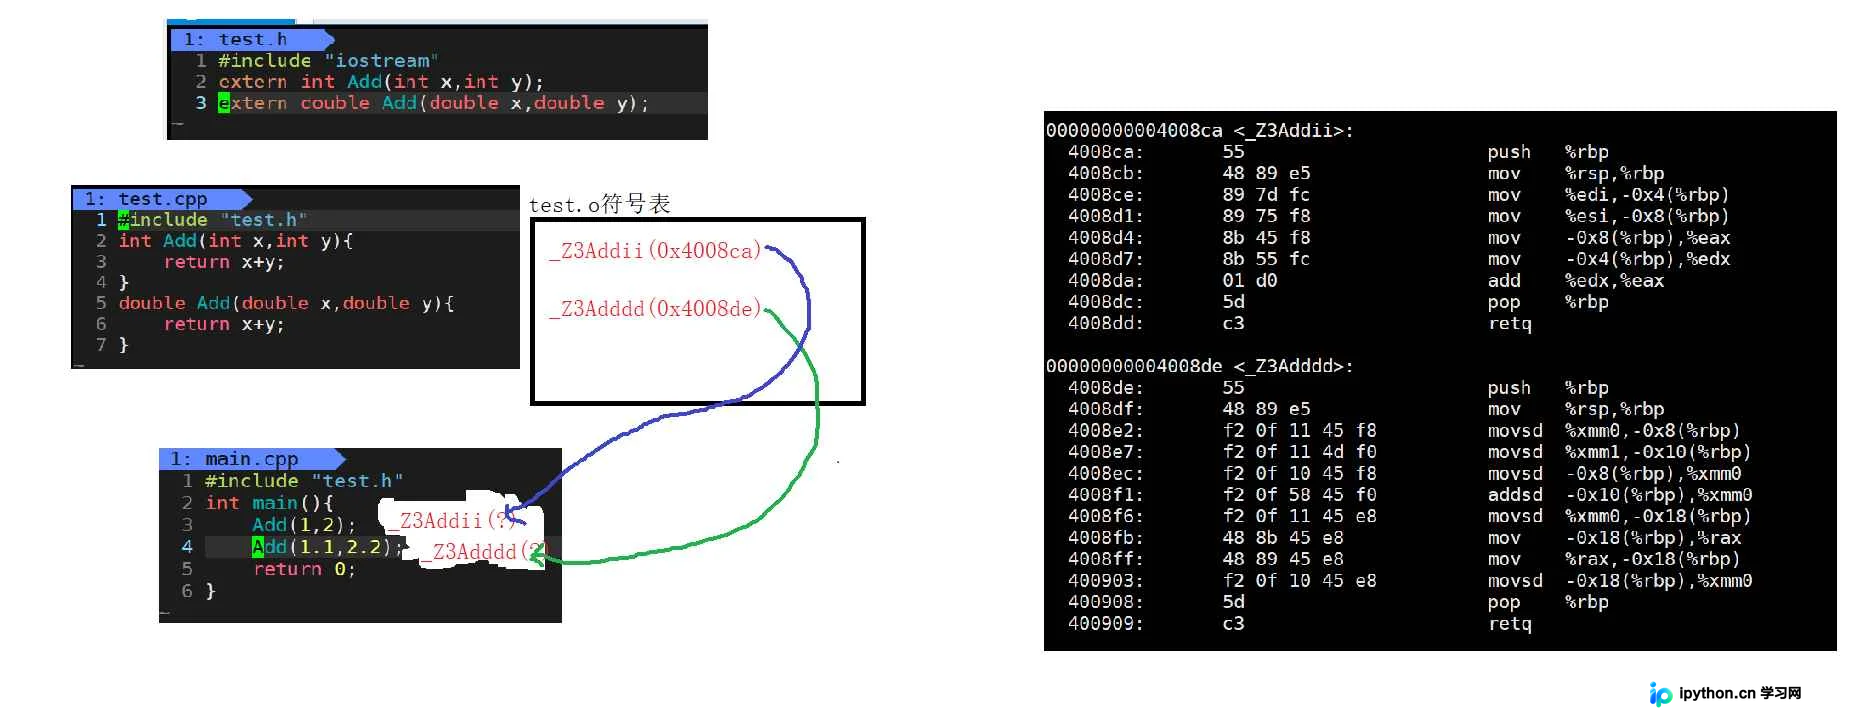
以GCC为例,修饰后的名字通常遵循类似 _Z + 函数长度 + 函数名 + 类型首字母 的规则。例如,add(int, int) 可能被修饰为 _Z3addii,而 add(double, double) 可能被修饰为 _Z3adddd。
结论:
C++之所以能支持重载,是因为编译器在编译阶段就将参数类型信息编码进了函数名中。即使源码中函数名相同,在目标文件层面它们也拥有唯一的内部符号名。链接器依靠这些经过修饰的不同名字来正确绑定调用关系。而C语言缺乏这一机制,同名函数无法在链接层被区分,故不支持重载。
以上就是C++中函数重载及底层名字修饰原理的详细内容,更多关于C++函数重载的学习资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









