

MySQL主从复制原理、延迟优化与读写分离实践

为解决单点故障并提升服务性能,MySQL常采用主从复制配合读写分离的架构。本文解析主从复制背后的三线程机制与数据同步策略,针对高并发导致的主从延迟提供具体的参数调优与硬件建议,同时说明读写分离在应对大量查询场景下的应用价值。
主从复制的核心机制
在生产环境中,为了实现数据备份及提升MySQL的整体吞吐量,通常部署主从复制集群。其核心在于Master服务器将数据变更写入二进制日志(binlog),而Slave服务器通过特定线程机制获取并执行这些日志以维持数据一致。
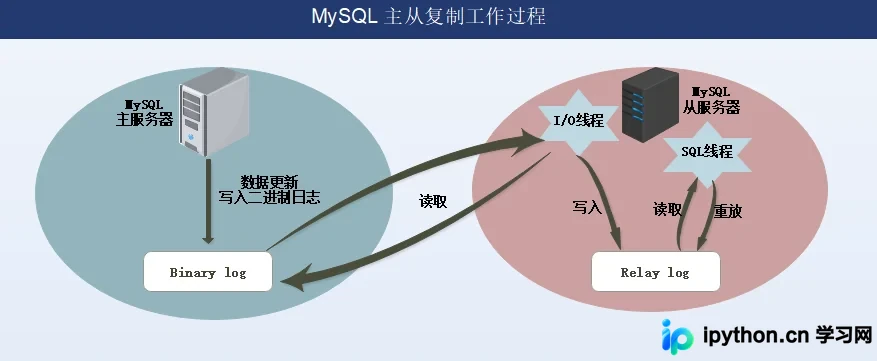
这一过程涉及三个关键线程:master端的Binlog Dump线程,以及slave端的I/O Thread和SQL Thread。
- Binlog Dump 线程:当Master库发生数据更新时,该线程会负责生成事件类型并将其写入binlog文件。一旦有更新发生,它会通知Slave端存在新的数据变化。
- I/O Thread:此线程运行在Slave端,主动向Master发起请求。Master返回当前更新的binlog文件名、位置点以及相应的副本内容。随后,I/O Thread将这些信息暂存至本地的中继日志(relay log)中。
- SQL Thread:同样位于Slave端,它监控中继日志的变化。一旦检测到新数据,便将其解析并在Slave数据库中执行,从而完成主从数据的最终同步。
数据同步策略与一致性
根据业务对性能与一致性的不同要求,MySQL支持多种同步策略:
- 同步策略:Master必须等待所有Slave响应成功后才会提交事务,这会导致严重的性能下降。
- 半同步策略:Master至少等待一个Slave确认接收日志后即可提交,平衡了安全性与性能。
- 异步策略:Master无需等待Slave反馈即可提交操作,性能最高,但存在主从数据不一致的风险。
- 延迟策略:人为设定Slave落后于Master的时间阈值,通常用于防范误删除操作带来的灾难性后果。
多数业务场景追求的是最终一致性,而非强一致性,因为强一致性的保障往往以牺牲系统吞吐量为代价。
主从复制高延迟排查与优化
在实际应用中,主从延迟是常见问题。其主要成因包括Master端的高并发事务堆积、网络传输延迟、硬件资源(CPU、IO)瓶颈,以及异步复制本身的非实时特性。
为缓解延迟问题,可从以下维度进行优化:
- 参数调优:适当增大从库的
innodb_buffer_pool_size,使更多数据操作在内存中完成,减少磁盘I/O开销。 - 硬件升级:优先选用物理主机而非虚拟云主机以提升I/O吞吐量;使用高性能CPU与大内存,并搭配SSD磁盘存储。
- 网络优化:尽量确保主从库在同一机房或低延迟网络环境下通信,避免跨地域导致的传输滞后。
读写分离的实现与应用
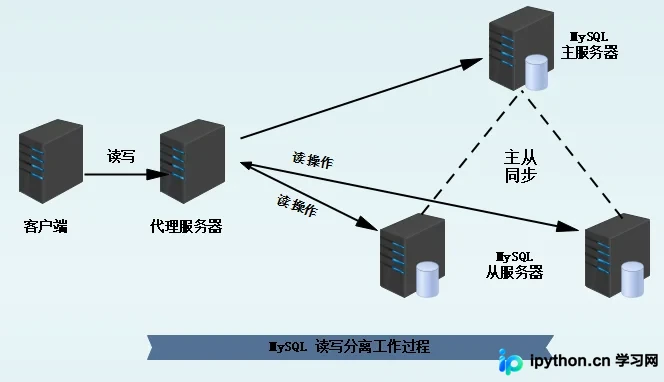
读写分离是基于主从复制架构之上的扩展应用。在该模式中,主数据库专门处理事务性的增删改(INSERT, UPDATE, DELETE),而从数据库则专注于承载查询负载(SELECT)。
为何需要读写分离?
当数据库面临巨大的读写压力,尤其是“写少读多”的场景下,单一数据库难以支撑。通过读写分离:
- 分担负载:将海量的查询请求分流至多个从库,显著降低主库的压力,保护事务处理的稳定性。
- 降低时延:在多机房部署架构中,若本地仅部署从库提供服务,可减少跨机房间的数据往返时间,加快用户读取响应速度。
- 提升性能:利用数据库复制技术将变更自动同步至集群,结合读写逻辑分离,最大化挖掘数据库集群的潜力。
该方案特别适用于程序频繁访问数据库且更新频率较低的互联网应用。通过合理设计路由规则,开发者可以利用现有的主从同步基础,低成本地实现系统性能的阶梯式提升。
以上就是MySQL数据库主从复制原理、延迟优化与读写分离实践的详细内容,更多关于MySQL主从架构设计与运维的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









