

MySQL DML语句详解:增删改查与查询进阶语法

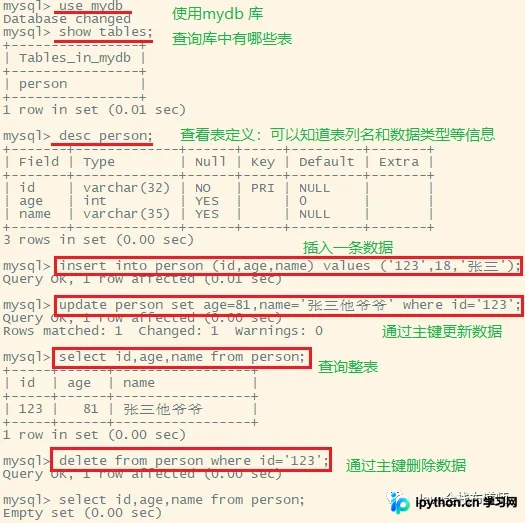
DML(Data Manipulation Language,数据操纵语言)是开发人员使用最频繁的数据库操作集合,主要用于对库表中的记录进行添加、修改、删除和查询。本文将系统梳理这些核心语法的实操方法。
1. 插入记录 (Insert)
向数据表中新增数据是日常操作的基础。支持一次性插入单条或多条记录。
第1步:插入单条记录
目的:向指定表的特定列中写入一组值。
语法入口:insert into
insert into tablename (field1,field2,...,fieldn) values (value1,value2,...,valuen);
第2步:一次性插入多条数据
目的:减少网络交互次数,提高批量数据导入效率。
语法入口:在values后追加多个括号组。
insert into tablename (field1,field2,...,fieldn)
values
 (value1,value2,...,valuen),
 (value1,value2,...,valuen);
2. 更新记录 (Update)
用于修正已有数据或根据逻辑同步表间数据。操作时务必注意条件限制,防止误改全表。
第1步:更新单表数据
目的:修改符合条件的行数据。
参数说明:[where condition]为可选参数,若不添加则整张表的所有行都会被更新。
风险提示:执行前请确认where条件的准确性。
update tablename set field1=value1, filed2=value2,...fieldn=valuen [where condition]
第2步:同时更新多个表的数据
目的:根据一个表的字段动态更新另一个表的对应字段,常用于主从表数据同步。
操作方式:在update后列出涉及的多表名。
update t1,t2,...,tn set t1.field1=expr1, tn.field=exprn [where condition];
3. 简单查询记录 (Select基础)
查询是返回结果集而非改变数据。掌握基础过滤与别名处理是进阶的前提。
第1步:基础列筛选
目的:按需查看数据。
操作:使用*通配符可查询所有字段;若需特定列,列出字段名即可。
select * from tablename [where condition];

select field1,field2,...,fieldn from tablename [where condition];
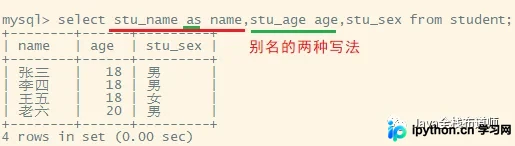
第2步:使用别名优化显示
目的:让查询结果的列名更易读,或在多表查询中标识数据来源。
操作:使用关键字AS(可省略)为列或表命名。
select field1 AS f1, field2 f2 from tablename;

select t2.field1 AS f1, t1.field2 f2 from table1 as t1, table2 t2;
4. 删除记录 (Delete)
删除操作具有不可逆性(除非有备份),需格外谨慎。分为单表删除和多表级联式删除。
第1步:删除单表记录
目的:移除指定条件的一行或多行数据。
注意:不加where条件将清空全表数据。
delete from tablename [where condition];
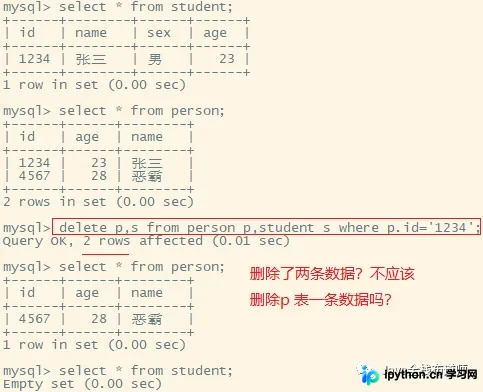
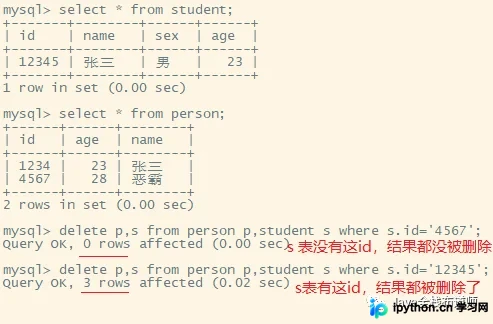
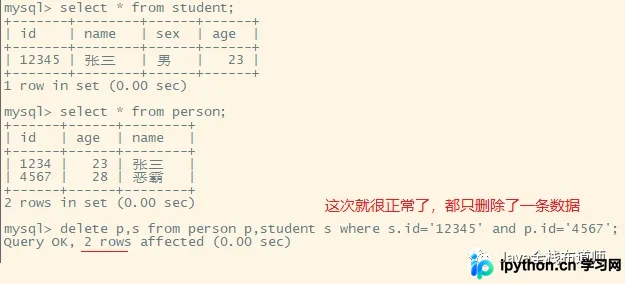
第2步:同时删除多个表的数据
目的:满足特定连接条件时,从关联的多个表中同时清除记录。
规则:条件成立则删除有条件表对应的数据,无条件表可能会全表删除;条件不成立则均不删除。
建议:先备份或在测试环境中验证此类高危操作。
delete t1,t2,...,tn from t1,t2,...,tn [where condition];
5. 查询记录详解 (DQL进阶)
SELECT语句常被称为DQL(Data Query Language),其结构类似积木拼装。理解各子句的执行顺序和功能是实现复杂数据提取的关键。
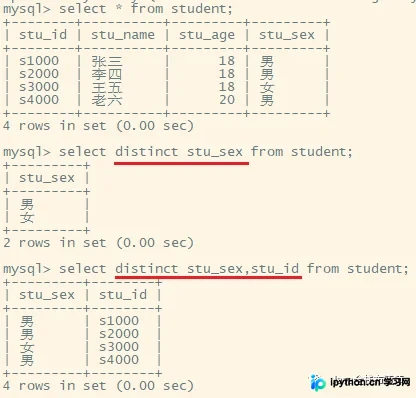
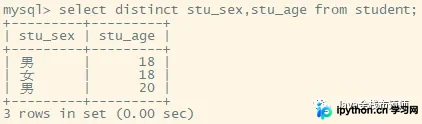
第1步:查询不重复的记录 (Distinct)
目的:去除查询结果集中完全相同的重复行。
操作:使用distinct关键字作用于查询字段。
select distinct filed from tablename;
第2步:高级条件过滤 (Where)
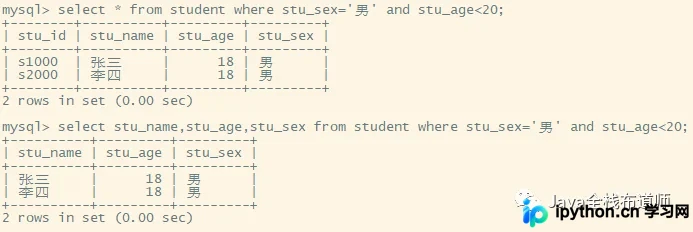
目的:精准定位符合特定标准的数据。
常用运算符:
- 比较运算符:
=,>,<,!=,<> - 空值判断:
is null,is not null - 逻辑组合:
and(且),or(或) - 范围匹配:
in,not in - 模糊匹配:
like。其中_代表单个字符,%代表零个或多个任意字符。
第3步:聚合分组统计 (Group By & Having)
目的:按类别汇总统计数据,如求平均值、总数或极值。
select [field...] fun_name from tablename
[where condition]
[group by field... [with rollup]]
[having condition];
参数解析:
fun_name:聚合函数,常用有sum()求和、count(*)计数、avg()平均、max()/min()最大值/最小值。group by:对指定列进行分类。配合with rollup可对分类后的结果再进行层级汇总。having:对分组后的结果集进行二次过滤。
区别要点:where用于分组前的原始数据过滤(效率高);having用于分组后的结果集过滤。优先在where中处理条件以减少运算量。
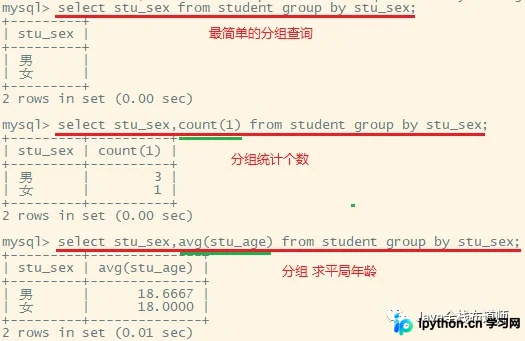 带条件过滤的聚合查询示例:
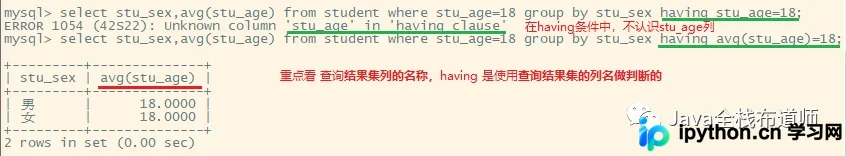 通过取别名简化输出列名:
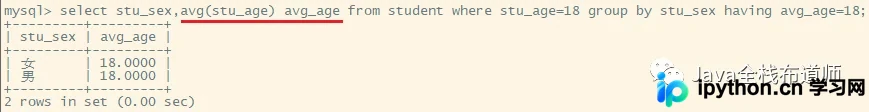
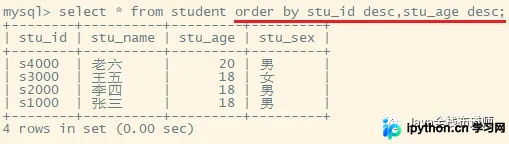
第4步:结果排序 (Order By)
目的:控制结果集的展示顺序。
操作:asc为默认升序,desc为降序。可支持多列排序,用逗号隔开优先级。
order by field1 [desc|asc], field2 [desc|asc]...
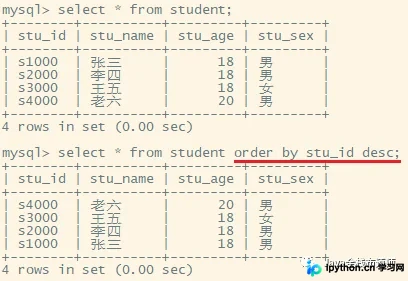 多列排序演示:
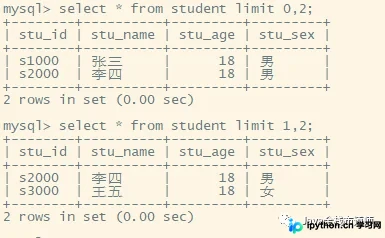
第5步:分页限制查询 (Limit)
目的:实现数据分页加载,避免一次性拉取过多数据影响性能。
语法:limit offset_start, row_count。
- offset_start:起始偏移量(从0开始计数)。
- row_count:期望返回的行数。
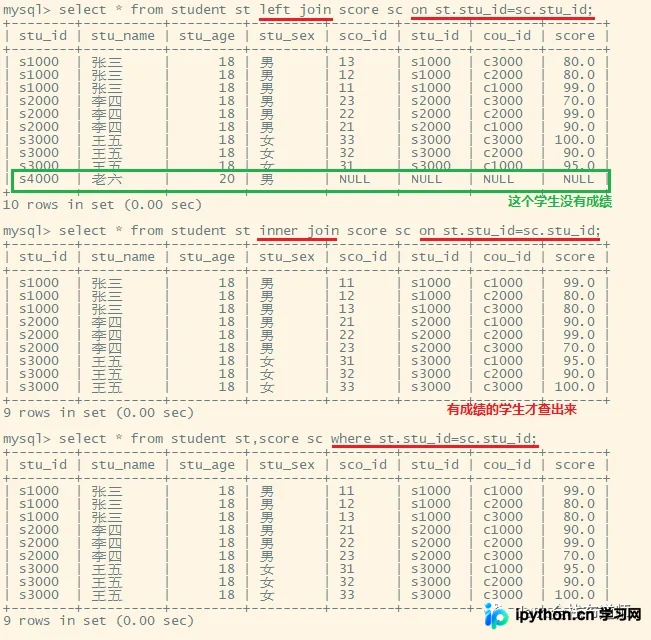
第6步:多表关联查询 (Join)
目的:当业务逻辑需要跨表获取信息时使用。
操作:重点掌握内连接和左连接。
- 左连接 (Left Join):以左表为主,返回左表所有记录,右表无匹配项则为NULL。
- 内连接 (Inner Join):仅返回两个表中互相匹配的记录。
-- 左连接
select * from t1 left join t2 on t1.field1=t2.field2;

-- 内连接
select * from t1 inner join t2 on t1.field1=t2.field2;
-- 也可写作隐式内连接
select * from t1, t2 where t1.field1=t2.field2;
第7步:子查询与联合查询
子查询:将一个查询结果作为另一个查询的条件。通常用括号()包裹。
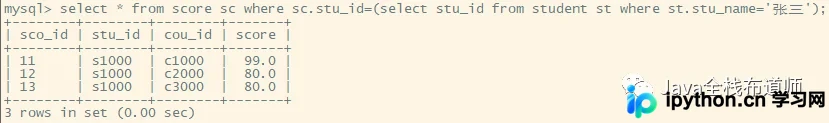
部分子查询可以转化为等价的连表查询以提升可读性:
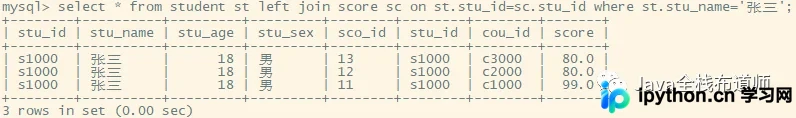
UNION联合:将多个查询结果纵向合并。要求各个查询结果的列数必须相同。
select ... from t1
union / union all
select ... from t2;
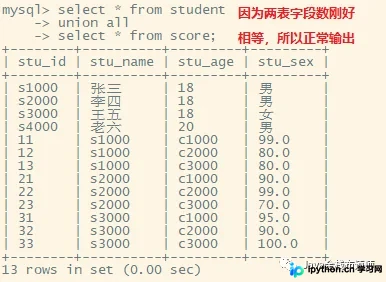 列数不等导致的报错示例:
 确保固定查询结果集字段的正确写法:
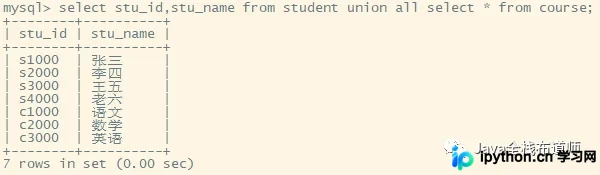
6. SELECT语句执行顺序总结
理解SQL底层的执行顺序有助于编写更高效的代码。实际执行顺序如下:
- (1) FROM:确定查询的数据源。
- (2) ON:连接条件。
- (3) JOIN:执行连接操作。
- (4) WHERE:过滤原始行的数据。
- (5) GROUP BY:对数据进行分组。
- (6) HAVING:对分组后的结果进行过滤。
- (7) SELECT:选择要展示的列。
- (8) DISTINCT:去除重复。
- (9) ORDER BY:排序。
- (10) LIMIT:限制返回行数。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









