

Java内存模型(JMM)与顺序一致性:理解并发编程的数据竞争与同步机制

在Java并发编程中,数据竞争是导致程序行为不可预测的主要原因之一。本文旨在厘清Java内存模型(JMM)与理论上的顺序一致性内存模型之间的关系,解释JMM如何通过正确的同步机制(如synchronized和volatile)来保证程序的执行结果符合开发者的预期,并探讨未同步代码可能面临的指令重排序及64位变量原子性缺失等底层细节。
JMM规范下的数据竞争定义
在多线程环境中,如果程序编写不当,极易引发数据竞争。JVM规范对“数据竞争”有明确的定义,当以下三个条件同时满足时,即构成数据竞争:
- 在一个线程中对一个共享变量进行写操作;
- 在另一个线程中对该同一变量进行读操作;
- 这两个读写操作之间没有通过某种同步机制(如锁或volatile)来确立先后顺序。
如果一个多线程程序消除了数据竞争,通常意味着它使用了正确的同步手段。只有彻底消除数据竞争,程序才能具备确定的执行逻辑和预期的输出结果。
顺序一致性内存模型及其特性
顺序一致性(Sequential Consistency)是一种理想化的内存模型理论参照。JVM规范指出,如果程序被正确地同步了,那么它的执行结果应当与在该顺序一致性模型中的执行结果一致。
核心特性
- 单线程内顺序执行:每个线程内的所有操作都必须按照代码编写的程序顺序执行。
- 全局单一视图:无论是否同步,所有线程只能看到一种全局的操作执行顺序。每个操作必须是原子的,且执行后立即对所有其他线程可见。
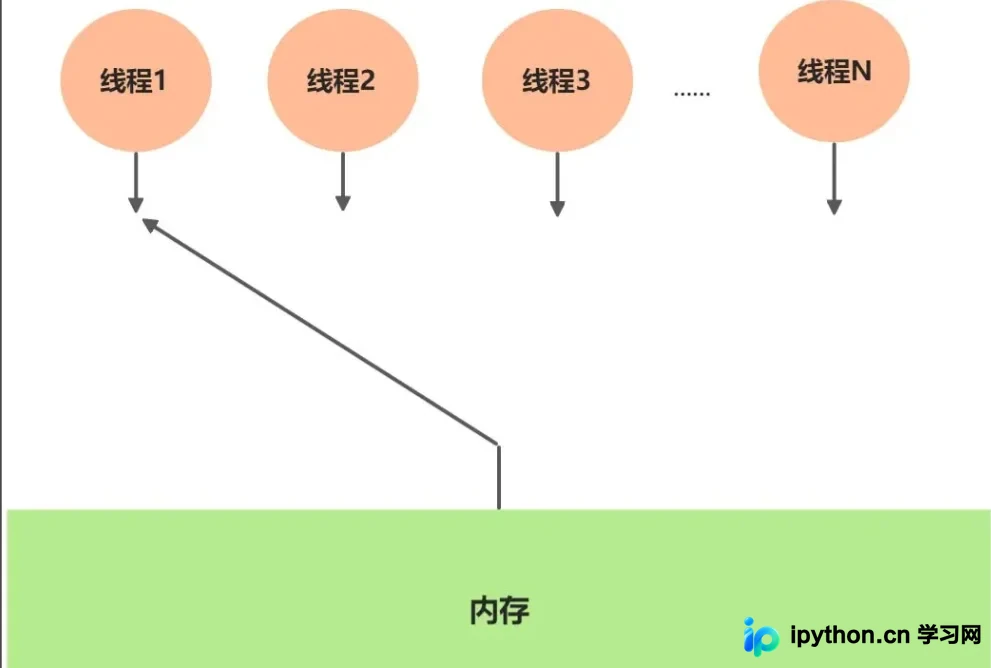
在概念上,该模型存在一个单一的全局内存空间。任意时刻,系统通过一个开关机制将全局内存连接到某一个线程,确保同一时间只有一个线程可以访问内存。这种机制将所有内存读写操作串行化,从而实现了全序关系。
执行效果示例对比
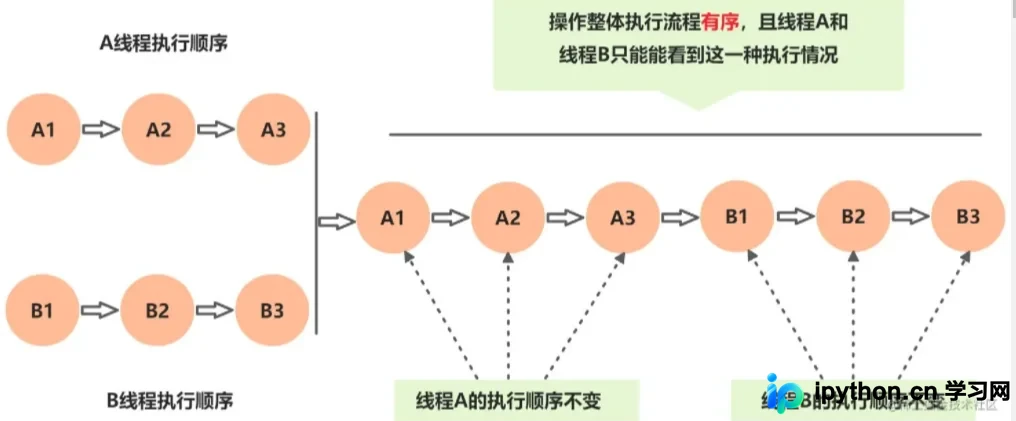
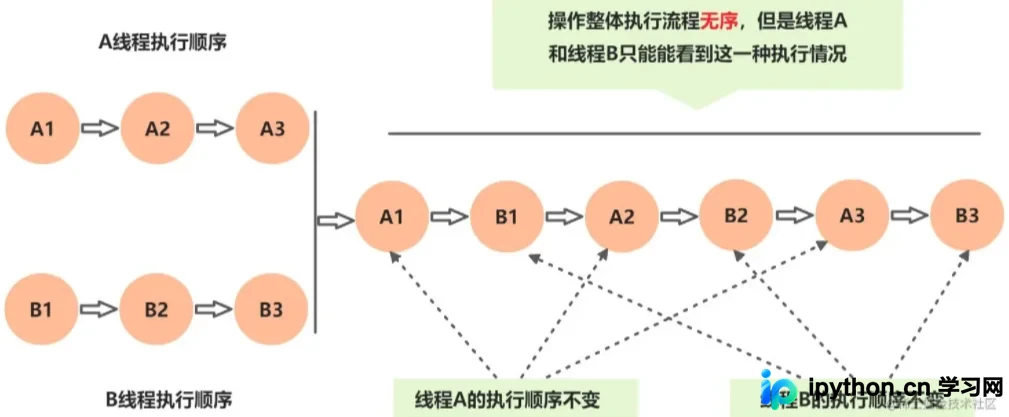
假设存在两个线程A和B,线程A的执行序列为 A1 - A2 - A3,线程B的执行序列为 B1 - B2 - B3。
正确同步时的执行效果
若使用监视器锁对A和B进行正确同步(例如A执行完释放锁,B再获取同一把锁),则整个程序表现为严格的线性顺序,即线程A的三个操作完成后,线程B才开始执行。
未同步时的执行效果
在没有同步的情况下,虽然整体执行是交错的,但在顺序一致性模型中,依然强制要求所有线程看到一致的交错顺序。例如,线程A和线程B看到的统一顺序可能是:A1 - B1 - A2 - B2 - A3 - B3。这是因为该模型强制要求每个操作必须立即对所有线程可见。
JMM与现实的区别:真实的JMM并不保证这一点。在未同步程序中,由于CPU缓存的存在,一个线程写入的数据可能仅保留在本地寄存器或缓存中,尚未刷新到主内存。此时,其他线程观察不到该写操作,导致不同线程看到的操作顺序可能不一致,进而产生多种运行结果。
同步程序在JMM中的表现
JMM的设计哲学是在不改变正确同步程序执行结果的前提下,允许编译器和处理器进行优化。对于临界区内部的代码,即使发生重排序,只要不逸出临界区,就不会破坏同步语义。
同步示例代码分析
以下示例展示了如何使用 synchronized 关键字消除重排序带来的不确定性。
package com.lizba.p1;

public class SynReorderExample {
    // 定义变量a
    int a = 0;
    // flag变量是个标记,用来标志变量a是否被写入
    boolean flag = false;

    public synchronized void writer() {     // 获取锁
        a = 1;
        flag = true;
    }                                       // 释放锁

    public synchronized void reader() {     // 获取锁
        if (flag) {
            int i = a * a;
            System.out.println("i:" + i);
        }
    }                                       // 释放锁
}
测试驱动:
public static void main(String[] args) {
    final SynReorderExample re = new SynReorderExample();

    new Thread(() -> re.writer()).start();

    new Thread(() -> re.reader()).start();
}在上述代码中,writer() 和 reader() 均被 synchronized 修饰,保证了互斥执行。多次测试结果均为 i: 1,证明了变量的有序可见性。
结论
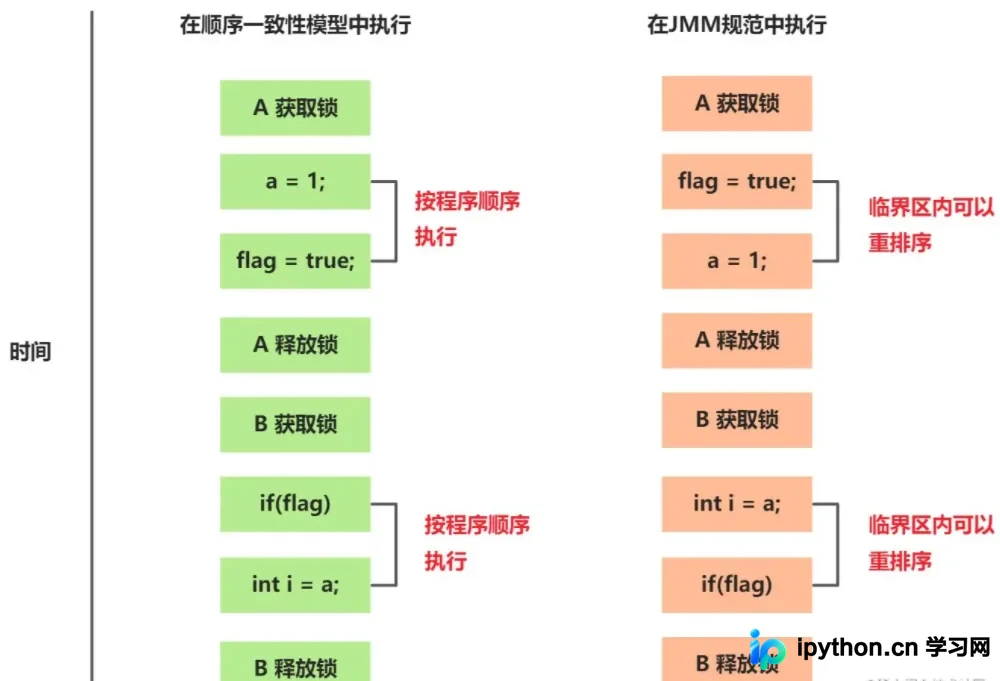
在顺序一致性模型中,所有操作严格按程序顺序串行执行。而在JMM中,虽然允许临界区内发生指令重排序,但进入和退出临界区的特殊处理(如获取和释放监视器锁)确保了在特定时间点上,线程拥有与顺序一致性模型相同的内存视图。由于锁的互斥特性,线程B无法观察到线程A在锁内部的重排序,从而保证了逻辑的正确性。
未同步程序的风险与限制
对于未正确同步的代码,JMM提供的保护非常有限。虽然Java语言规范禁止“空中楼阁”现象(Out Of Thin Air,即读取的值不能既非默认值也非任何线程写入的值),但并未提供强顺序保证。
| 比较内容\模型名称 | 顺序一致性模型 | JMM模型 |
|---|---|---|
| 单线程内顺序执行 | √ | × |
| 一致的操作执行顺序 | √ | × |
| 64位long型和double型变量写原子性 | √ | × |
64位长整型(double/long)的原子性问题
总线事务与CPU架构限制
在计算机底层,数据通过总线在处理器和内存间传递,称为总线事务(Bus Transaction)。总线具有仲裁机制,确保同一时刻只有一个处理器可以进行内存读写,从而在物理层面上保证了总线事务的原子性。
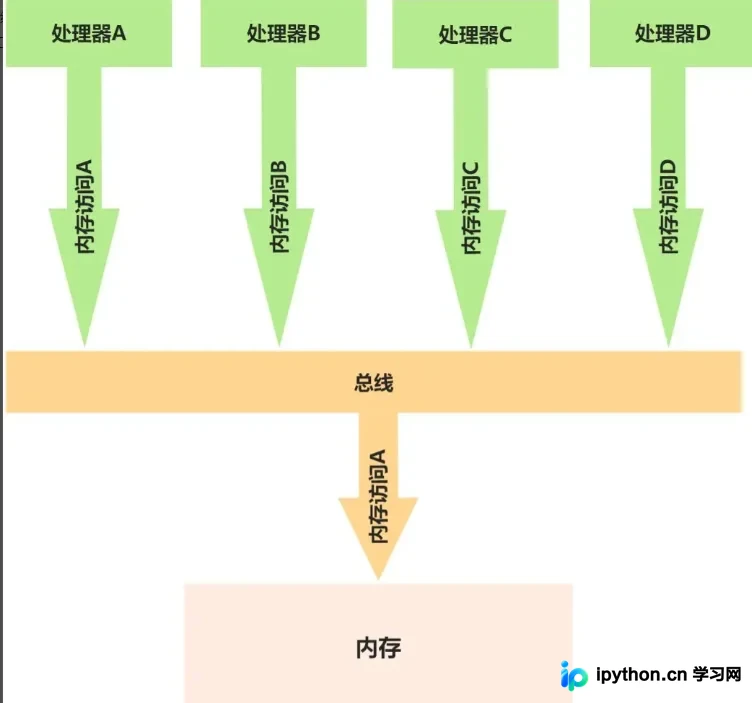
然而,在一些32位的老旧处理器架构上,处理64位数据(如 long 和 double)时,硬件层面会将一次64位写操作拆分为两次32位写操作,分属不同的总线事务。这意味着64位写操作失去了原子性。
具体风险分析
如果线程A正在拆分写入一个 long 类型的变量,而线程B在同一时间读取该变量,线程B极有可能读到一半是新值、一半是旧值的“撕裂”数据,这是无效值。
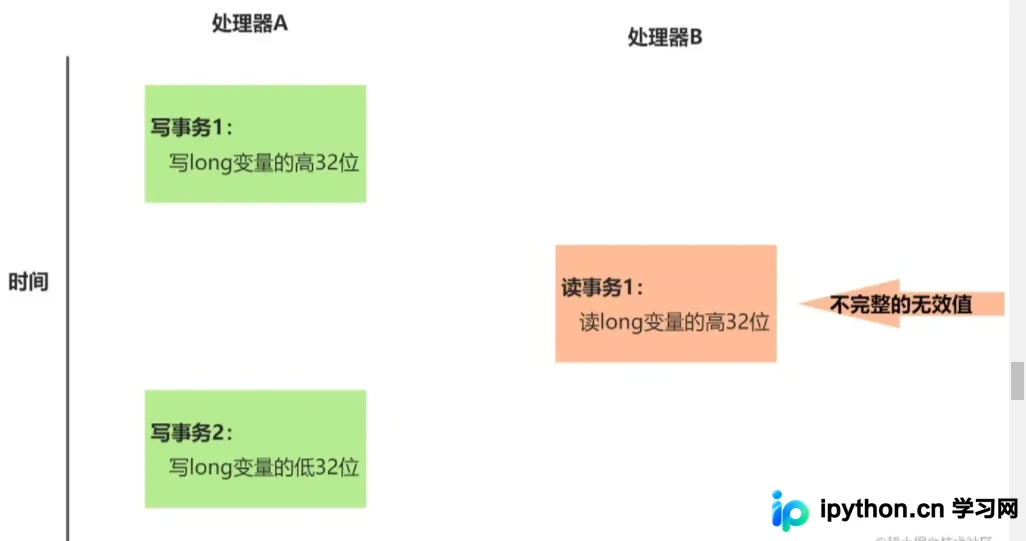
解决方案:从JDK 1.5开始引入JSR-133新内存模型后,虽然允许64位写操作被拆分为两个32位事务,但规定读操作必须在单个事务中完成以尽可能捕获有效值。对于需要严格原子性的64位操作场景,建议使用 volatile 修饰该变量或借助 java.util.concurrent.atomic 包下的原子类。
以上就是Java内存模型与顺序一致性机制的详细内容,更多关于Java并发编程中JMM原理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









