

Python实现Excel复杂公式格式化与美化

本文介绍使用Python处理复杂Excel公式格式化的完整方案。通过文本分块切分与多叉树构建,实现公式的层级缩进与可读性优化。文中提供核心算法代码、节点合并逻辑及在线体验地址,帮助开发者掌握自动化公式排版技巧。
此前与部分开发者交流时提及一个常见痛点:
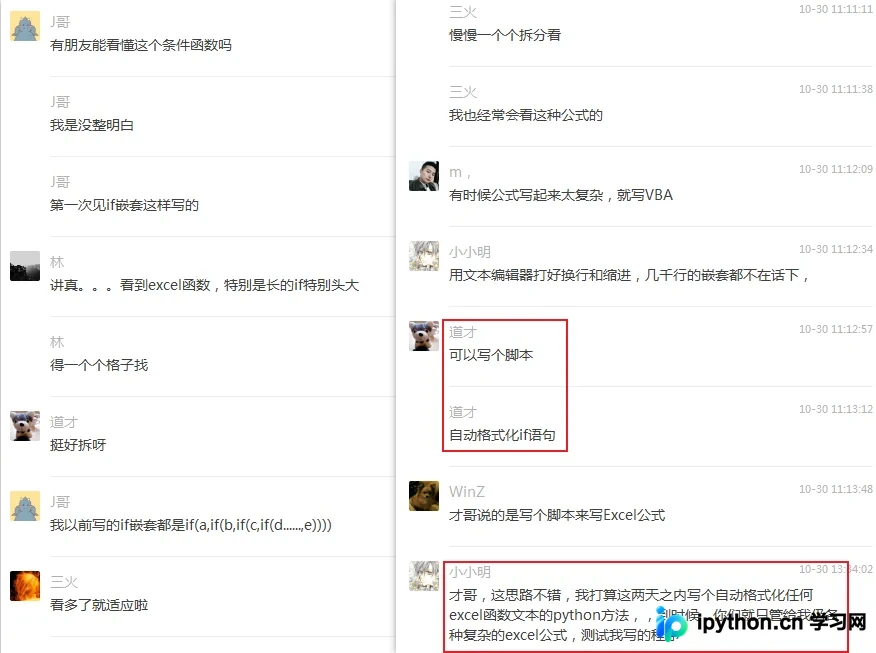
许多从事数据处理工作的朋友常遇到结构极其复杂的Excel公式,尤其是多层嵌套的情况,直接阅读极易造成视觉混乱。针对这一需求,我构思并开发了一款Excel公式自动格式化工具。
效果预览
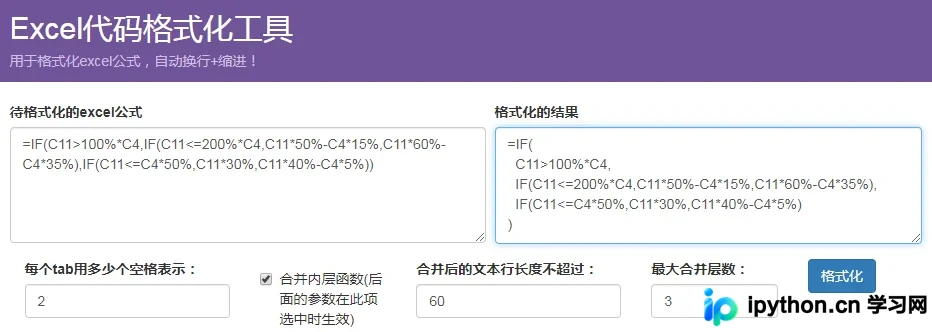
首先展示处理前后的对比效果:
=IF(C11>100%*C4,IF(C11<=200%*C4,C11*50%-C4*15%,C11*60%-C4*35%),IF(C11<=C4*50%,C11*30%,C11*40%-C4*5%))
原始公式经过格式化后的结果为:
=IF(
 C11>100%*C4,
 IF(
  C11<=200%*C4,
  C11*50%-C4*15%,
  C11*60%-C4*35%
 ),
 IF(
  C11<=C4*50%,
  C11*30%,
  C11*40%-C4*5%
 )
)
(SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,1)/SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)*100-MIN(SMA(MAX(CLOSE-DELAY(
CLOSE,1),0),12,1)/SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)*100,12))/(MAX(SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,
1)/SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)*100,12)-MIN(SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,1)/SMA(ABS(
CLOSE-DELAY(CLOSE,1)),12,1)*100,12))
另一组复杂公式的格式化输出如下:
(
 SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,1)
 /
 SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)
 *
 100-MIN(
  SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,1)
  /
  SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)*100,
  12
 )
)
/
(
 MAX(
  SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,1)
  /
  SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)*100,
  12
 )
 -
 MIN(
  SMA(MAX(CLOSE-DELAY(CLOSE,1),0),12,1)
  /
  SMA(ABS(CLOSE-DELAY(CLOSE,1)),12,1)*100,
  12
 )
)
=IF(ROW()>COLUMN(),"",IF(ROW()=COLUMN(),$B15,ROUNDDOWN($B15*INDIRECT(SUBSTITUTE(ADDRESS(1,3+COLUMN()-ROW(),
4),1,"")&56),0)))
第三组示例的格式化结果展示:
=IF(
 ROW()>COLUMN(),
 "",
 IF(
  ROW()=COLUMN(),
  $B15,
  ROUNDDOWN(
   $B15*INDIRECT(
    SUBSTITUTE(ADDRESS(1,3+COLUMN()-ROW(), 4),1,"")
    &
    56
   ),
   0
  )
 )
)
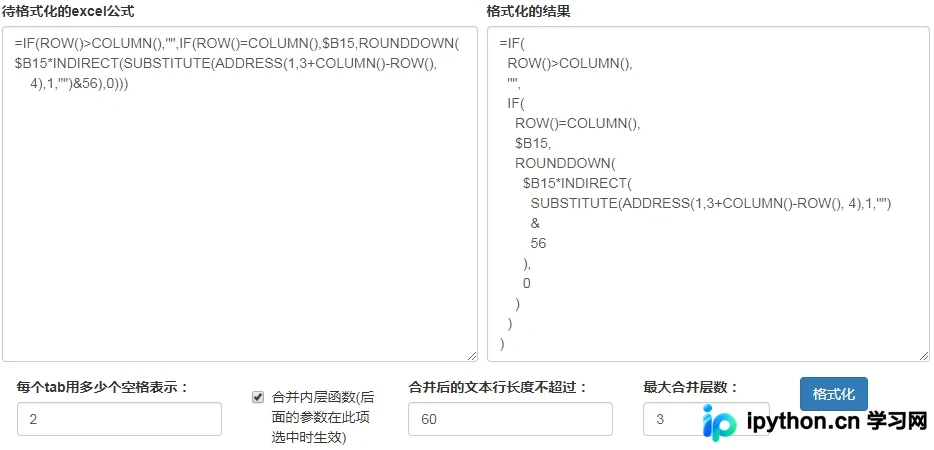
(文末附有在线体验链接)
接下来,本文将公开该格式化工具的完整源代码及核心开发思路,具备技术能力的读者可在此基础上进行优化改进。
完整源码
__author__ = 'xiaoxiaoming'

from collections import deque
import re


class Node:
  def __init__(self, parent=None, tab_size=0):
    self.parent = parent
    self.tab_size = tab_size
    self.data = []

  def is_single_node(self):
    for e in self.data:
      if not isinstance(e, str):
        return False
    return True

  def get_single_text(self):
    return "".join(self.data)


def split_text_blocks(excel_func_text):
  """
  将excel公式字符串,按照一定的规则切割成数组
  :param excel_func_text: 被切割的excel公式字符串
  :return: 切割后的结果
  """
  excel_func_text = excel_func_text.replace('\n', '').replace('\r', '')
  excel_func_text = re.sub(" +", " ", excel_func_text)
  lines = []
  i, j = 0, 0
  while j < len(excel_func_text):
    c = excel_func_text[j]
    if (c == '(' and excel_func_text[j + 1] != ')') or c == ',':
      lines.append(excel_func_text[i:j + 1])
      i = j = j + 1
    elif c == ')' and excel_func_text[j - 1] != '(':
      if i < j:
        lines.append(excel_func_text[i:j])
        i = j # 起始文件块置于)处
      # 以下代码查找,如果中间不包含(或),则将)和,之间的文本块加入到划分结果
      k = excel_func_text.find(",", j + 1)
      l = excel_func_text.find("(", j + 1, k)
      m = excel_func_text.find(")", j + 1, k)
      if k != -1 and l == -1 and m == -1:
        lines.append(excel_func_text[i:k + 1])
        i = j = k + 1
      elif j + 1 < len(excel_func_text) and excel_func_text[j + 1] != ')':
        lines.append(")")
        lines.append(excel_func_text[j + 1])
        i = j = j + 2
      else:
        lines.append(")")
        i = j = j + 1
    elif c == '"':
      j = excel_func_text.find('"', j + 1) + 1
    else:
      j += 1
  return lines


blank_char_count = 2


def combine_node(root, text_max_length=60, max_combine_layer=3):
  """
  合并最内层的只有纯文本子节点的节点为单个文本节点
  :param root: 被合并的节点
  :param text_max_length: 合并后的文本长度不超过该参数,则应用该合并替换原节点
  :param max_combine_layer: 最大合并层数
  :return:
  """
  for _ in range(max_combine_layer):
    no_change = True
    stack = deque([root])
    while stack:
      node = stack.pop()
      tmp = {}
      for i, e in enumerate(node.data):
        if isinstance(e, Node):
          if e.is_single_node():
            single_text = e.get_single_text()
            if len(single_text) < text_max_length:
              tmp[i] = single_text
          else:
            stack.append(e)
      for i, e in tmp.items():
        node.data[i] = e
      if len(tmp) != 0:
        no_change = False
    if no_change:
      break


def node_next_line(node):
  for i, e in enumerate(node.data):
    if isinstance(e, str):
      if i == 0 or i == len(node.data) - 1:
        tab = node.tab_size - 1
      else:
        tab = node.tab_size
      yield f"{' ' * blank_char_count * tab}{e}"
    else:
      yield from node_next_line(e)


def excel_func_format(excel_func_text, blank_count=2, combine_single_node=True, text_max_length=60,
           max_combine_layer=3):
  """
  将excel公式格式化成比较容易阅读的格式
  :param excel_func_text: 被格式化的excel公式字符串
  :param blank_count: 最终显示的格式化字符串的1个tab用几个空格表示
  :param combine_single_node: 是否合并纯文本节点,该参数设置为True后面的参数才生效
  :param text_max_length: 合并后的文本长度不超过该参数,则应用该合并替换原节点
  :param max_combine_layer: 最大合并层数
  :return: 格式化后的字符串
  """
  global blank_char_count
  blank_char_count = blank_count
  blocks = split_text_blocks(excel_func_text)
  # print("\n".join(blocks))
  # print('-----------拆分结果-----------')
  tab_size = 0
  node = root = Node()
  for block in blocks:
    if block.endswith("("):
      tab_size += 1
      child_node = Node(node, tab_size)
      node.data.append(child_node)
      node = child_node
      node.data.append(block)
    elif block.startswith(")"):
      tab_size -= 1
      node.data.append(block)
      node = node.parent
    else:
      node.data.append(block)
  if combine_single_node:
    combine_node(root, text_max_length, max_combine_layer)
  result = [line for line in node_next_line(root)]
  return "\n".join(result)
处理逻辑简析
以下示例均基于同一公式展开:
=IF(ROW()>COLUMN(),"",IF(ROW()=COLUMN(),$B15,ROUNDDOWN($B15*INDIRECT(SUBSTITUTE(ADDRESS(1,3+COLUMN()-ROW(),
4),1,"")&56),0)))
文本分块与切分策略
def split_text_blocks(excel_func_text):
  """
  将excel公式字符串,按照一定的规则切割成数组
  :param excel_func_text: 被切割的excel公式字符串
  :return: 切割后的结果
  """
  excel_func_text = excel_func_text.replace('\n', '').replace('\r', '')
  excel_func_text = re.sub(" +", " ", excel_func_text)
  lines = []
  i, j = 0, 0
  while j < len(excel_func_text):
    c = excel_func_text[j]
    if (c == '(' and excel_func_text[j + 1] != ')') or c == ',':
      lines.append(excel_func_text[i:j + 1])
      i = j = j + 1
    elif c == ')' and excel_func_text[j - 1] != '(':
      if i < j:
        lines.append(excel_func_text[i:j])
        i = j # 起始文件块置于)处
      # 以下代码查找,如果中间不包含(或),则将)和,之间的文本块加入到划分结果
      k = excel_func_text.find(",", j + 1)
      l = excel_func_text.find("(", j + 1, k)
      m = excel_func_text.find(")", j + 1, k)
      if k != -1 and l == -1 and m == -1:
        lines.append(excel_func_text[i:k + 1])
        i = j = k + 1
      elif j + 1 < len(excel_func_text) and excel_func_text[j + 1] != ')':
        lines.append(")")
        lines.append(excel_func_text[j + 1])
        i = j = j + 2
      else:
        lines.append(")")
        i = j = j + 1
    elif c == '"':
      j = excel_func_text.find('"', j + 1) + 1
    else:
      j += 1
  return lines

s = """=IF(ROW()>COLUMN(),"",IF(ROW()=COLUMN(),$B15,ROUNDDOWN($B15*INDIRECT(SUBSTITUTE(ADDRESS(1,3+COLUMN()-ROW(),
    4),1,"")&56),0))) """

blocks = split_text_blocks(s)
for block in blocks:
  print(block)
该步骤的运行输出结果如下:
=IF(
ROW()>COLUMN(),
"",
IF(
ROW()=COLUMN(),
$B15,
ROUNDDOWN(
$B15*INDIRECT(
SUBSTITUTE(
ADDRESS(
1,
3+COLUMN()-ROW(),
 4
),
1,
""
)
&
56
),
0
)
)
)
代码首先移除所有换行符,并将连续多个空格替换为单个空格,随后以左右括号和逗号为切分点,将字符串分割成数组。
需注意特殊场景:例如ROW()和COLUMN()函数括号内无内容时,此类括号应视为普通字符;此外,被双引号包裹的字符串内部若包含括号,也应作为普通字符处理,不参与切分。
构建多叉树层级结构
数据结构设计如下:
class Node:
  def __init__(self, parent=None, tab_size=0):
    self.parent = parent
    self.tab_size = tab_size
    self.data = []
其中parent用于存储父节点指针,tab_size记录当前节点的层级深度,data则保存当前节点的所有数据内容。
构建逻辑代码如下:
tab_size = 0
node = root = Node()
for block in blocks:
  if block.endswith("("):
    tab_size += 1
    child_node = Node(node, tab_size)
    node.data.append(child_node)
    node = child_node
    node.data.append(block)
  elif block.startswith(")"):
    tab_size -= 1
    node.data.append(block)
    node = node.parent
  else:
    node.data.append(block)
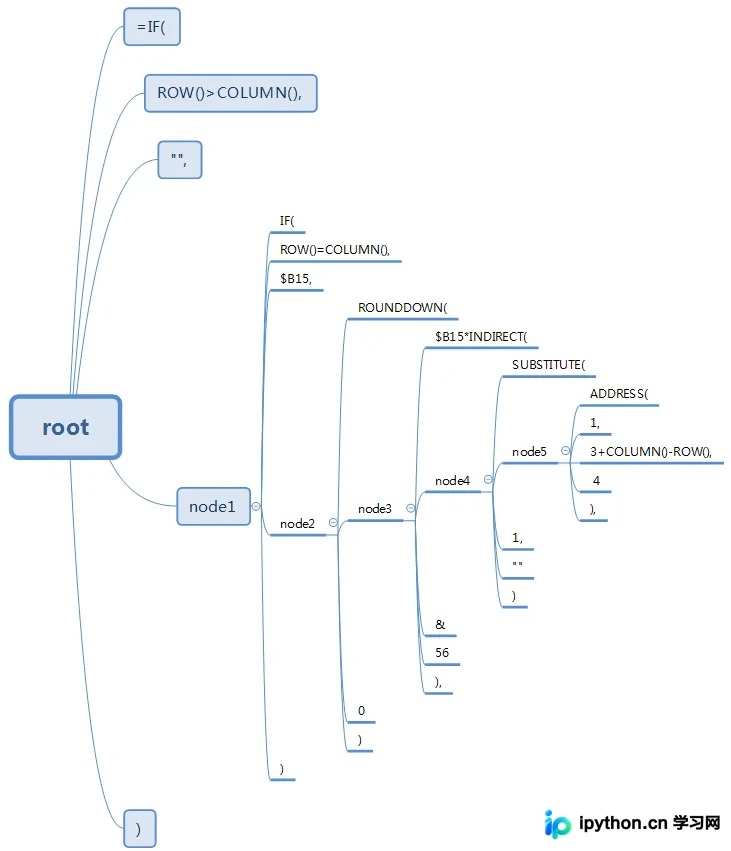
构建完成后,该数据在内存中的结构(仅展示data字段)如下所示:
遍历并打印该多叉树
def node_next_line(node):
  for i, e in enumerate(node.data):
    if isinstance(e, str):
      if i == 0 or i == len(node.data) - 1:
        tab = node.tab_size - 1
      else:
        tab = node.tab_size
      yield f"{' ' * 2 * tab}{e}"
    else:
      yield from node_next_line(e)

result = [line for line in node_next_line(root)]
print("\n".join(result))
最终输出结果为:
=IF(
 ROW()>COLUMN(),
 "",
 IF(
  ROW()=COLUMN(),
  $B15,
  ROUNDDOWN(
   $B15*INDIRECT(
    SUBSTITUTE(
     ADDRESS(
      1,
      3+COLUMN()-ROW(),
       4
     ),
     1,
     ""
    )
    &
    56
   ),
   0
  )
 )
)
合并最内层节点
显然,将最内层的node5节点进行合并可显著提升阅读体验:
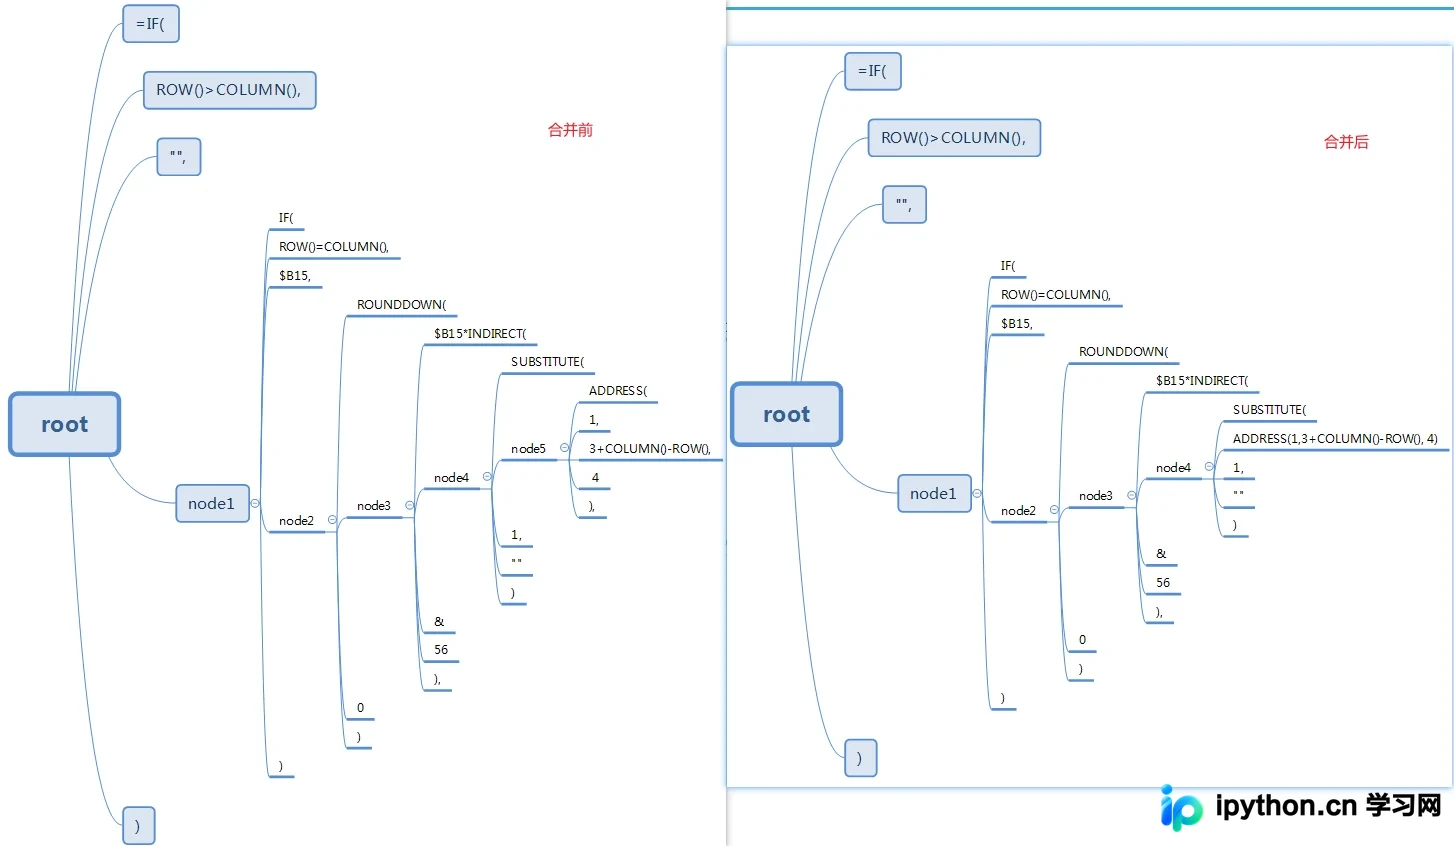
首先为数据结构增加判断是否为纯文本节点的方法:
class Node:
  def __init__(self, parent=None, tab_size=0):
    self.parent = parent
    self.tab_size = tab_size
    self.data = []

  def is_single_node(self):
    for e in self.data:
      if not isinstance(e, str):
        return False
    return True

  def get_single_text(self):
    return "".join(self.data)
以下是合并纯文本节点的具体实现。参数max_combine_layer控制最大合并次数,若合并后文本长度超过text_max_length设定的阈值,则不执行此次合并操作:
from collections import deque

def combine_node(root, text_max_length=60, max_combine_layer=3):
  """
  合并最内层的只有纯文本子节点的节点为单个文本节点
  :param root: 被合并的节点
  :param text_max_length: 合并后的文本长度不超过该参数,则应用该合并替换原节点
  :param max_combine_layer: 最大合并层数
  :return:
  """
  for _ in range(max_combine_layer):
    no_change = True
    stack = deque([root])
    while stack:
      node = stack.pop()
      tmp = {}
      for i, e in enumerate(node.data):
        if isinstance(e, Node):
          if e.is_single_node():
            single_text = e.get_single_text()
            if len(single_text) < text_max_length:
              tmp[i] = single_text
          else:
            stack.append(e)
      for i, e in tmp.items():
        node.data[i] = e
      if len(tmp) != 0:
        no_change = False
    if no_change:
      break
执行第一次合并:
combine_node(root, 100, 1)
result = [line for line in node_next_line(root)]
print("\n".join(result))
合并后的结果:
=IF(
 ROW()>COLUMN(),
 "",
 IF(
  ROW()=COLUMN(),
  $B15,
  ROUNDDOWN(
   $B15*INDIRECT(
    SUBSTITUTE(
     ADDRESS(1,3+COLUMN()-ROW(), 4),
     1,
     ""
    )
    &
    56
   ),
   0
  )
 )
)
执行第二次合并:
combine_node(root, 100, 2)
result = [line for line in node_next_line(root)]
print("\n".join(result))
合并后的结果:
=IF(
 ROW()>COLUMN(),
 "",
 IF(
  ROW()=COLUMN(),
  $B15,
  ROUNDDOWN(
   $B15*INDIRECT(
    SUBSTITUTE(ADDRESS(1,3+COLUMN()-ROW(), 4),1,"")
    &
    56
   ),
   0
  )
 )
)
执行第三次合并:
combine_node(root, 100, 3)
result = [line for line in node_next_line(root)]
print("\n".join(result))
合并后的结果:
=IF(
 ROW()>COLUMN(),
 "",
 IF(
  ROW()=COLUMN(),
  $B15,
  ROUNDDOWN(
   $B15*INDIRECT(SUBSTITUTE(ADDRESS(1,3+COLUMN()-ROW(), 4),1,"")&56),
   0
  )
 )
)
三次合并完成后的内存状态:
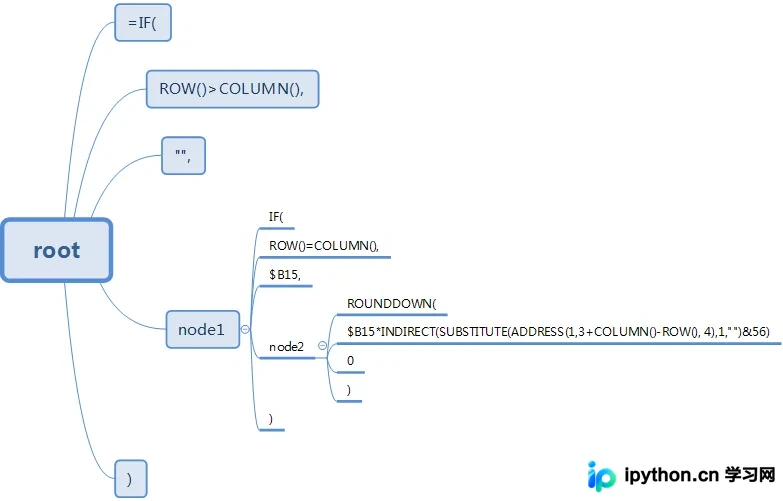
在线体验链接
http://xiaoxiaoming.xyz:8088/excel
该链接不保证长期有效。
至此,关于Python实现Excel公式格式化的示例代码介绍完毕。如需了解更多Python处理Excel公式格式化的相关内容,建议搜索本站往期文章或继续阅读后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









