

Python面试核心考点:从基础语法到网络编程的12个关键问题解析

本文汇总了Python开发面试中高频出现的12个核心问题,涵盖基础语法如Pickling与命名空间,高级特性如*args/**kwargs,以及系统层面的内存管理、链表环检测。重点解析MySQL分区策略、SQL查询优化技巧,并深入对比多进程与多线程、select与epoll机制、TCP与UDP协议差异及边缘/水平触发模式,最后通过代码实例解析DefaultDict行为,为求职者提供全面的技术准备指南。
1. 什么是pickling和unpickling?
Pickle模块负责将任意Python对象转换为字符串流,并通过dump函数将其序列化存储至文件中,这一过程被称为pickling(序列化)。反之,从存储的字符串文件中还原出原始Python对象的过程,则被称为unpickling(反序列化)。
2. 什么是Python的命名空间?
在Python中,所有标识符都存在于特定的作用域空间内,这些标识符在该空间中被定义和操作,这个空间即为命名空间。可以将其形象地理解为一个容器盒子,每个变量名对应存储着一个对象;当程序查询变量时,系统会在此盒子里查找对应的对象。
3. *args,**kwargs?参数是什么?
当函数接收的参数数量不确定,或者希望以列表和元组形式传递参数时,应使用*args;若需接收数量不定的关键字参数,或希望将字典的值作为关键字参数传入函数时,则需使用**kwargs。
4. 负索引是什么?
Python中的序列索引既可以是正数也可以是负数。正索引从0开始,代表序列的第一个元素,1代表第二个元素。而负索引中,-1指向最后一个元素,-2指向倒数第二个元素,依此类推。
5. Python是如何进行内存管理的?
Python的内存管理由私有堆空间负责,所有Python对象和数据结构均存储于此私有堆中。程序员无法直接访问该堆空间,仅解释器拥有操作权限。内存分配由Python的内存管理模块执行,其核心API提供了供程序员调用的方法。此外,Python内置垃圾回收机制,自动回收并释放未被引用的内存,供其他程序使用。
6. 如何判断单向链表中是否有环
首先遍历链表,通过检查节点地址是否重复来判断是否存在环。若程序陷入死循环,需开辟额外空间存储指针。在遍历新指针时,将其与已存储的旧指针进行比对;若发现相同指针,则判定链表有环;否则将新指针存入并继续遍历,直至遇到NULL,此时说明链表无环。
7. mysql数据库如何分区、分表?
分表可通过三种方式实现:MySQL集群、自定义规则以及Merge存储引擎。
分区主要包含四类策略:
RANGE 分区:基于列值属于给定的连续区间,将多行数据分配至特定分区。
LIST 分区:与RANGE分区类似,但它是基于列值匹配离散值集合中的某个值来进行选择。
HASH分区:基于用户定义的表达式返回值进行选择,该表达式利用将要插入行的列值进行计算。此函数可包含MySQL中任何产生非负整数值的有效表达式。
KEY 分区:类似于HASH分区,但KEY分区仅支持计算一列或多列,且由MySQL服务器提供自身的哈希函数。必须包含至少一列整数值。
8. 如何对查询命令进行优化?
a. 应尽量避免全表扫描,首先考虑在where及order by涉及的列上建立索引。
b. 应尽量避免在where子句中对字段进行null值判断,避免使用!=或<>操作符,避免使用or连接条件,或在where子句中使用参数、对字段进行表达式或函数操作,否则会导致全表扫描。
c. 不要在where子句中的“=”左边进行函数、算术运算或其他表达式运算,否则系统可能无法正确使用索引。
d. 使用索引字段作为条件时,如果该索引是复合索引,那么必须使用到该索引中的第一个字段作为条件时才能保证系统使用该索引,否则该索引将不会被使用。
e. 很多时候可考虑用exists代替in
f. 尽量使用数字型字段
g. 尽可能的使用varchar/nvarchar代替char/nchar
h. 任何地方都不要使用select * from t,用具体的字段列表代替“*”,不要返回用不到的任何字段。
i. 尽量使用表变量来代替临时表。
j. 避免频繁创建和删除临时表,以减少系统表资源的消耗。
k. 尽量避免使用游标,因为游标的效率较差。
l. 在所有的存储过程和触发器的开始处设置SET NOCOUNT ON,在结束时设置SET NOCOUNT OFF
m. 尽量避免大事务操作,提高系统并发能力。
n. 尽量避免向客户端返回大数据量,若数据量过大,应该考虑相应需求是否合理。
9. 多进程与多线程的区别?
a. 简而言之,一个程序至少有一个进程,一个进程至少有一个线程。
b. 线程的划分尺度小于进程,使得多线程程序的并发性高。
c. 另外,进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率。
d. 线程在执行过程中与进程还是有区别的。每个独立的线程有一个程序运行的入口、顺序执行序列和程序的出口。但是线程不能够独立执行,必须依存在应用程序中,由应用程序提供多个线程执行控制。
e. 从逻辑角度来看,多线程的意义在于一个应用程序中,有多个执行部分可以同时执行。但操作系统并没有将多个线程看做多个独立的应用,来实现进程的调度和管理以及资源分配。这就是进程和线程的重要区别。
10. select和epoll的区别?
a. select实现需要自己不断轮询所有fd集合,直到设备就绪,期间可能要睡眠和唤醒多次交替。而epoll其实也需要调用epoll_wait不断轮询就绪链表,期间也可能多次睡眠和唤醒交替,但是它是设备就绪时,调用回调函数,把就绪fd放入就绪链表中,并唤醒在epoll_wait中进入睡眠的进程。虽然都要睡眠和交替,但是select在“醒着”的时候要遍历整个fd集合,而epoll在“醒着”的时候只要判断一下就绪链表是否为空就行了,这节省了大量的CPU时间。
b. select每次调用都要把fd集合从用户态往内核态拷贝一次,并且要把current往设备等待队列中挂一次,而epoll只要一次拷贝,而且把current往等待队列上挂也只挂一次(在epoll_wait的开始,注意这里的等待队列并不是设备等待队列,只是一个epoll内部定义的等待队列)。这也能节省不少的开销。
11. TCP和UDP的区别?边缘触发和水平触发的区别?
a. 基本区别:
- 基于连接与无连接
- TCP要求系统资源较多,UDP较少;
- UDP程序结构较简单
- 流模式(TCP)与数据报模式(UDP);
- TCP保证数据正确性,UDP可能丢包
- TCP保证数据顺序,UDP不保证
b. 编程中的区别
- socket()的参数不同
- UDP Server不需要调用listen和accept
- UDP收发数据用sendto/recvfrom函数
- TCP:地址信息在connect/accept时确定
- UDP:在sendto/recvfrom函数中每次均需指定地址信息
- UDP:shutdown函数无效
12. 下面的代码能够运行么?请解释?
例如:
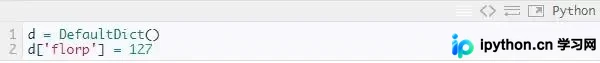
能够运行。当key缺失时,执行DefaultDict类,字典的实例将自动实例化这个数列。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









