

零基础怎么开始Python程序设计:学习路线与核心概念
针对零基础学习者的Python程序设计起步指南,梳理清晰可执行的学习路线,深入剖析变量、控制流、函数与容器等核心概念,提供环境搭建步骤与避坑建议。
零基础学习Python程序设计的有效路径,不是试图一次性通读整本语法字典,而是先在本地完成最简环境搭建并运行第一行代码,建立对程序输入、处理与输出的直观感知;随后聚焦变量引用、条件分支、循环迭代、数据容器与函数封装五大核心概念,并以具体的微型自动化任务作为练习载体,从而完成从理解语法到自主编写代码的跨越。
一、准备工作:搭建最简执行环境与验证
初学者容易卡在繁复的工具选择上。市面上有各类商业IDE、数据分析发行包以及在线运行平台,但对于刚起步的学习者,最稳健的做法是直接使用官方Python解释器配合一款轻量级代码编辑器(如Visual Studio Code),理解代码从纯文本文件到被解释器逐行翻译执行的过程。
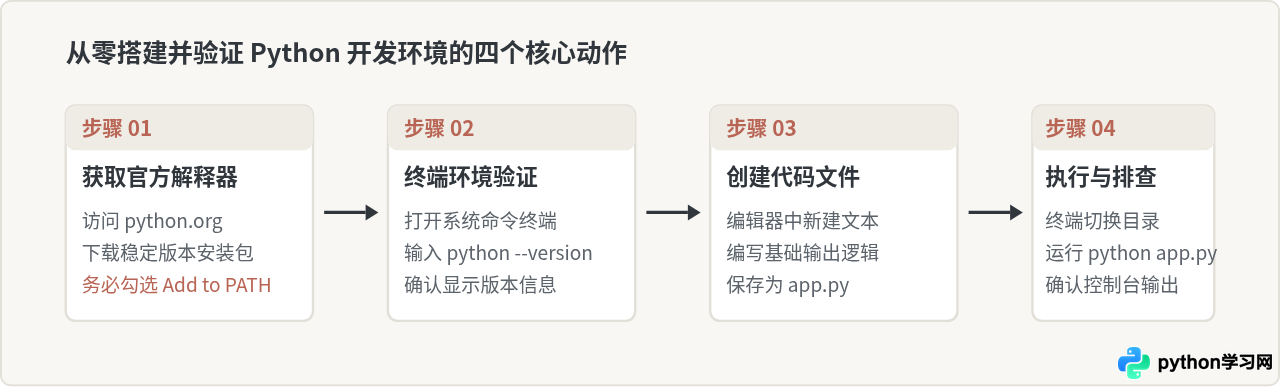
1. 操作步骤
- 安装解释器:前往 Python 官方网站(python.org)下载对应的安装程序。Windows 用户在安装界面的第一个屏幕上,必须勾选“Add python.exe to PATH”,否则系统命令行无法全局识别
python命令。 - 验证安装结果:打开系统终端(Windows 上的 CMD 或 PowerShell,macOS 上的 Terminal),输入以下命令检查版本:
python --version如果输出显示了具体的 Python 版本号,说明系统路径配置正确。接下来,在任意工作文件夹内创建一个名为 first_script.py 的文本文件,并在其中写入以下代码:
# first_script.py
name = "初学者"
print(f"你好,{name},Python 已成功运行。")
在终端中通过 cd 命令切换至该文件所在目录,输入并回车执行:
python first_script.py若终端提示“'python' 不是内部或外部命令”,多数是因为安装时未勾选添加到环境变量(PATH)。重新运行安装包并选择 Modify,勾选环境变量选项即可修复,无需重复重装系统。
二、核心概念:建立程序设计的基本心智模型
很多零基础学习者在初期感到困惑,是因为把精力花在死记硬背语法符号上,而未理解程序语言背后的运行机理。Python 的设计理念强调简洁直观,其核心语法规则可以梳理为四大基础支柱:
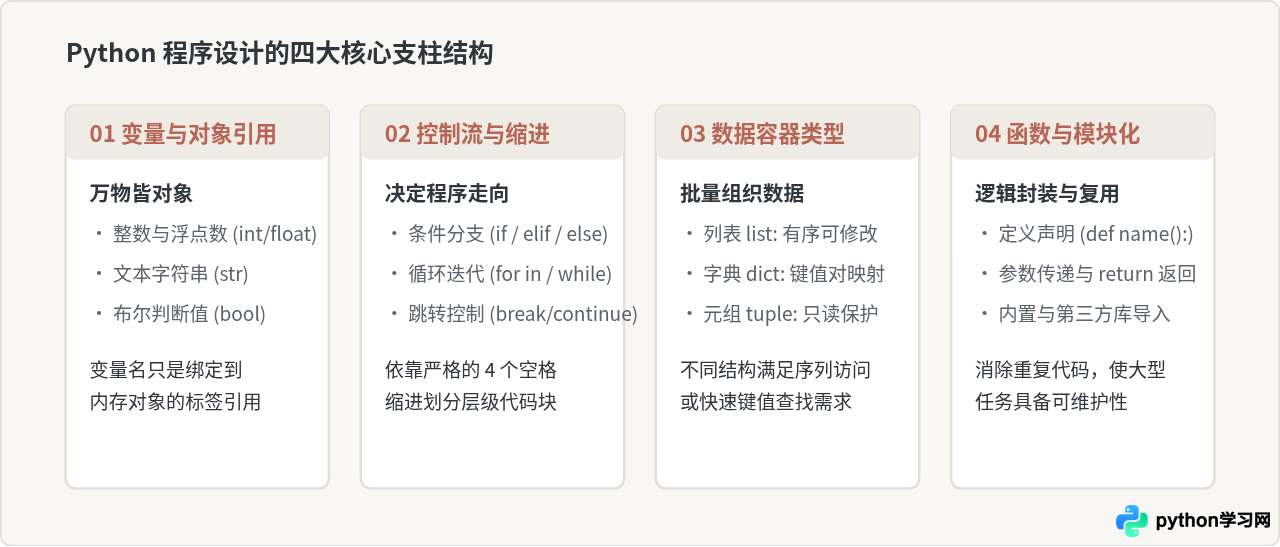
1. 深入理解变量与动态内存绑定
在诸如 C 或 Java 等静态编译语言中,声明变量如同声明一个固定大小的固定抽屉(如 int a),抽屉里只能装整数。而 Python 的变量机制完全不同:在 Python 中,变量只是一个贴在对象上的标签指针。
当执行 x = [1, 2, 3] 时,系统在内存堆中创建了一个列表对象 [1, 2, 3],然后将名字 x 指向该对象;当随后执行 y = x 时,并不是复制了一份新列表,而是让 y 这个标签也指向同一个列表对象。
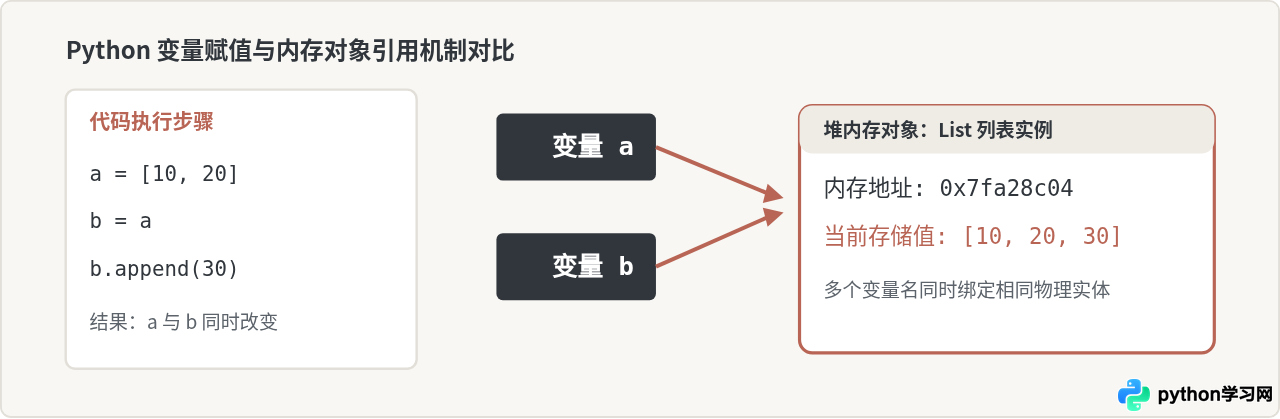
# 演示变量引用的典型特征
list_a = [1, 2, 3]
list_b = list_a  # 绑定到同一个内存对象
list_b.append(4)

print("list_a 内容:", list_a)
print("list_b 内容:", list_b)
print("是否指向同一对象:", list_a is list_b)list_a 内容: [1, 2, 3, 4]
list_b 内容: [1, 2, 3, 4]
是否指向同一对象: True
这个特性决定了在处理列表(list)与字典(dict)这类可变对象时,如果需要脱离原对象独立修改,必须使用 list_a.copy() 或 copy.deepcopy() 进行显式浅拷贝或深拷贝。
2. 控制流程与缩进语法规则
Python 最显著的外部特征之一是用缩进代替传统语言中的大括号 {}。同层级的代码块必须保持完全一致的缩进深度(官方推荐且业界通用标准为 4 个纯空格,切忌混用制表符 Tab)。
# 条件判断与循环计算综合示例
scores = [78, 92, 54, 88, 61]
passed_students = []

for score in scores:
    # 缩进层级 1:进入循环体内部
    if score >= 60:
        # 缩进层级 2:满足及格条件
        passed_students.append(score)
    else:
        # 缩进层级 2:未及格分支
        continue

print("及格成绩列表:", passed_students)
print("及格人数总计:", len(passed_students))及格成绩列表: [78, 92, 88, 61]
及格人数总计: 4
3. 数据容器的选择依据
程序设计的本质是输入数据、加工数据并产出结果。初学者必须能够根据应用场景准确选择容器:
- 列表(List,如
['apple', 'banana']):元素有序、支持任意添加修改与索引切片。适用于存储一组顺序发生的事件或待处理的任务清单。 - 元组(Tuple,如
(1920, 1080)):一旦创建不可更改。适合存储不应被意外修改的固定配置或坐标信息。 - 字典(Dictionary,如
{'name': 'Alice', 'role': 'Admin'}):以键值对(Key-Value)形式组织,查找速度极快,时间复杂度接近 O(1)。适合表达结构化实体属性。
三、系统化学习路线:分阶段目标与实践项目
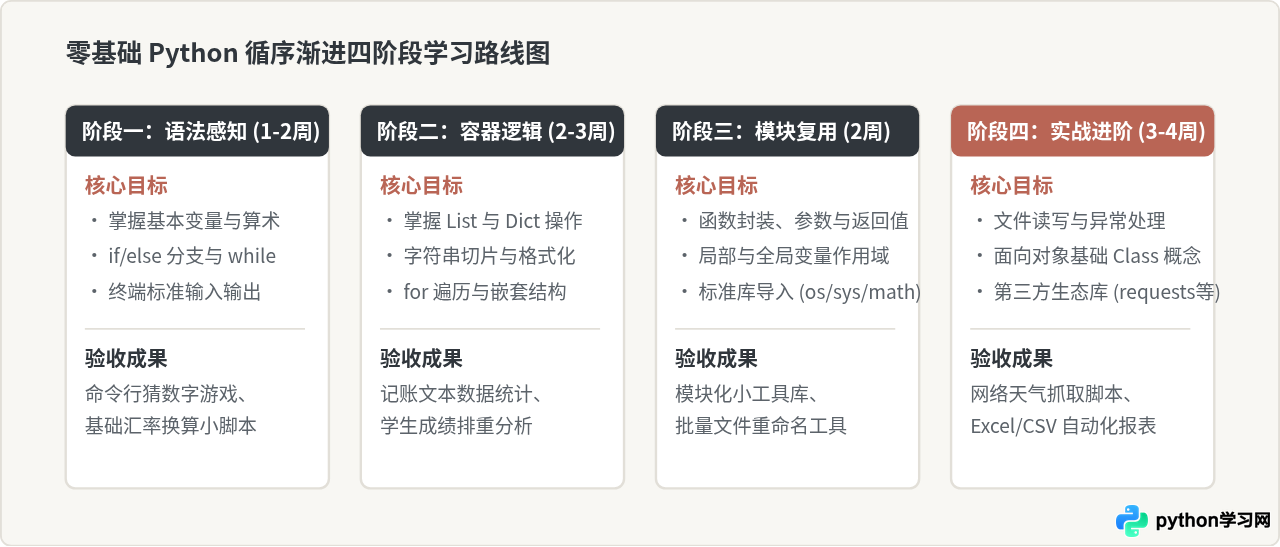
避免“从入门到放弃”的核心原则是:每一阶段都必须有明确的能力产出,坚决不进行无反馈的纯理论阅读。建议零基础学习者将前两至三个月划分为四个循序渐进的阶段:
实战演练:编写一个文件统计函数
当学习完阶段三后,应立即尝试组合所学知识。下面的完整示例展示了如何使用函数封装、列表遍历与异常捕获来统计文本中各单词的出现频次:
def count_words(text: str) -> dict:
    """统计一段文本中每个单词的出现次数并返回字典"""
    if not isinstance(text, str):
        raise TypeError("输入必须为字符串")

    # 去除非字母符号并统一小写
    clean_text = text.replace(",", "").replace(".", "").replace("!", "").lower()
    words = clean_text.split()

    frequency = {}
    for word in words:
        # 使用字典的 get 方法设定默认计数值 0
        frequency[word] = frequency.get(word, 0) + 1

    return frequency

# 测试函数
sample_article = "Python is readable. Python is practical! Code in Python."
result = count_words(sample_article)

print("单词出现频次统计:")
for word, count in sorted(result.items(), key=lambda item: item[1], reverse=True):
print(f" - {word}: {count} 次")单词出现频次统计:
- python: 3 次
- is: 2 次
- readable: 1 次
- practical: 1 次
- code: 1 次
- in: 1 次
四、初学者高频误区与排错建议
在程序设计起步阶段,报错是常态而非失败。养成清晰的错误排查思路,比盲目在搜索引擎中全量复制错误信息更为高效:
- 混淆赋值符号(
=)与等值判断(==):初学者常在if语句中误写if status = 1:,这会导致SyntaxError: invalid syntax。务必牢记单个等号是赋值,双等号才是比较。 - 类型不匹配(TypeError):在执行字符串拼接时,直接将数字与文本相加(如
"Count: " + 5)会引发报错。必须显式转换str(5)或使用推荐的 f-string 语法f"Count: {5}"。 - 超出索引范围(IndexError):在列表操作中,记住 Python 的索引从
0开始。一个长度为 3 的列表,最大合法正向下标是2,访问list[3]必然崩溃。 - 排查报错的看栈顺序:Python 的 Traceback 信息是从上往下打印、最后一行才是直接报错原因。直接看最后一行了解具体异常类别,再回溯倒数第二行的代码文件名与行号定位问题源头。
掌握 Python 并不需要天赋,它是一门高度契合人类直觉逻辑的实用工具。按照上述学习路线,坚持每天动手写出可运行的脚本代码,在具体的小问题解决中积累对核心概念的认知,便是最扎实可靠的入门方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









