

Python Web应用中路由、视图与模板是怎么工作的
深入解析Python Web应用中路由、视图与模板的工作原理与协作生命周期。通过完整的执行流程、代码示例与架构图解,帮助开发者掌握Web服务端核心设计机制。
一、全链路视角:一个 HTTP 请求的完整旅行
当你在浏览器地址栏敲入一个网址(例如 http://example.com/blog/99)并回车时,底层操作系统将建立 TCP 连接并发送原始 HTTP 请求文本。Web 服务器网关(如 Gunicorn、uWSGI 或内置开发服务器)解析该请求后,会将其封装为 Python 对象并移交给应用框架。
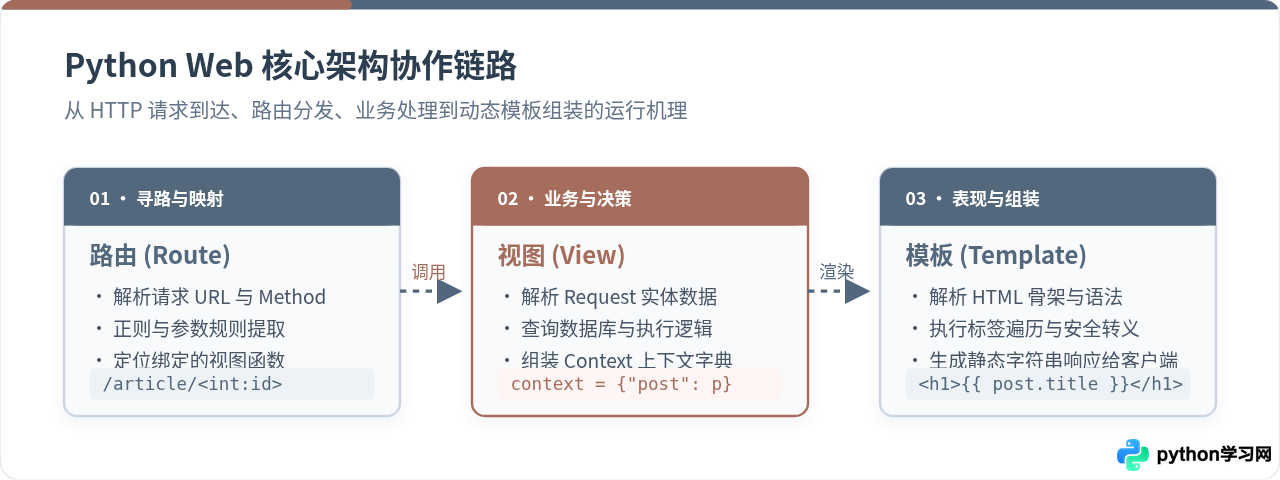
在应用内部,这一请求经历了清晰的职责交接:路由模块检查请求 URL 与 HTTP 方法,精准找到对应的业务函数;视图函数执行校验、数据库检索,并构建一个字典;随后视图函数唤起模板引擎,将该字典填入预先写好的 HTML 模版中;最后组装成标准的 HTTP 响应返回。
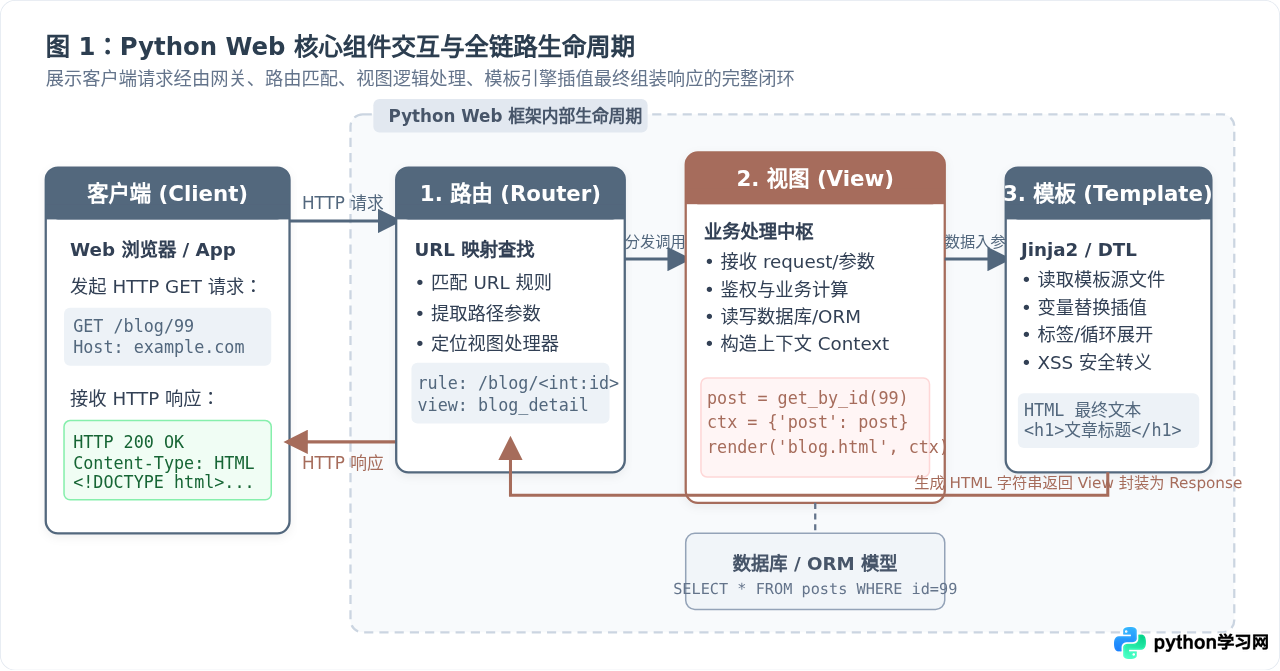
这个协作模式正是经典 MVC(Model-View-Controller)设计模式在 Web 服务端的直接体现。在 Django 的习惯术语中,它被称为 MTV(Model-Template-View),其中路由承担了前端控制器的分发功能,视图担任了原本 Controller 的逻辑中枢职责,模板充当了 View 的渲染外观,而 Model 则专注于数据持久化。
二、路由(Router):如何把 URL 映射到具体代码
路由系统是 Web 应用的“门卫与调度员”。它的主要任务只有两件事:一是维护一张“URL 模式与可调用函数”的映射表(Routing Table / URL Map);二是当请求到达时,从请求头中提取路径和请求方法,找出最符合条件的目标并提取动态参数。
1. 路由注册的底层机制
在日常开发中,我们最常见到的是装饰器语法,例如 @app.route('/article/<int:article_id>')。很多初学者误以为装饰器是在每次用户访问时动态执行的,实际上并不是。
在 Python Web 框架启动时,解释器加载代码并执行装饰器。此时,框架仅仅是将该 URL 规则字符串、允许的 HTTP 方法(如 GET、POST)以及该函数的引用包装成一个 Rule 对象,并注册到全局的路由映射表(url_map)中。这个过程只在应用启动初始化阶段执行一次。
2. 动态参数提取与类型转换器
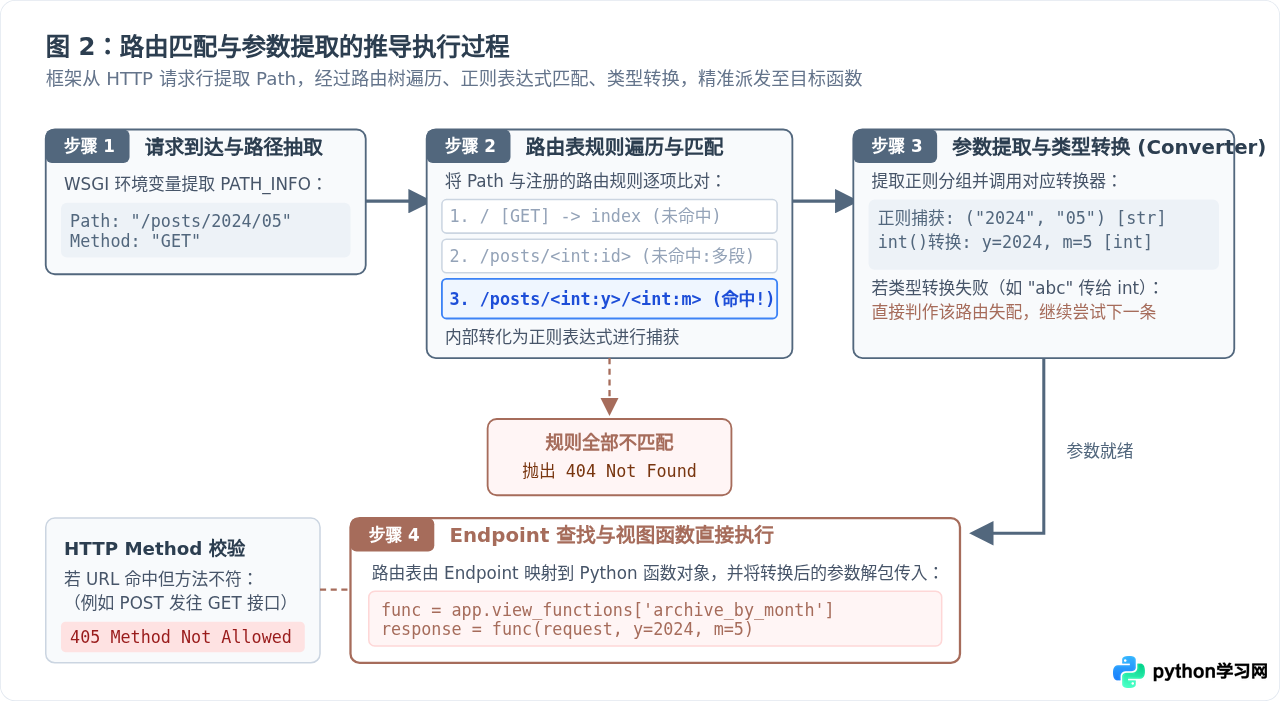
现代 Web 应用绝大多数接口都包含动态路径,例如商品 ID、文章分类或年月归档。路由系统通过两层转换实现路径参数化:
- 正则转换:框架将带有变量占位符的规则(如
/posts/<int:year>/<int:month>)编译成底层正则表达式^/posts/(?P<year>\d+)/(?P<month>\d+)$。 - 类型转换(Converter):正则匹配捕获的原始值均为字符串。路由系统根据指定的转换器(如
int、string、uuid)自动调用类型转换逻辑。若传入的内容无法转换为指定类型(例如向<int:id>传入abc),路由引擎会判定该条规则失配,继续向下尝试匹配,直至遍历结束返回 404 Not Found。
3. 路由与分发代码示例
以下代码演示了一个标准的路由注册与匹配行为。请注意路径变量是如何在函数签名中作为同名关键字参数接收的:
# app.py
from flask import Flask, request, abort

app = Flask(__name__)

# 静态路由:精确匹配根路径
@app.route('/', methods=['GET'])
def index():
    return "欢迎访问首页"

# 动态路由:带有类型转换器的参数路由
@app.route('/posts/<int:year>/<int:month>', methods=['GET'])
def archive_by_month(year, month):
    # 范围边界检查
    if month < 1 or month > 12:
        abort(404, description="月份必须在 1 到 12 之间")

return f"正在调取 {year} 年 {month} 月的历史归档..."三、视图(View):业务决策与数据中枢
如果说路由是寻路的罗盘,视图函数就是真正干活的“车间主任”。它是 Web 应用的大脑,负责理解请求的真实意图、协调底层数据源,并决定最终给客户端呈现什么。
1. 视图的输入与输出契约
视图函数遵循非常严格的契约规范:
- 输入(Input):包含了客户端一切信息的
request上下文对象(查询参数request.args、表单数据request.form、JSON 负载request.json、上传文件、Cookie 及身份凭证)以及路由系统传递进来的 URL 路径实参。 - 输出(Output):必须且只能是一个符合 WSGI/ASGI 规范的响应(Response)。这个响应可以是包含 HTML 字符串的文本响应、JSON 数据流、重定向指令(302 Redirect),或者是代表错误的 HTTP 异常响应。
2. 为什么不直接在视图里写死 HTML?
在很多早期或极简的脚本中,有人会尝试在 Python 代码里使用多行字符串硬拼 HTML:
# ❌ 强烈反对的反模式写法
def bad_profile_view(user):
    return f"<html><body><h1>{user.name}</h1><p>{user.bio}</p></body></html>"
这种做法存在两大严重缺陷:
- 严重的安全隐患(XSS 跨站脚本攻击):如果
user.bio包含恶意脚本<script>steal_cookie()</script>,直接字符串拼接会导致浏览器毫无防备地执行脚本。 - 彻底破坏关注点分离:页面结构、CSS 样式排版与 Python 业务计算、数据库查询代码混杂在一起,导致前端工程师无法独立维护界面,后端工程师排查问题举步维艰。
因此,视图函数的标准做法是:只处理业务,把数据打包成一个字典(通常称为 Context 上下文),然后转交给模板引擎处理。
四、模板(Template):动态渲染与表现装配
模板文件本质上是一个普通的文本文件(通常以 .html 结尾),其中穿插了模板引擎专用的标记占位符。常见的 Python 模板引擎有 Jinja2(Flask、FastAPI 常用)和 Django Template Language (DTL)。
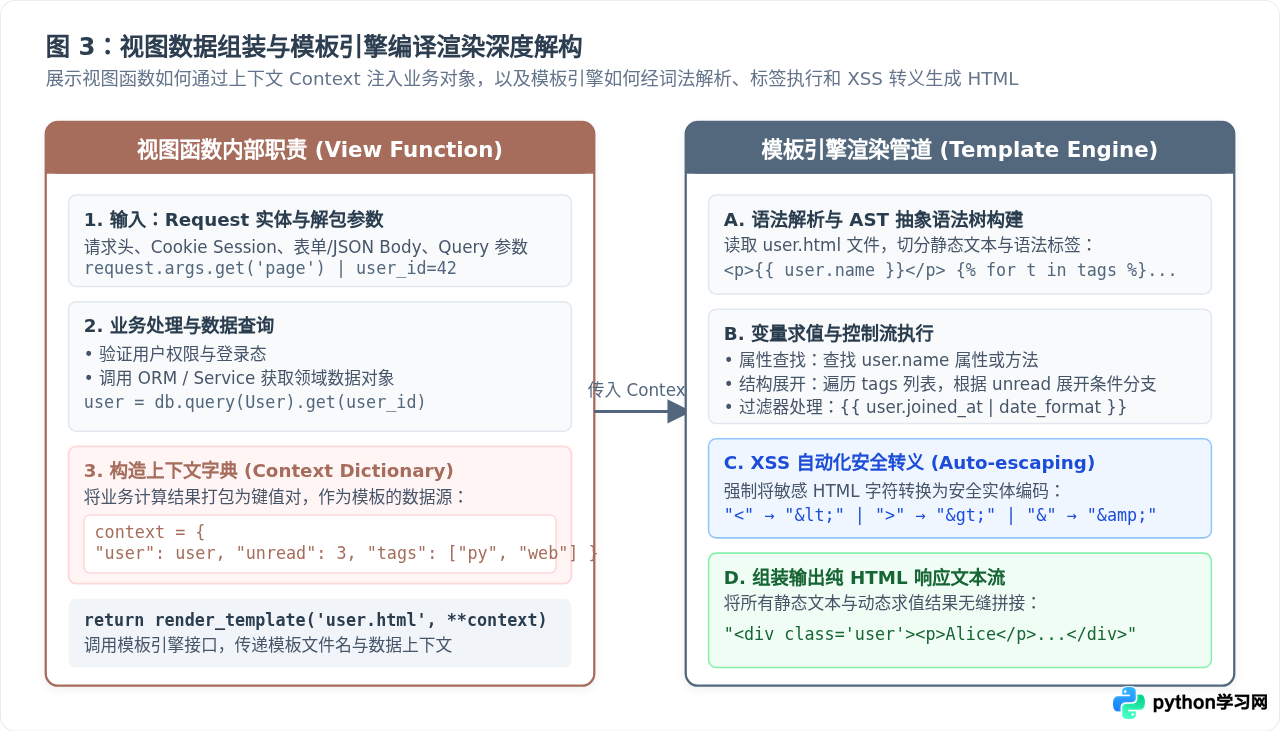
1. 模板引擎的工作机制
当视图调用 render_template('profile.html', user=user, posts=posts) 时,模板引擎在后台执行了如下流水线操作:
- 词法分析与抽象语法树(AST)构建:模板引擎扫描
profile.html,识别纯 HTML 文本块和{{ ... }}、{% ... %}等模板标签,并将其编译为高效的 Python 字节码或内部求值树。 - 上下文变量求值:遍历标签,从视图传入的
context字典中提取对应的对象、属性与方法。例如对于{{ user.name }},模板引擎会先尝试字典键查询user['name'],再尝试属性读取user.name,最后尝试方法调用user.name()。 - 自动安全转义(Auto-escaping):这是模板引擎最重要的安全屏障。所有插值变量在输出到最终 HTML 前,特殊字符都会被自动转为 HTML 字符实体(例如将
<转为<,将"转为"),有效杜绝存储型与反射型 XSS 注入。 - 流式组装生成:将所有的静态文本块与动态求值后的安全字符串顺次拼装,形成一个完整的纯 HTML 文档,作为响应体返回给视图函数。
2. 视图与模板协同的完整代码演示
下面我们通过一个具有代表性的个人主页场景,完整展示视图函数如何准备数据,以及模板如何使用控制流进行安全展示:
# views.py (视图层)
from flask import Flask, render_template, abort

app = Flask(__name__)

# 模拟数据库查询服务
def get_user_from_db(user_id):
    mock_db = {
        1: {"id": 1, "name": "张伟", "role": "admin", "bio": "<b>热爱编码</b>"},
        2: {"id": 2, "name": "李娜", "role": "editor", "bio": "记录美好生活"}
    }
    return mock_db.get(user_id)

@app.route('/user/<int:user_id>')
def user_profile(user_id):
    # 1. 获取业务数据
    user = get_user_from_db(user_id)
    if not user:
        abort(404, description="用户不存在")

    # 2. 模拟关联动态列表
    articles = [
        {"title": "Python 异步编程入门", "views": 1024},
        {"title": "深入理解装饰器原理", "views": 2048},
    ]

    # 3. 构造 Context 字典并调用模板
    context = {
        "current_user": user,
        "articles": articles,
        "unread_notifications": 3
    }
    return render_template('profile.html', **context)
接下来是对应的模板文件,展示了变量插值、条件分支、循环控制以及安全过滤器的运用:
<!-- templates/profile.html -->
<!DOCTYPE html>
<html lang="zh-CN">
<head>
    <meta charset="UTF-8">
    <title>{{ current_user.name }} 的个人主页</title>
</head>
<body>
    <header>
        <h1>{{ current_user.name }}</h1>
        <!-- 条件控制标签:根据权限展示徽章 -->
        {% if current_user.role == 'admin' %}
            <span class="badge">管理员</span>
        {% endif %}

        <!-- 安全转义:默认会转义 bio 中的 HTML 标签,避免恶意代码注入 -->
        <p>简介:{{ current_user.bio }}</p>
    </header>

    <section>
        <h2>已发表文章 ({{ articles | length }})</h2>
        <!-- 循环控制标签:展开列表内容 -->
        <ul>
        {% for item in articles %}
            <li>{{ item.title }} - 阅读量: {{ item.views }}</li>
        {% else %}
            <li>暂无发表文章</li>
        {% endfor %}
        </ul>
    </section>
</body>
</html>bleach)进行清理后,才可在模板中使用 {{ value | safe }} 过滤器。切勿直接对未经清洗的用户输入标记 safe!
五、三者职责分工与设计边界对比
构建健壮 Web 应用的关键在于坚守“关注点分离”。路由、视图与模板一旦越界,就会导致维护噩梦。例如在模板里写数据库查询(导致著名的 N+1 查询隐患且难以调试),或者在视图中硬编码 HTML 样式。
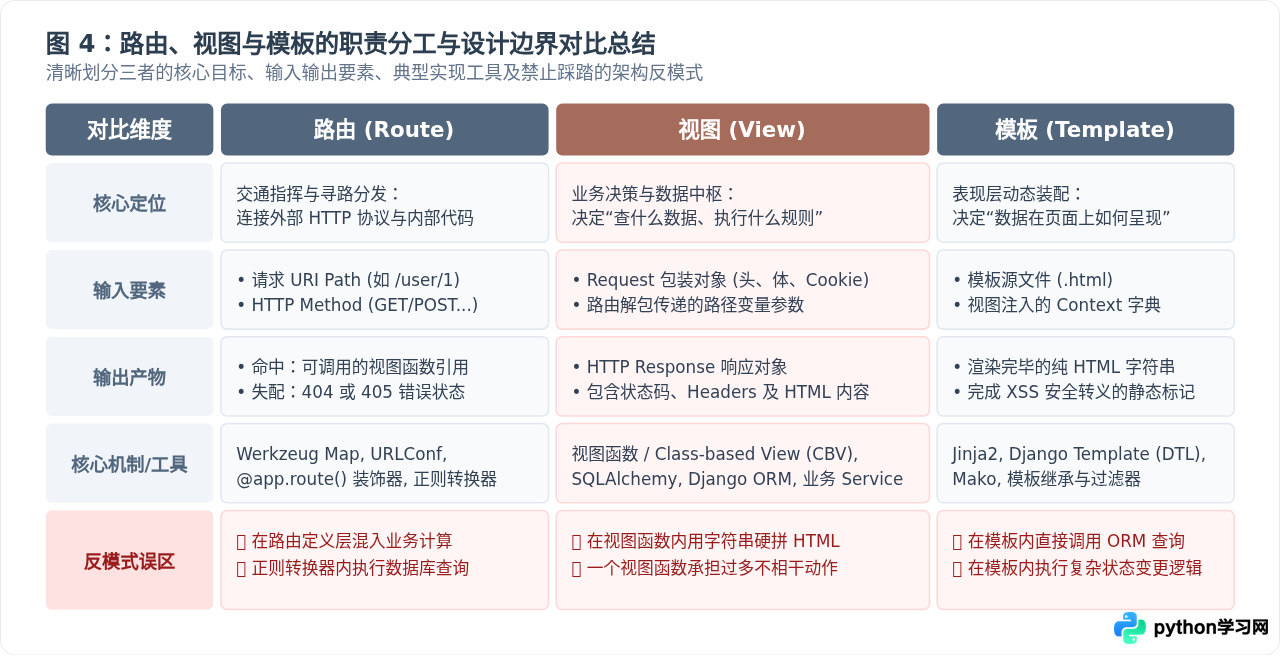
为了在实际编码中时刻保持清晰的界限,可以参考下表进行自我审查:
| 对比项目 | 路由(Route) | 视图(View) | 模板(Template) |
|---|---|---|---|
| 核心定位 | URL 寻路、参数解析与分发 | 业务处理中枢与上下文组织 | 表现层视图装配与安全呈现 |
| 输入内容 | HTTP 请求行(Path、Method) | Request 实体对象与路径参数 | HTML 骨架源文件与 Context 字典 |
| 产出物 | 匹配到的函数引用或 404/405 | 包装完毕的 HTTP Response | 组装并转义完毕的 HTML 字符串 |
| 典型反模式 | 在正则转换器中执行耗时查询 | 在视图内用 f-string 硬拼 HTML |
在模板标签内调用 ORM 发起 DB 查询 |
六、排查常见问题的实用思路
在日常开发和线上排错中,围绕这三者的异常往往有非常明显的分布规律:
- 404 Not Found:首要检查路由定义。常见原因包括末尾斜杠不匹配(例如定义了
/items/但访问了/items且框架未开启严格重定向)、参数转换器类型不符(例如把含有字母的编码传给了<int:id>),或者蓝图(Blueprint)未被主应用注册。 - 405 Method Not Allowed:表明路由路径已匹配成功,但客户端使用的 HTTP 请求方法(例如提交表单发送的 POST)不在该路由的
methods许可列表内。在对应装饰器中显式增加methods=['GET', 'POST']即可。 - 模板渲染变量为空或报错
UndefinedError:检查视图函数传递的context字典中键名是否与模板中的{{ variable }}拼写一致。在 Jinja2 默认配置下,缺失的变量会静默渲染为空字符串,常使初学者困惑。建议在开发调试环境中开启严格模式(如设置app.jinja_env.undefined = StrictUndefined),让缺失变量立刻显式抛出异常,便于迅速定位。 - 模板继承无效或样式错乱:确认子模板是否在首行正确声明了
{% extends 'base.html' %},并核实{% block content %}的块名称是否与基模板完全吻合。
理解路由、视图与模板的各自使命与协同流水线,是掌握 Python Web 框架乃至任何现代后端开发技术的基石。只要牢牢把握“路由管路径、视图管逻辑、模板管展现”的底线,就能编写出结构清晰、安全可靠且易于维护的高质量 Web 应用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









