

只会Excel还要学Python吗?对比两者的数据处理能力与学习成本

一、问题的实质:能力边界与任务场景的错配
许多数据处理人员在产生“要不要学Python”的困惑时,往往是因为遇到了现有工作流的卡点:文件打开缓慢、复杂的嵌套公式卡死电脑、或是每周需要花费数小时进行机械的跨表格复制粘贴。然而,盲目将工具升级直接等同于效率提升是一个常见误区。
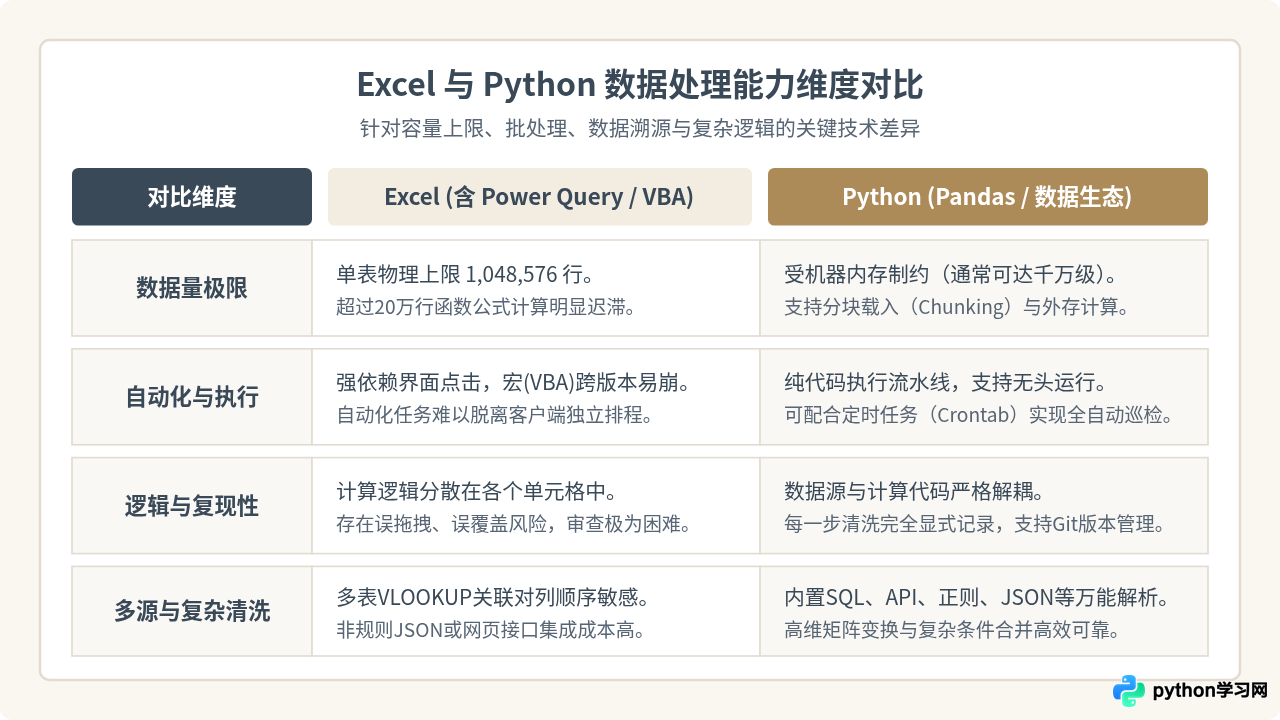
Excel 本质是一个面向“所见即所得”的电子表格应用,核心优势是交互探索、自由排版和即时计算;而 Python 是一门通用编程语言,其搭配的 Pandas、OpenPyXL 等数据处理库,本质是一套面向“工程化与可重现”的逻辑流水线。要决定是否学习 Python,首先必须客观解构两者的处理能力边界。
二、实操对比:以“跨表清洗与统计”为例
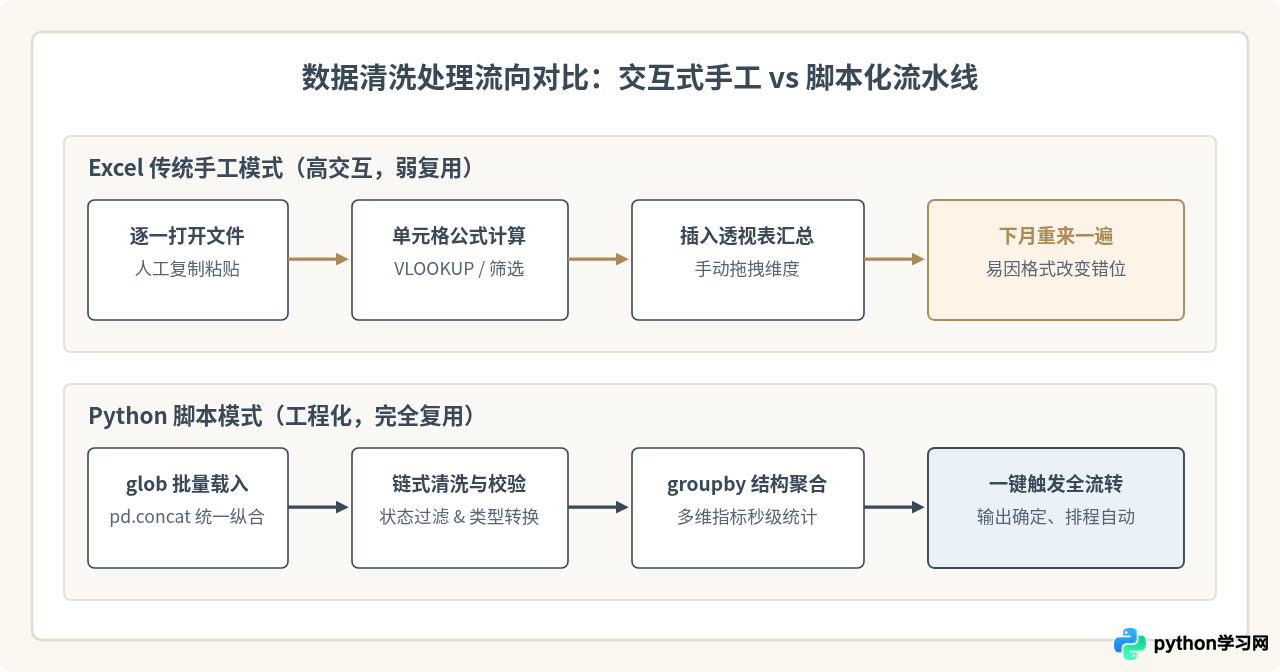
为了直观说明两者在具体操作方式上的差异,我们可以对比一个业务常见场景:每月需要合并12个门店提交的销售明细表,剔除退款与异常订单,按商品分类汇总毛利,并输出异常预警报告。
1. Excel 中的典型操作流
在不具备高级插件的情况下,多数用户的常规做法是逐一打开12个工作簿,复制数据粘贴到汇总主表中。随后编写 VLOOKUP 或 XLOOKUP 匹配商品信息,使用 IF 和 AND 过滤状态,最后插入数据透视表进行分组汇总。
这种流程存在两个固有隐患:其一是由于表格格式在收集过程中经常被改动(例如门店增加了备注列或打乱了顺序),直接复制会导致列错位;其二是操作步骤不可追溯,如果下个月要重新做一遍,必须全部重来,或者依赖容易报错的 VBA 宏。
2. Python (Pandas) 中的实现逻辑
在 Python 中,同样的操作体现为一段确定性的脚本。代码将目录下的所有文件批量读取并进行字段对齐,整个处理过程不需要人工打开任何表格,几秒钟即可完成。
import glob
import pandas as pd

# 1. 批量获取目录下所有门店表格
file_list = glob.glob("sales_data/store_*.xlsx")

# 2. 读取并垂直合并,统一规整
df_list = [pd.read_excel(f) for f in file_list]
raw_df = pd.concat(df_list, ignore_index=True)

# 3. 规整字段与条件过滤:剔除已退款订单,保留有效销售
clean_df = raw_df[raw_df['order_status'] != 'REFUNDED'].copy()

# 4. 类型转换与毛利计算
clean_df['amount'] = pd.to_numeric(clean_df['amount'], errors='coerce')
clean_df['cost'] = pd.to_numeric(clean_df['cost'], errors='coerce')
clean_df['gross_profit'] = clean_df['amount'] - clean_df['cost']

# 5. 分组聚合统计
summary = clean_df.groupby('category').agg(
    total_sales=('amount', 'sum'),
    total_profit=('gross_profit', 'sum'),
    order_count=('order_id', 'count')
).reset_index()

# 6. 导出结果
summary.to_excel("monthly_summary.xlsx", index=False)
通过这段代码可以看出,Python 处理数据的核心在于“构建固定管道”。不管下个月输入的是12个文件还是120个文件,只需点击一次运行,输出结果的逻辑与准确度完全一致。
三、学习成本的真实账本:从安装到上手的实际阻力
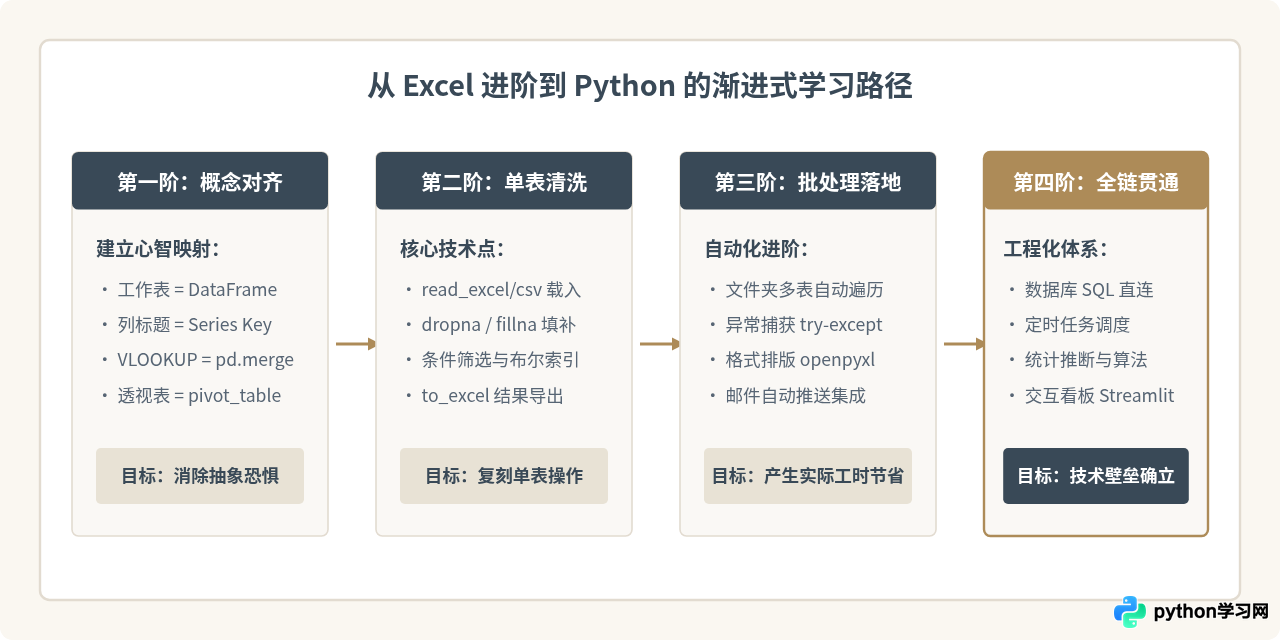
决定是否学习新工具时,不能只看技术收益,必须把学习成本算清楚。对于只有 Excel 经验的使用者来说,转向 Python 并不是“多学几个公式名称”,而是需要跨越四个实质性的思维与技能台阶:
| 学习阶段 | 需要掌握的核心内容 | 主要思维障碍与难点 | 平均耗时(周) |
|---|---|---|---|
| 阶段 1:环境与语法基础 | Python安装、虚拟环境、pip包管理、基本数据类型(列表/字典/字符串)、循环与判断 | 命令行操作陌生感;环境变量报错;缩进语法严格 | 1 ~ 2 周 |
| 阶段 2:Pandas核心操作 | DataFrame结构、切片筛选、merge关联、groupby分组聚合、缺失值处理 | 从“看到单元格”到“内存变量抽象”;索引(Index)与广播机制 | 2 ~ 3 周 |
| 阶段 3:文件自动化与IO | os/glob路径遍历、openpyxl格式写入、多工作表拆分合并、异常排查 | 文件编码问题(GBK/UTF-8);跨平台路径格式;错误提示阅读 | 1 ~ 2 周 |
| 阶段 4:工程化与定时排程 | 代码模块化封装、日志记录、Windows计划任务或定时触发 | 非交互式运行排错;依赖包版本兼容 | 1 周 |
总体而言,一个具备扎实 Excel 函数经验的人,投入大约 5 到 8 周(每周 6-8 小时)的针对性练习,才能达到独立编写实用脚本、替代日常机械操作的水平。如果日常数据任务本身复杂度低,这笔学习投资的“投资回报周期”可能会相当长。
四、选型判断:我到底应不应该学 Python?
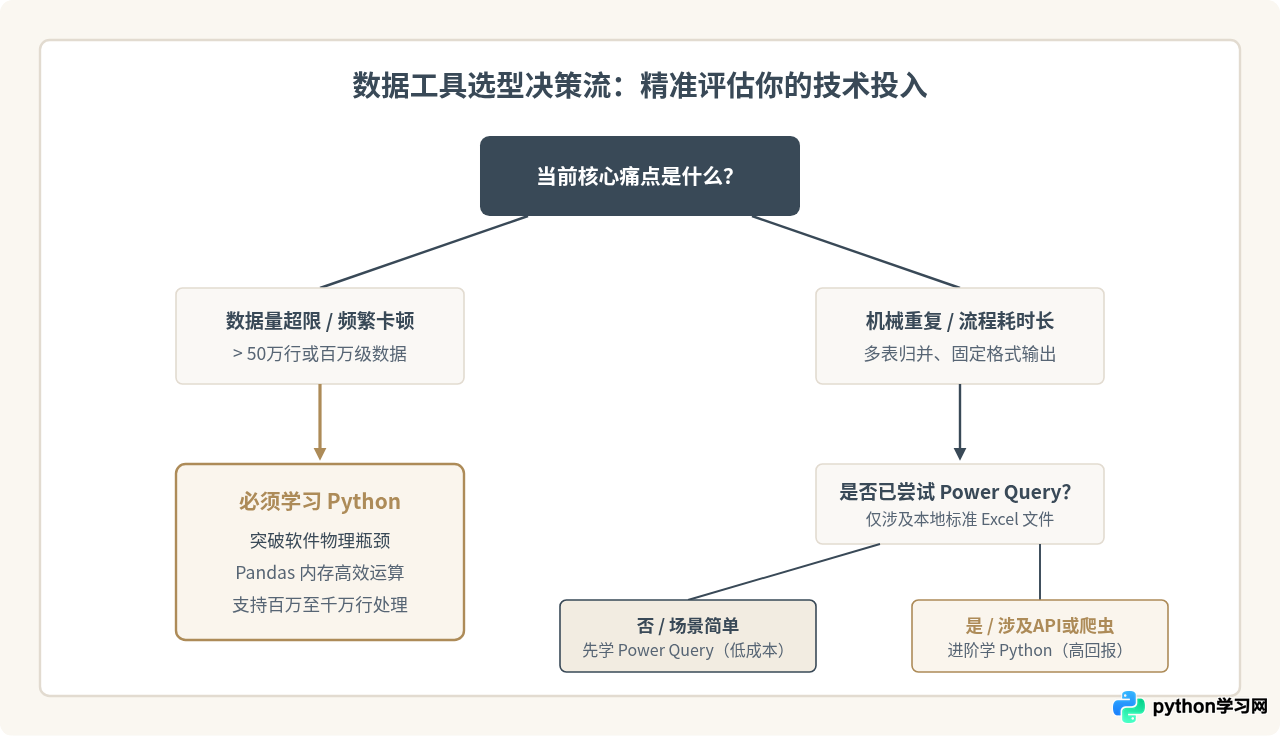
判断是否开始学习 Python,可以依据以下三条清晰的标准进行评估:
1. 建议继续深入使用 Excel(尤其是 Power Query)的场景
- 单次分析与即席查看:业务经常需要快速核对某笔订单、按领导要求临机拉一个3行的统计透视表。这种即时探索在 Excel 里只需十几秒,写代码反而过于笨重。
- 数据量始终处于中低水平:日常核心表格行数基本在 5 万行以下,文件体积在 20MB 以内,电脑运行流畅无卡顿。
- 重度依赖灵活格式美化:交付物是具有多级表头、复杂跨列合并、特定颜色填充和打印边距要求的财务汇报报表。Excel 在格式微调上的效率远胜代码。
2. 必须或强烈建议学习 Python 的场景
- 突破性能物理墙:经常需要处理几十万乃至数百万行的日志、订单或点击流数据,Excel 频繁卡死、崩溃,甚至无法直接打开文件。
- 多格式、多系统异构整合:需要直接对接企业数据库(MySQL/PostgreSQL)、读取非结构化 JSON、爬取特定规范的内部接口数据,或从数百个 PDF/Word 中提取表格。
- 固定流程的高频批处理:每个工作日都需要重复相同的数据清洗与合并操作,渴望将其完全交由后台自动执行并发送报告,消除人为错误。
- 需要严谨的审计与复现:医疗、审计、量化金融等领域要求每一步数据变换都能通过版本控制追踪审查,不允许存在单元格被不小心误改的“黑箱”。
五、总结:理性看待两者的协作关系
“只会Excel还要学Python吗?”这个问题的答案绝不是非此即彼的取代。在现代数据工作中,最高效的分析师往往采用“Python清洗提炼 + Excel汇报呈现”的协同组合:利用 Python 强大的自动化流水线完成底层海量数据的抽取、清洗与聚合,输出规范的小型汇总表;随后将汇总表放入 Excel 中,利用其出色的图表排版和切片器进行展示和交互。
先审视自己的实际工作阻力所在:如果当前瓶颈在于“量”与“自动化”,那么投资学习 Python 会带来明显的产出飞跃;如果核心诉求依然是“灵活查看”与“即时沟通”,那么把 Excel 及其进阶功能发挥到极致,依然是最经济明智的选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









