

为什么 Python 自定义类无法直接使用切片?实现 __getitem__ 支持

obj[...] 是一套通用的协议糖。原生自定义类之所以不能使用切片,是因为解释器在执行切片表达式时会将其打包为一个 slice 实例传入 __getitem__;若类未定义该魔术方法,会直接触发 TypeError;即便定义了 __getitem__,若代码仅按单一整数索引处理,同样会因类型不匹配而报错。要完整支持切片,必须在 __getitem__ 中针对 slice 类型进行分流与求值处理。
一、根本原因:方括号索引与切片的调用协议
在 Python 中,不仅列表、元组、字符串等内置类型可以使用 seq[1:4] 的切片操作,任何自定义对象在语法层面上都可以写方括号。然而,语法合法并不代表能正常运行。
当你尝试在一个纯空白的自定义类实例上使用切片时,Python 会立即中断执行:
class CustomList:
    def __init__(self, items):
        self._items = list(items)

obj = CustomList([10, 20, 30, 40, 50])
# 尝试使用切片语法
result = obj[1:3]
控制台会直接抛出以下异常(示例输出):
TypeError: 'CustomList' object is not subscriptable
报错信息中的“not subscriptable”意为“不支持下标访问”。Python 解释器在遇到形如 obj[key] 的表达式时,底层统一将其转换为对特殊方法 obj.__getitem__(key) 的调用。
这揭示了第一个原因:原生的自定义类默认没有实现序列协议的 __getitem__ 方法。
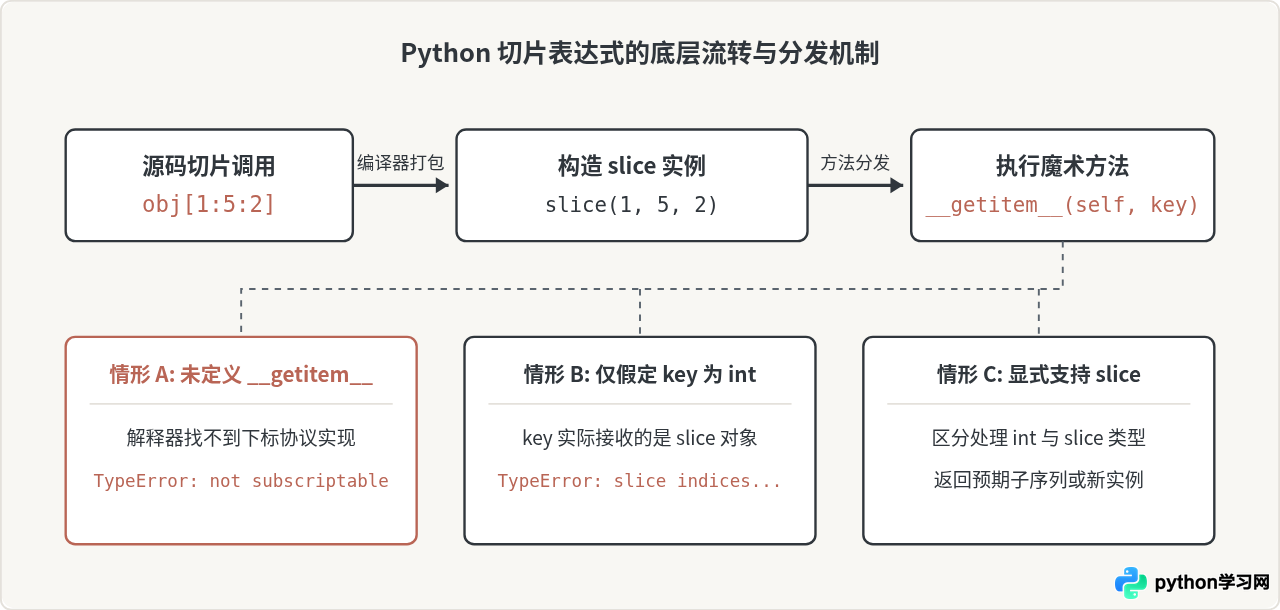
许多开发者在初学时会为类补上 __getitem__,但通常写成如下形式:
class CustomList:
    def __init__(self, items):
        self._items = list(items)

    def __getitem__(self, index):
        # 很多初学者假设 index 一定是整数
        return self._items[index]
此时运行 obj[1:3] 会发现它可以正常工作。但如果类内部不是简单委托给 Python 原生列表,而是自己维护指针、数据库游标或链表节点时,就会出现第二个更隐蔽的报错:
TypeError: slice indices must be integers or None or have an __index__ method
这说明:切片语法传入的根本不是下标数字,而是一个 slice 类的对象。如果不了解 slice 对象的结构,就无法自行完成切片解析。
二、解剖切片参数:深入认识 slice 对象
当你在方括号内写入 start:stop:step 时,Python 解释器会自动调用内置构造函数生成 slice(start, stop, step)。
| 切片语法表达式 | 传入 __getitem__ 的实际对象 | 说明 |
|---|---|---|
obj[2] |
2 (int) |
普通单元素索引 |
obj[1:5] |
slice(1, 5, None) |
未指定步长时 step 为 None |
obj[:3] |
slice(None, 3, None) |
起始省略时 start 为 None |
obj[::2] |
slice(None, None, 2) |
指定步长,起止均为 None |
obj[::-1] |
slice(None, None, -1) |
负步长反转切片 |
1. slice 对象的属性与限制
slice 实例是只读的,它主要包含三个属性:start、stop 和 step。
需要特别注意,当切片表达式中省略某一部分时,对应属性的值并不是具体的整数数值,而是 None。如果你直接拿 slice.start 进行数学运算(例如计算切片长度 slice.stop - slice.start),就会由于 NoneType 引发报错。
2. 核心辅助方法:slice.indices(length)
为了帮助开发者从容应对省略的 None、负数索引以及越界索引,Python 内置的 slice 对象提供了一个非常强大但常被忽略的原生方法:slice.indices(length)。
这个方法接收容器当前的有效长度 length,并返回一个规整化后的三元组 (start, stop, step),其中所有的 None、负数以及越界边界都已被转换成可直接用于 range() 的合规正整数:
s = slice(None, None, -1)
# 假设容器当前长度为 5
print(s.indices(5))
# 示例输出: (4, -1, -1) —— 正好覆盖索引 4, 3, 2, 1, 0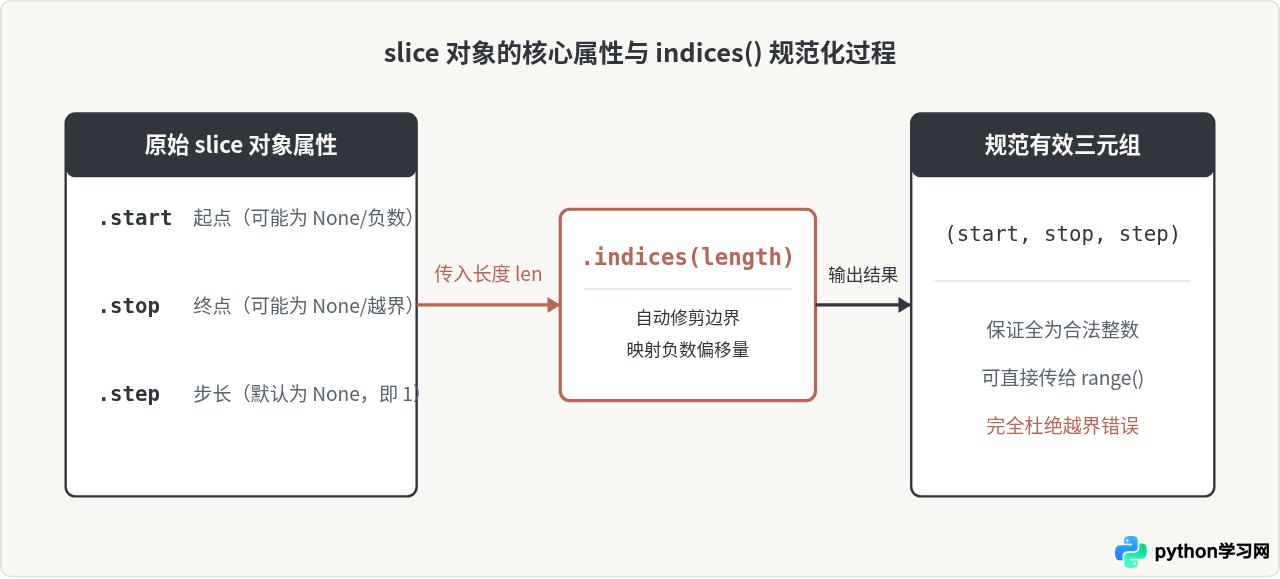
三、完整实现:为自定义类添加切片支持
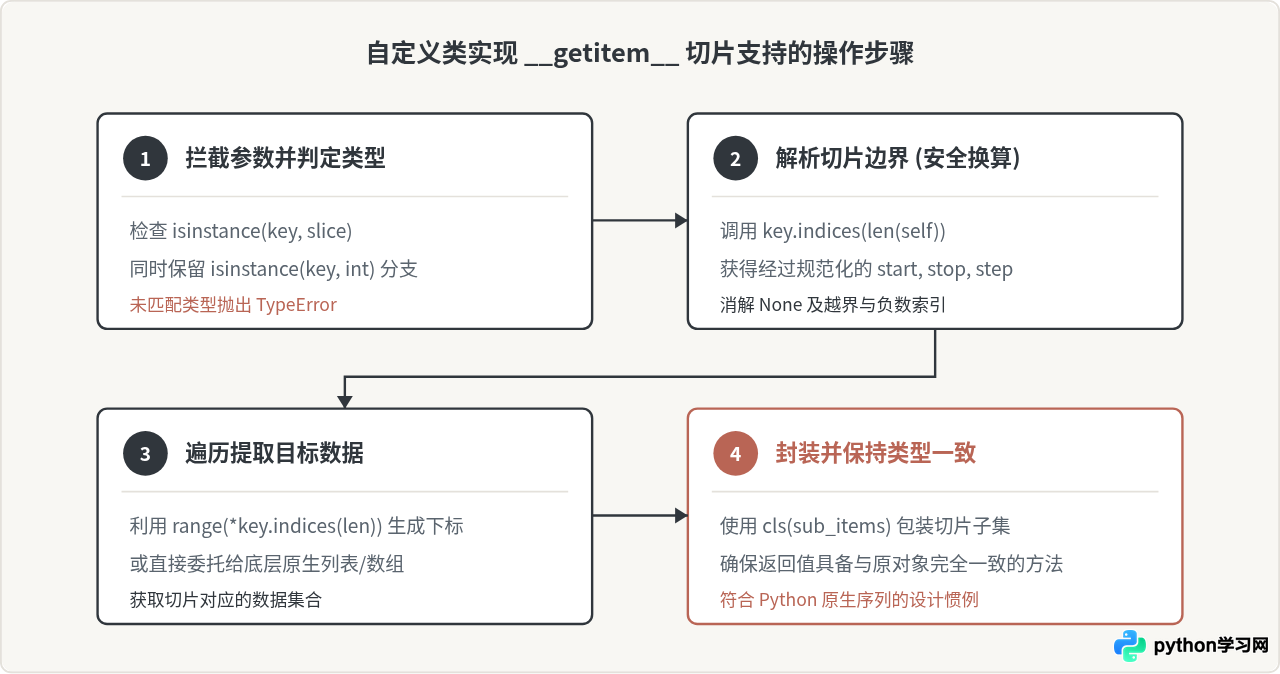
要编写一个健壮、符合 Python 惯用习惯的自定义序列类,支持切片的核心在于以下四步:
- 实现
__len__方法:定义序列的长度边界,为indices()计算和负数解析提供依据。 - 在
__getitem__中进行类型判断:区分单整数索引(int)与切片请求(slice)。 - 根据类型分流执行:整数索引直接返回对应元素;切片对象提取区间数据。
- 返回合适类型的结果:常规切片操作应返回同类的新实例,或根据业务需求返回派生数据。
代码实现范例:自定义受保护序列
下面给出一个完整的实现范例。这个自定义类不单纯返回原生 list,而是把切片结果重新包装成该类的新实例,完美体现序列的一致性:
class CustomSequence:
    def __init__(self, iterable=None):
        # 内部使用列表保存元素
        self._data = list(iterable) if iterable is not None else []

    def __len__(self):
        return len(self._data)

    def __getitem__(self, index):
        cls = type(self)

        # 1. 处理切片逻辑
        if isinstance(index, slice):
            # 方案 A: 若内部容器本身支持切片,可直接委托
            sliced_data = self._data[index]
            # 返回当前类的新实例,保持类型纯粹
            return cls(sliced_data)

        # 2. 处理单整数索引逻辑
        elif isinstance(index, int):
            return self._data[index]

        # 3. 拒绝非法索引类型
        else:
            msg = f"{cls.__name__} 索引必须是整数或切片对象,而非 {type(index).__name__}"
            raise TypeError(msg)

    def __repr__(self):
        return f"{type(self).__name__}({self._data})"
执行以下代码来验证切片支持:
# 实例化
seq = CustomSequence(['Python', 'Go', 'Rust', 'Java', 'C++'])

# 1. 验证常规整数索引
print(seq[0])        # 输出: Python

# 2. 验证正向切片
sub_seq1 = seq[1:4]
print(sub_seq1)      # 输出: CustomSequence(['Go', 'Rust', 'Java'])
print(type(sub_seq1))# 输出: <class '__main__.CustomSequence'>

# 3. 验证步长与逆序
sub_seq2 = seq[::-1]
print(sub_seq2)      # 输出: CustomSequence(['C++', 'Java', 'Rust', 'Go', 'Python'])
自行解析底层数据:非委托场景下的底层计算
如果你的自定义类并不依赖内置的 list(例如自定义二叉树、链表、动态生成数据的只读算术数列等),底层没有直接支持切片的数据结构,就需要手动利用 indices() 来生成索引:
class ArithmeticProgression:
    """按公式动态生成等差数列项,不预先分配内存"""
    def __init__(self, start_val, step_val, length):
        self.start_val = start_val
        self.step_val = step_val
        self.length = length

    def __len__(self):
        return self.length

    def __getitem__(self, index):
        if isinstance(index, int):
            if index < 0:
                index += self.length
            if not (0 <= index < self.length):
                raise IndexError("等差数列索引越界")
            return self.start_val + index * self.step_val

        elif isinstance(index, slice):
            # 手动通过 indices 解析起止和步长
            start, stop, step = index.indices(self.length)
            # 使用列表推导式依据计算公式逐项生成
            return [self.start_val + i * self.step_val for i in range(start, stop, step)]

        raise TypeError("索引必须为整数或切片")

ap = ArithmeticProgression(start_val=10, step_val=5, length=10)
# 数列数据: [10, 15, 20, 25, 30, 35, 40, 45, 50, 55]
print(ap[2:7:2])  # 示例输出: [20, 30, 40]
四、注意事项与进阶考量
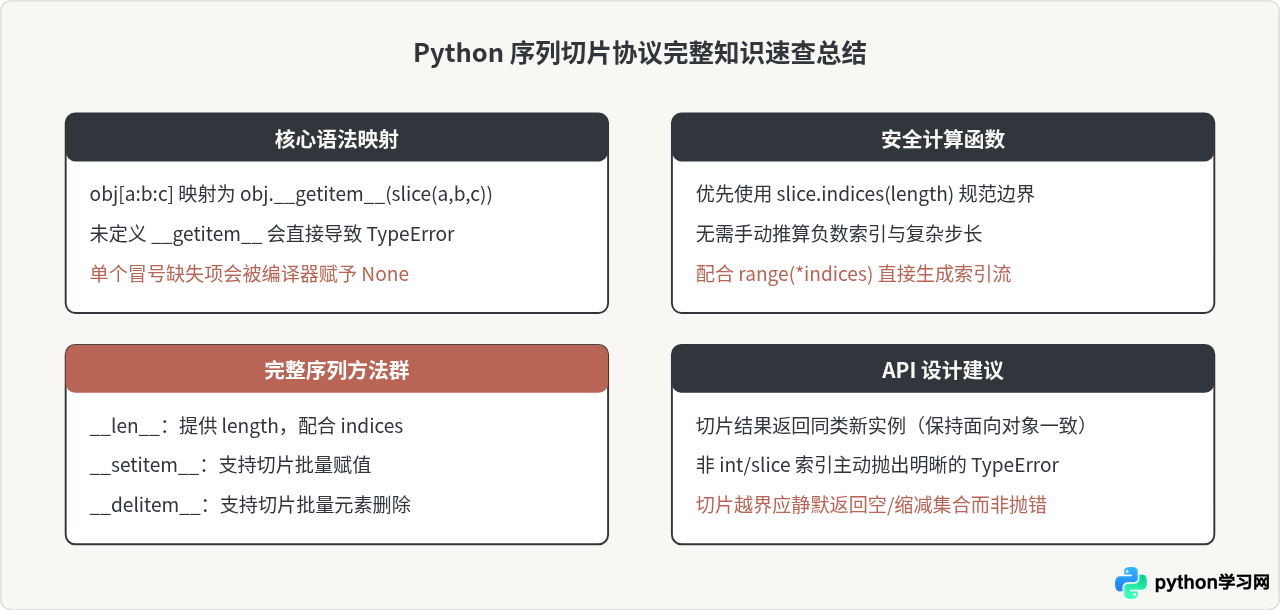
如果你希望自定义类还支持切片赋值(如 obj[1:3] = [99, 100])或切片删除(如 del obj[::2]),则必须同样重写 __setitem__(self, key, value) 与 __delitem__(self, key),并在方法内部同样增加对 isinstance(key, slice) 的分流处理。
切片返回什么类型?Python 原生列表切片返回新 list,字符串切片返回新 str。因此,当构建容器类时,通常建议返回该自定义类的新实例,这样切片结果能够无缝调用该类的成员方法,链式操作更加自然。如果仅作为临时查看视图,返回内置 list 也是一种务实轻量的选择。
五、总结
Python 自定义类无法直接使用切片的原因非常简单直接:切片本质上是方括号索引协议的高阶表达,解释器在执行时会构造 slice 实例并传入 __getitem__。自定义类在默认情况下既未声明该协议接口,也没有对传入的 slice 参数做类型辨析。
要实现高质量的切片支持,关键就在于在 __getitem__ 中利用 isinstance(key, slice) 进行类型分支拦截。对于内部封装了序列对象的类,可直接委托给底层数据;对于非连续或算法型数据结构,善用 slice.indices(len) 方法进行规范化边界计算,便能以最优雅、规范的方式赋予自定义类与内置序列完全一致的切片体验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









