

提升Cursor代码生成准确率的Prompt编写技巧

一、Cursor 代码生成失准的根源分析
很多开发者在日常使用 Cursor 时,常遇到代码跑偏、引入不存在的第三方库、改动无关历史逻辑等现象。这些问题通常并非底层大语言模型(如 Claude 或 GPT-4)能力不足,而是由输入层面的信息不对称导致的:
- 上下文缺失或过载:给出的提示词过于抽象(如“帮我写个用户登录逻辑”),模型无法预知工程内部的现有数据模型、加密方式及状态管理方案;或者无节制使用全仓扫描,引入过多无关代码造成注意力分散。
- 技术栈与版本约束缺位:未显式指明依赖库的版本号或风格规范,导致模型默认使用旧版语法或废弃 API。
- 缺乏输出范围契约:未限定改动范围,模型倾向于过度重构上下文中的现有代码,破坏已有业务逻辑。
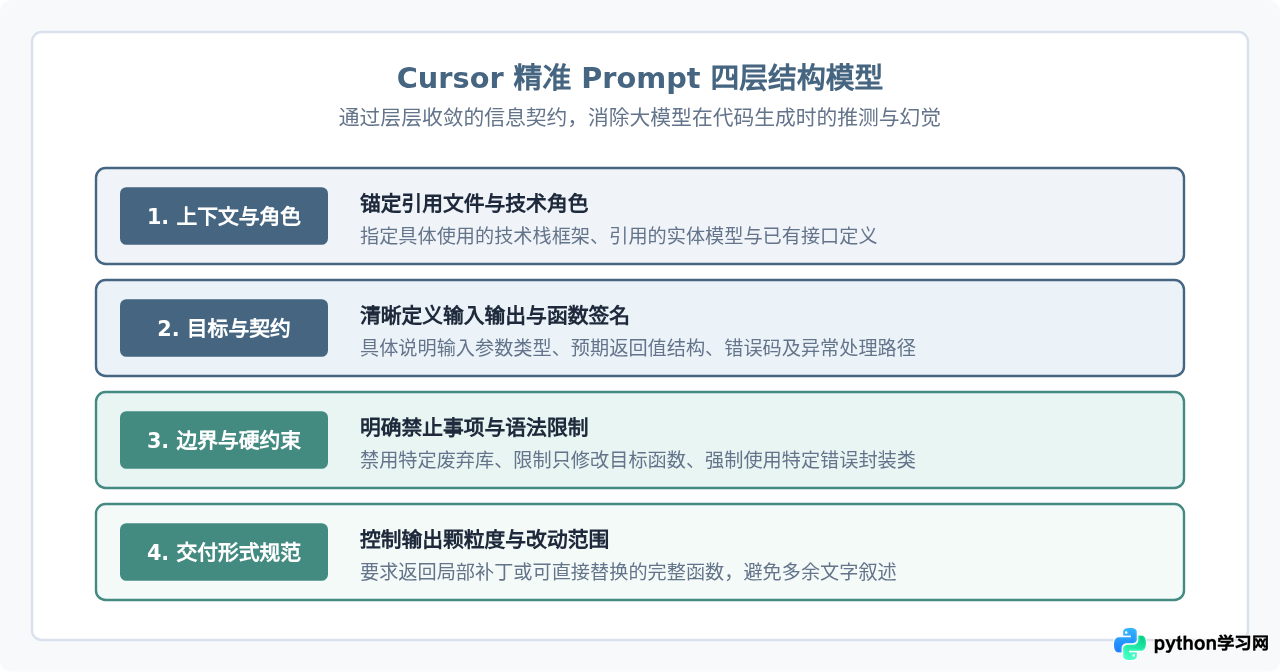
二、精准提示词的结构化设计范式
为了让 Cursor 输出高质量代码,提示词应当遵循“模块化与契约化”设计。一个完整的工程化 Prompt 包含以下四个要素:
- 任务目标(Goal):一句话阐明本次编写或重构的具体目标,名词与动词需准确。
- 输入输出契约(I/O Contract):明确输入参数格式(如 TypeScript interface、Python dataclass 或 Pydantic 模型)及返回值规范。
- 限制条件(Constraints):包括禁止引入新外部依赖、必须使用当前项目的统一错误处理机制、不可修改已有公共函数等。
- 验证用例(Test Case):提供 1 到 2 个极简的边界测试输入,作为模型内部逻辑推演的参照基准。
“帮我写一个解析 CSV 文件的 Python 函数,要能处理异常,把数据转成字典列表返回。”
问题:未说明 CSV 编码、分隔符、大文件是否需要流式处理、字段类型转换规则以及具体的异常返回形式,生成代码大概率需要反复二次修改。
“编写 Python 函数 parse_order_csv(file_path: str) -> list[dict]:
1. 使用内置 csv 模块,支持 utf-8-sig 编码。
2. 必须包含列:order_id (str), amount (float), status (str)。
3. 若某行 amount 转换失败,记录错误并跳过,不中断后续行。
4. 统一抛出自定义异常 OrderDataError 并携带行号。”
三、巧用 @ 符号进行精准上下文注入
在 Cursor 中,Prompt 的质量有一半取决于随附的上下文信息。滥用 @Codebase 会使注意力机制受无关代码稀释,而纯文字描述又容易导致类型失准。
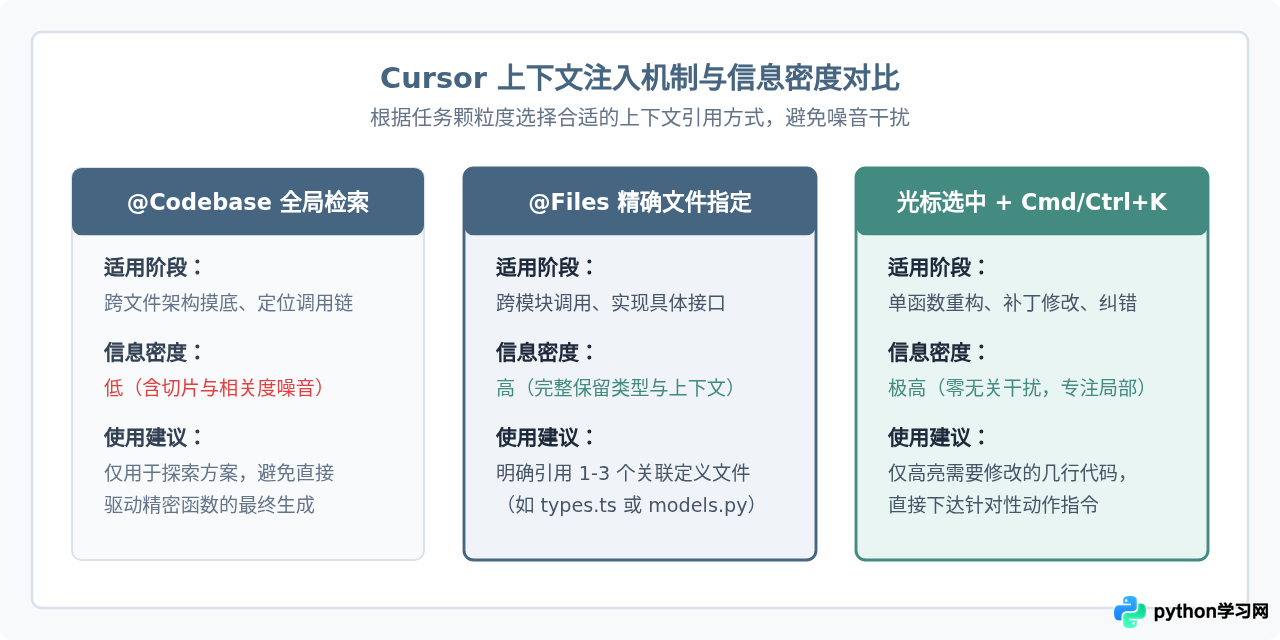
1. 善用 @Files 精确附带类型定义
当需要编写一个新服务或组件时,最有效的方式是通过 @Files 直接把依赖的类型定义文件(如 types/user.ts)和配置常量(如 config.ts)挂载进输入中。模型拥有明确的类型约束后,代码自动补全的参数命名与类型会与原项目严丝合缝。
2. 借助 @Docs 锁死特定库版本
很多开源工具(如 Next.js App Router、LangChain、Pydantic V2)经历了大版本重构,模型的预训练权重容易混淆新旧 API。在 Cursor 中通过 @Docs 引入官方最新文档链接,能彻底阻断废弃写法的产生。
四、标准生成流程:从需求到采纳的四步工作流
高效利用 Cursor 并不是一次性生成完整模块,而是将其拆解为确定性的小步迭代。推荐采用如下闭环操作流程:
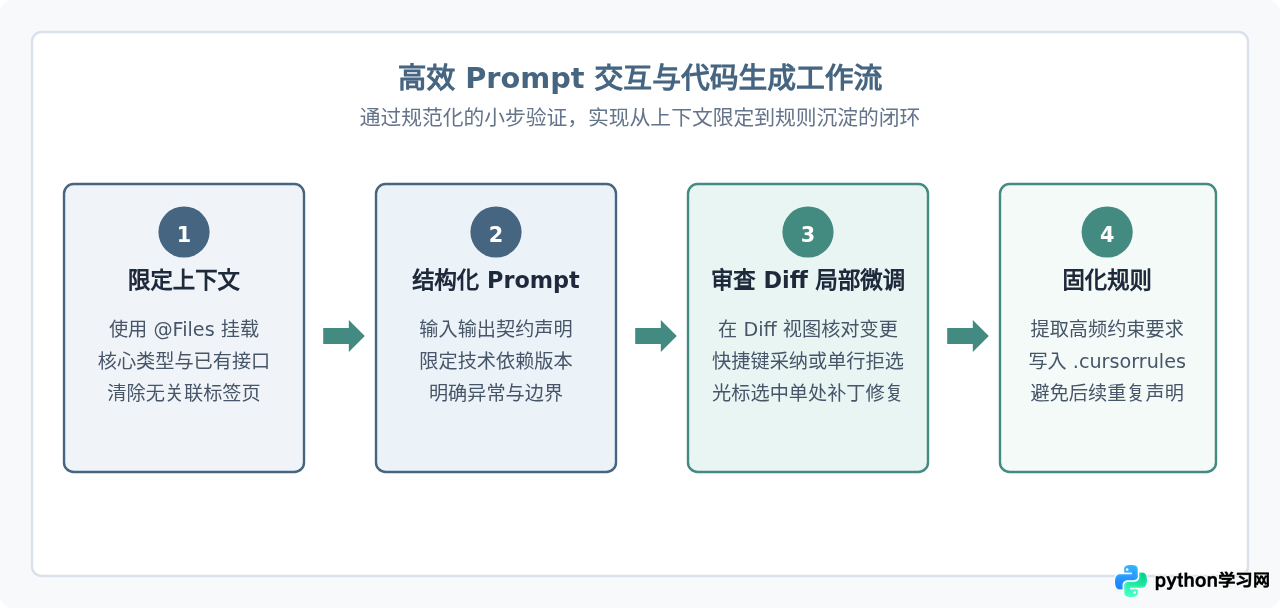
第一步:限定上下文。在触发生成前,通过 Command/Ctrl + P 确认当前只打开目标涉及的几个文件,用 @Files 指向关键基础模块,杜绝无关信息干扰。
第二步:结构化 Prompt。使用带有目标、入参约束、边界逻辑的提示词模板,一次只下达一个具体的实现指令。
第三步:审查 Diff。生成完成后,Cursor 会以 Diff(绿增红删)展示变动。逐块审阅代码,发现局部瑕疵时,不要在全局对话重新生成,而是用鼠标选中该片段直接使用 Cmd/Ctrl + K 要求局部重构。
第四步:沉淀系统规则。如果发现模型经常犯某一类习惯性错误(如引入已被禁用的旧语法、或者少加类型注释),立刻将其沉淀为工程级规则配置。
五、编写工程级 .cursorrules 降低单次提示词负担
在项目中维护一个 .cursorrules 文件(通常存放在项目根目录),相当于为当前仓库挂载全局系统级 Prompt。将通用技术选型与规范预设在规则中,单次交互时就无需反复重复相同指令。
# .cursorrules 实用工程配置示例
- 技术栈:TypeScript 5.x + React 18 + TailwindCSS + Next.js App Router
- 编码标准:
  * 所有组件必须使用命名导出(named export),不使用 default export
  * 涉及异步请求统一使用封装好的 @/lib/api-client,禁止直接使用全局 fetch 或 axios
  * 处理表单必须使用 react-hook-form + zod 进行模式校验
- 代码生成约束:
  * 只修改用户明确指定的函数或代码块,严禁无故改动已存在的周围代码
  * 遇未明确类型时,优先在 @/types/index.ts 中寻找已有接口,禁止随意使用 any
* 所有对外抛出错误必须使用自定义 AppError 类六、提升准确率的实操技巧总结
代码生成工具的输出质量直接反映出输入信息的完备性。下表总结了在日常使用 Cursor 过程中提升代码准确率的关键准则与常见反模式:
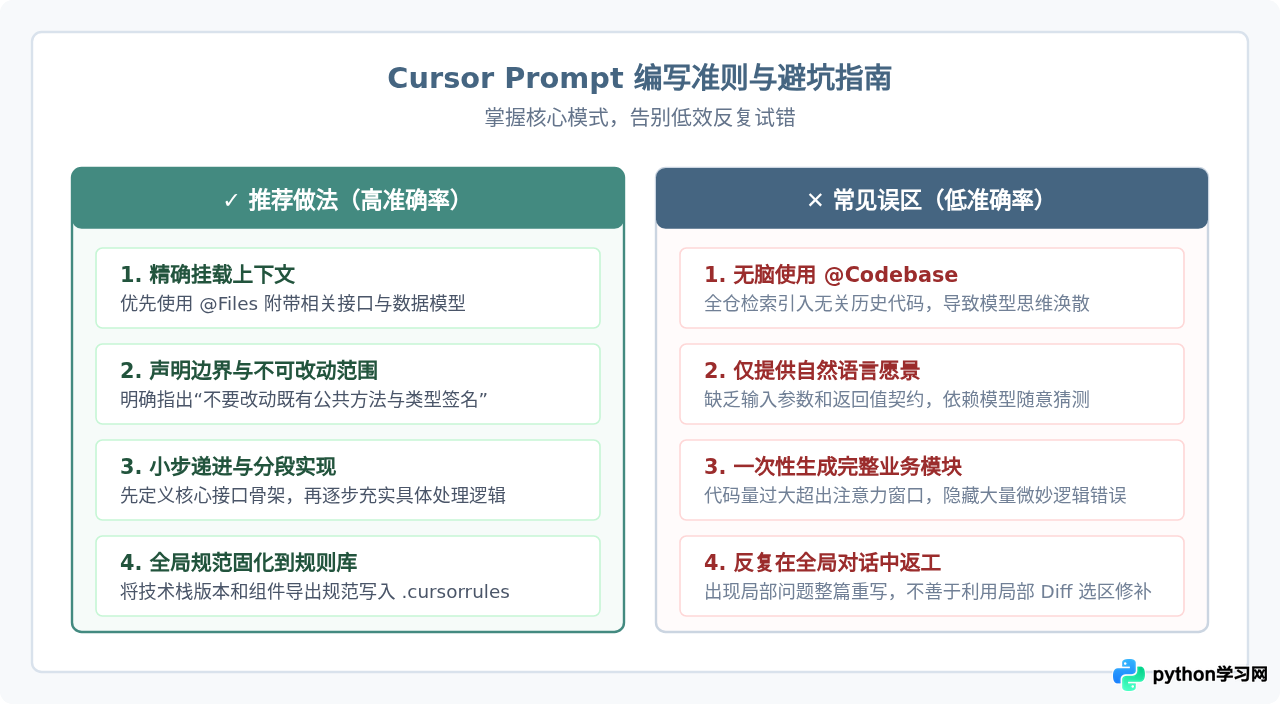
通过构建结构化 Prompt、精准约束引用上下文、配合局部微调机制与 .cursorrules 全局规则,开发者可以显著降低返工率,使 Cursor 从“概率性猜代码”转变为“确定性交付代码”的趁手生产力工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









