

Python集合运算报错 TypeError:unhashable type 怎么解决?

在 Python 中进行集合运算(如创建集合、调用 add()、进行交集 &、并集 | 或差集 - 运算)时,如果遇到 TypeError: unhashable type 报错,其核心原因是你试图将可变对象(如列表 list、字典 dict、集合 set)放入了集合中,或者参与运算的元素不具备稳定的哈希值。解决这一问题的直接路径是:将不可哈希的可变对象转换为对应的不可变结构——列表转为元组(tuple)、普通集合转为冻结集合(frozenset)、字典转为其键值项的排序元组或特征键;若对象本身无法冻结,则改用基于特征提取的迭代去重逻辑。
一、报错成因:为什么集合元素必须是“可哈希”的?
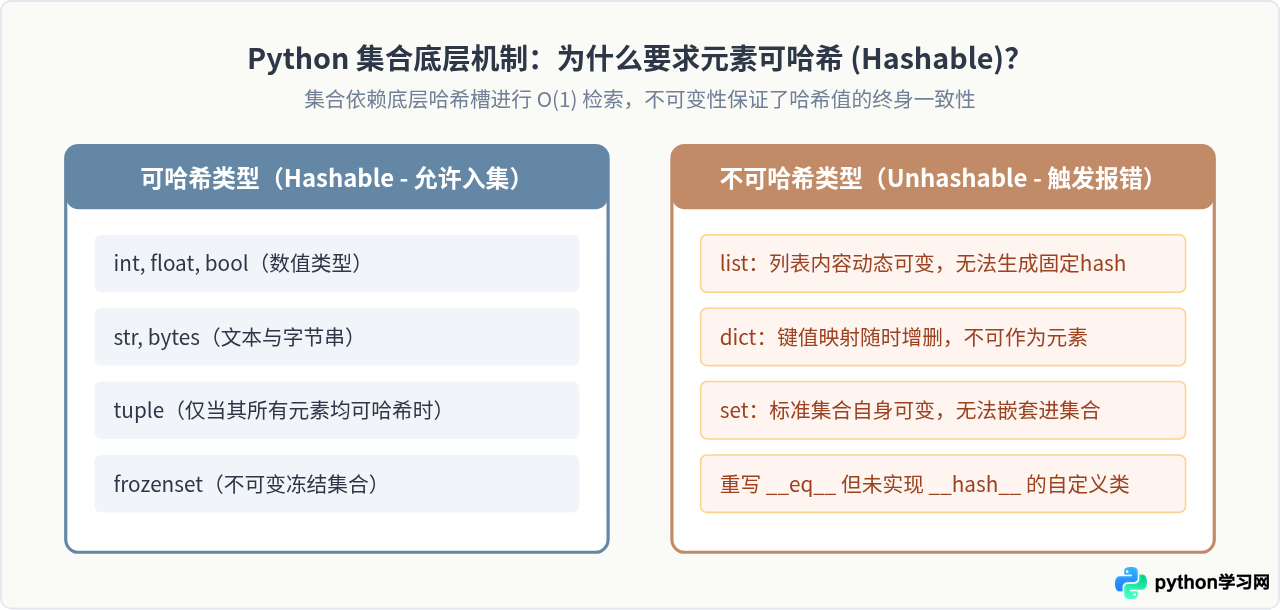
Python 中的集合(set)底层是基于哈希表(Hash Table)实现的。哈希表能够提供平均时间复杂度为 \(O(1)\) 的快速元素查找、插入与去重。为了让哈希表正常工作,存储在其中的每一个元素都必须满足一个刚性前提:可哈希(Hashable)。
一个对象要被称为可哈希,必须具备两个条件:
- 在对象的整个生命周期中,由
__hash__()返回的哈希值必须始终保持不变。 - 对象必须实现
__eq__()方法,且哈希值相等的对象在比较相等时必须逻辑一致。
在 Python 内置数据结构中,数字(int、float)、字符串(str)、元组(tuple)和冻结集合(frozenset)属于不可变类型,它们的值一旦创建就无法修改,因此哈希值终身不变,属于可哈希类型。相反,列表(list)、字典(dict)和集合(set)属于可变类型,内部内容随时可以追加或删除。如果允许将列表放入集合,一旦后续修改了列表内容,该列表原先计算出来的哈希值与位置将彻底脱节,破坏哈希表的完整性,因此 Python 从语言层面禁止它们作为哈希键或集合元素,直接抛出 TypeError: unhashable type。
二、常见报错触发场景与溯源定位
在日常开发中,该报错往往不是显式调用 hash() 引起的,而是隐藏在集合初始化、去重操作或集合代数运算中。定位该问题时,可对照终端输出的 Traceback 进行回溯:
1. 直接嵌套或向集合追加容器
# 错误示例 1:集合推导式或直接字面量
s = {[1, 2], [3, 4]}
# 输出:TypeError: unhashable type: 'list'

# 错误示例 2:调用 add 追加列表
s = {1, 2}
s.add([3, 4])
# 输出:TypeError: unhashable type: 'list'
2. 对包含复杂结构的列表进行集合去重
很多开发者习惯用 set(raw_list) 对列表快速去重。如果 raw_list 里面包含的是二维列表、字典或接口返回的 JSON 对象数组,该语句会立即崩溃:
# 错误示例 3:字典列表快速去重
user_records = [{"id": 1, "name": "Alice"}, {"id": 2, "name": "Bob"}]
unique_users = set(user_records)
# 输出:TypeError: unhashable type: 'dict'
3. 集合嵌套(集合的集合)
在图论或组合算法中,常需要保存一组顶点子集。直接写成嵌套集合会触发异常:
# 错误示例 4:构建集合的集合
cliques = {{1, 2}, {2, 3}}
# 输出:TypeError: unhashable type: 'set'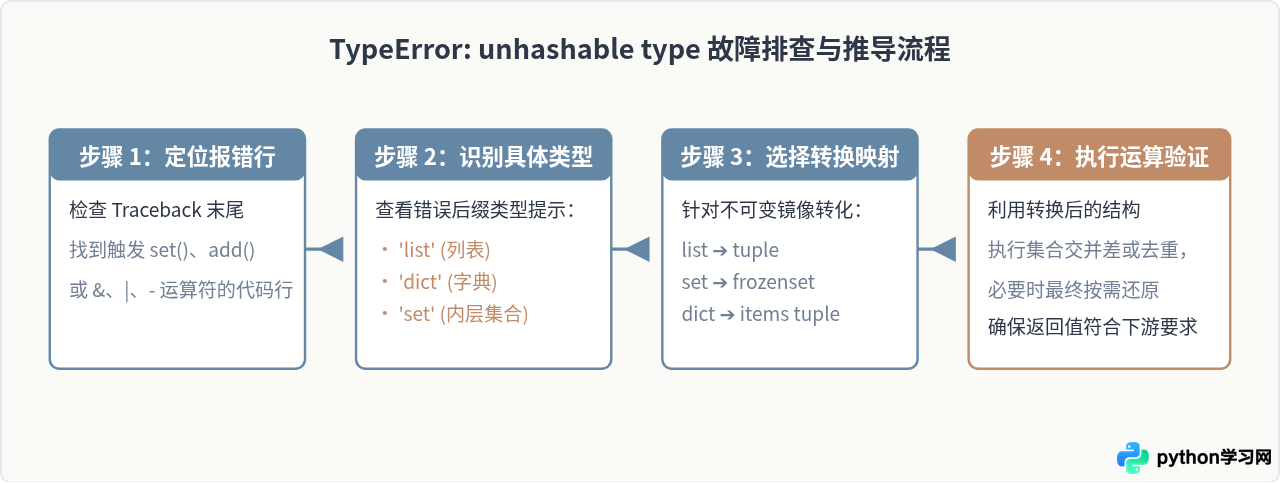
三、四大典型场景的修复方案与完整代码
场景 1:元素是列表(list)——转换为元组(tuple)
列表和元组的核心区别就在于可变性。如果需要将一组子列表放进集合中去重或做集合运算,应先将每一个列表转换为不可变的 tuple。
# 原始带有子列表的数据
coordinates = [[12.5, 45.2], [10.1, 30.4], [12.5, 45.2]]

# 修复方案:使用列表推导式或 map 转为 tuple 后构建集合
unique_coords_set = {tuple(item) for item in coordinates}
print("去重后的元组集合:", unique_coords_set)
# 输出: {(10.1, 30.4), (12.5, 45.2)}

# 若下游流程必须使用列表,可根据需要转回
unique_coords_list = [list(item) for item in unique_coords_set]
print("还原后的列表:", unique_coords_list)
# 输出: [[10.1, 30.4], [12.5, 45.2]]
场景 2:元素是集合(set)——转换为不可变集合(frozenset)
Python 专门提供了不可变集合类型 frozenset。它保留了集合无序、不重复的特性以及所有只读集合运算(如 &、|、issubset),同时具备哈希值,可以作为字典的键或其他集合的元素。
# 需要处理的一组权限集合
admin_perm = {"read", "write", "delete"}
editor_perm = {"read", "write"}
guest_perm = {"read"}

# 修复方案:将内层集合包装为 frozenset
roles_set = {frozenset(admin_perm), frozenset(editor_perm), frozenset(guest_perm)}
print("合法嵌套集合:", roles_set)

# 集合包含性检测
query_perm = frozenset({"read", "write"})
if query_perm in roles_set:
    print("匹配到对应角色权限集合")
场景 3:元素是字典(dict)——根据业务诉求分流处理
字典本身是无法直接哈希的。面对字典列表去重或并集运算,通常有两种处理思路:
思路 A:整条字典完全相同时去重。将字典的 items() 排序后转换成元组,使之成为可哈希结构:
users = [
    {"id": 1, "role": "admin"},
    {"id": 2, "role": "user"},
    {"id": 1, "role": "admin"}  # 重复项
]

# 将字典转为排序后的键值元组
def dict_to_hashable(d):
    return tuple(sorted(d.items()))

# 集合去重后再转回字典
unique_users = [dict(t) for t in {dict_to_hashable(u) for u in users}]
print("完整去重结果:", unique_users)
# 输出: [{'id': 1, 'role': 'admin'}, {'id': 2, 'role': 'user'}]
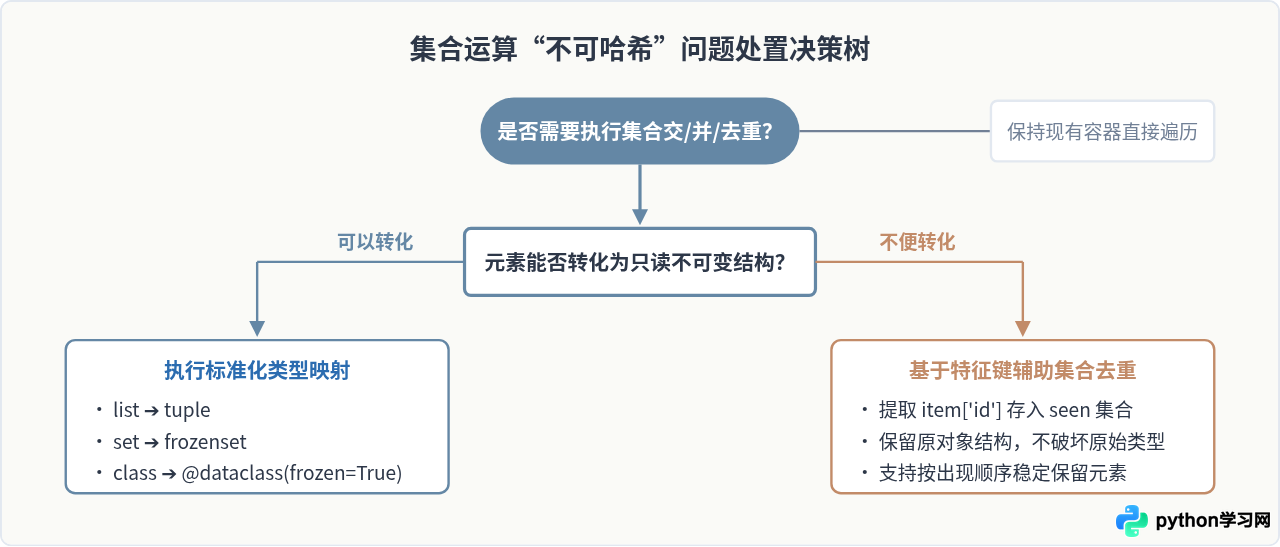
思路 B:依据唯一主键(如 ID)去重。很多业务场景并不需要把整个字典做哈希,只要按关键字段过滤即可。利用辅助集合记录已处理的唯一标识:
def deduplicate_by_key(items, key):
    seen = set()
    result = []
    for item in items:
        val = item[key]
        if val not in seen:
            seen.add(val)
            result.append(item)
    return result

cleaned = deduplicate_by_key(users, key="id")
print("按主键去重结果:", cleaned)
场景 4:自定义类对象——正确补全 __hash__ 与 __eq__
在 Python 中,用户自定义类默认继承自 object,默认具备基于内存地址的 __hash__。但当你为类重写了 __eq__(用于比较两对象属性是否相等)却未显式定义 __hash__ 时,Python 会自动将 __hash__ 置为 None,以防止逻辑矛盾,此时将其实例加入集合就会报错。
# 推荐做法 1:使用标准库 dataclass 并声明 frozen=True
from dataclasses import dataclass

@dataclass(frozen=True)
class Point:
    x: int
    y: int

p1 = Point(1, 2)
p2 = Point(1, 2)
p3 = Point(3, 4)

point_set = {p1, p2, p3}
print("数据类集合长度:", len(point_set))  # 输出: 2(自动完成去重)

# 推荐做法 2:手动实现 __eq__ 与 __hash__
class Node:
    def __init__(self, node_id, label):
        self._node_id = node_id
        self._label = label

    @property
    def node_id(self):
        return self._node_id

    def __eq__(self, other):
        if not isinstance(other, Node):
            return False
        return self._node_id == other._node_id

    def __hash__(self):
        # 挑选不可变的标识属性参与哈希计算
        return hash(self._node_id)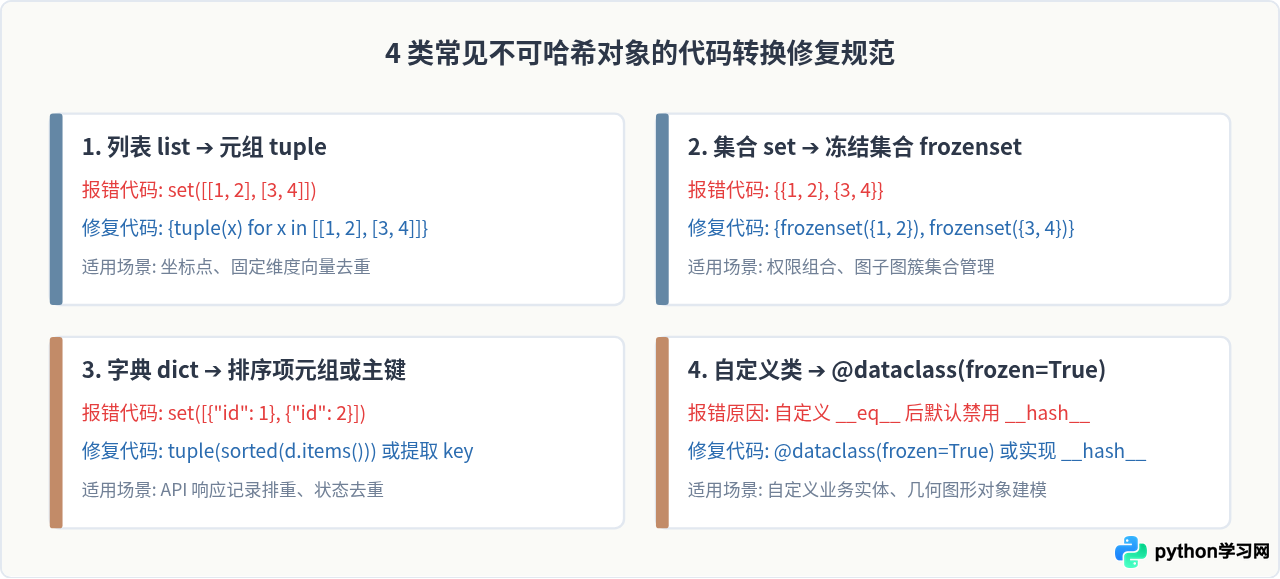
四、避坑要点与验证检查清单
在实施类型转换以修复 TypeError 期间,还需要特别注意以下几个隐蔽的逻辑边界:
tuple 只是容器本身不可变。如果元组内部元素包含列表,例如 t = (1, [2, 3]),执行 hash(t) 依然会报 TypeError: unhashable type: 'list'。因此做转换时必须确保是深度转换(Deep Conversion)。
| 原始数据结构 | 转换目标 | 时间复杂度 | 核心注意事项 |
|---|---|---|---|
list(一维) |
tuple |
\(O(N)\) | 保证列表中每个子项也是不可变的。 |
set(集合) |
frozenset |
\(O(N)\) | 冻结后不可再执行 add()、remove()。 |
dict(扁平键值) |
tuple(sorted(d.items())) |
\(O(K \log K)\) | 键和值本身必须均可哈希;对嵌套字典需递归转换。 |
| 自定义对象 | frozen dataclass |
\(O(1)\) | 参与哈希计算的字段在对象创建后不可修改。 |
五、总结
遇到 TypeError: unhashable type 时,无需修改 Python 底层设置或寻找特殊的第三方模块。只要牢记核心逻辑:Python 集合元素必须具备不可变性与固定哈希值。根据实际数据结构,将列表转为 tuple、集合转为 frozenset、复杂字典提取关键字段或序列化为元组,即可在维持原有集合代数特性的同时,彻底消除报错。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









