

怎么解决AI短剧中角色面部不一致和画面闪烁问题

当观众沉浸在AI短剧的剧情中时,最破坏体验的往往不是剧本的逻辑漏洞,而是主角在下一个镜头突然“换了张脸”,或者背景中的树木像触电般疯狂抖动。这种视觉上的断裂感,被称为“身份漂移”和“时间闪烁”,是目前生成式视频工具尚未完全攻克的顽疾。对于创作者而言,这不仅是技术瑕疵,更是叙事可信度的杀手。
解决这一问题不能仅靠运气或反复重抽卡,而需要建立一套从静态图像到动态视频的稳定性控制工作流。核心逻辑在于:用确定的约束对抗生成的随机性。无论是通过固定参考源来锁定角色特征,还是通过限制运动幅度来减少像素级的剧烈重组,本质上都是在向AI明确“什么不能变”。
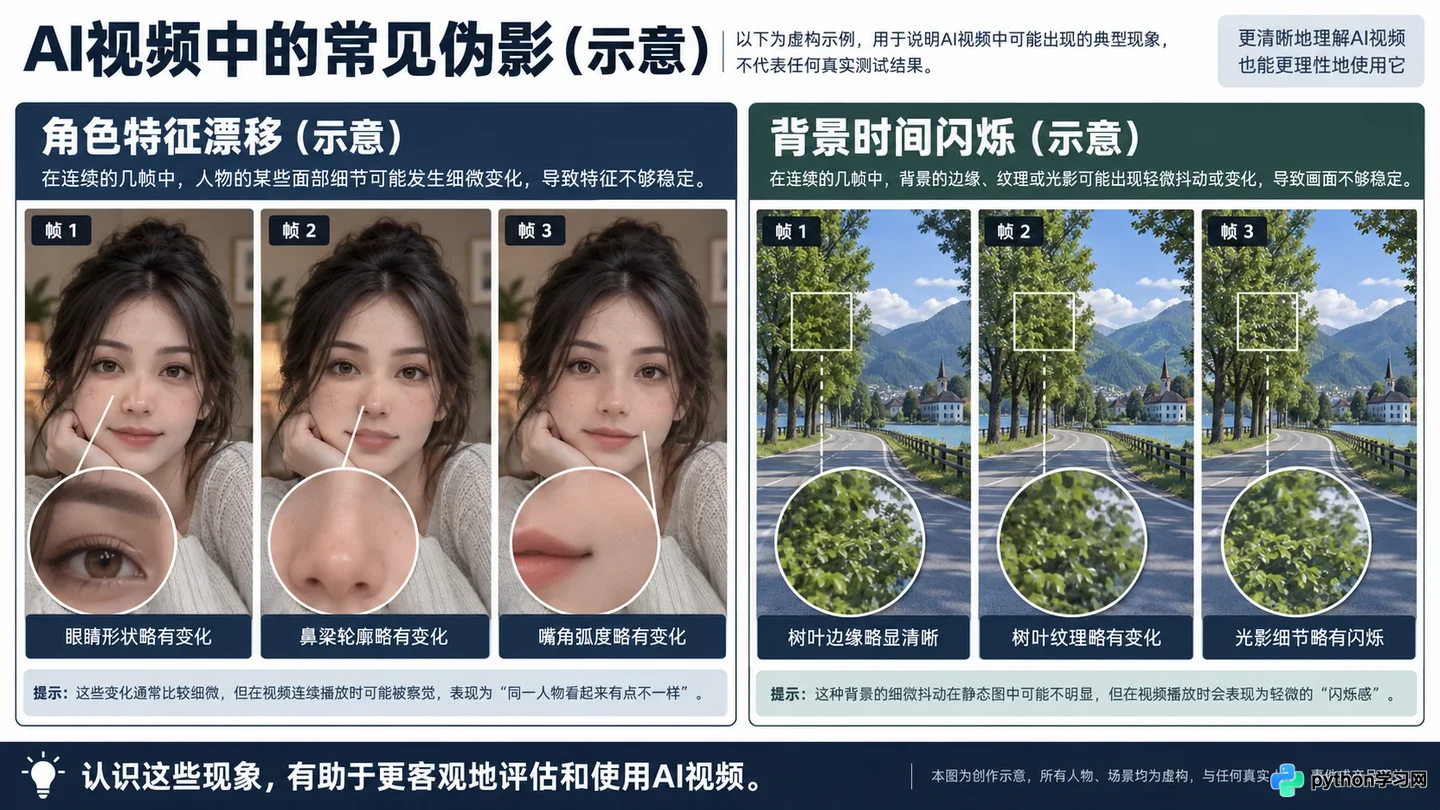
左侧为角色面部特征突变的失败案例,右侧为背景纹理高频闪烁的示意,直观呈现AI视频常见痛点。
锁定身份锚点:从单图生成到多视角一致性
角色面部不一致的根本原因,在于视频生成模型通常基于文本描述独立渲染每一帧或每一段视频,缺乏对“同一人物”的长期记忆。要解决这个问题,必须将角色的视觉特征从抽象的文字转化为具体的图像锚点。
在使用如Midjourney或Stable Diffusion生成初始角色定妆照时,应避免使用过于泛化的描述词(如“一个漂亮的女孩”),转而使用具有独特辨识度的特征组合,并固定随机种子(Seed)。一旦确定了满意的角色形象,这张图就成为了后续所有生成的“真值”。
在视频生成阶段,不要直接让文生视频模型凭空创造角色。更稳妥的做法是使用“图生视频”(Image-to-Video)功能,将定妆照作为首帧输入。此时,提示词的作用不再是描述长相,而是描述动作和环境。例如,将提示词从“一个亚洲女性微笑”改为“保持面部特征不变,头部轻微右转,背景虚化”。这种策略强制模型以现有像素为基础进行演变,而非重新绘制,从而大幅降低面部结构突变的概率。
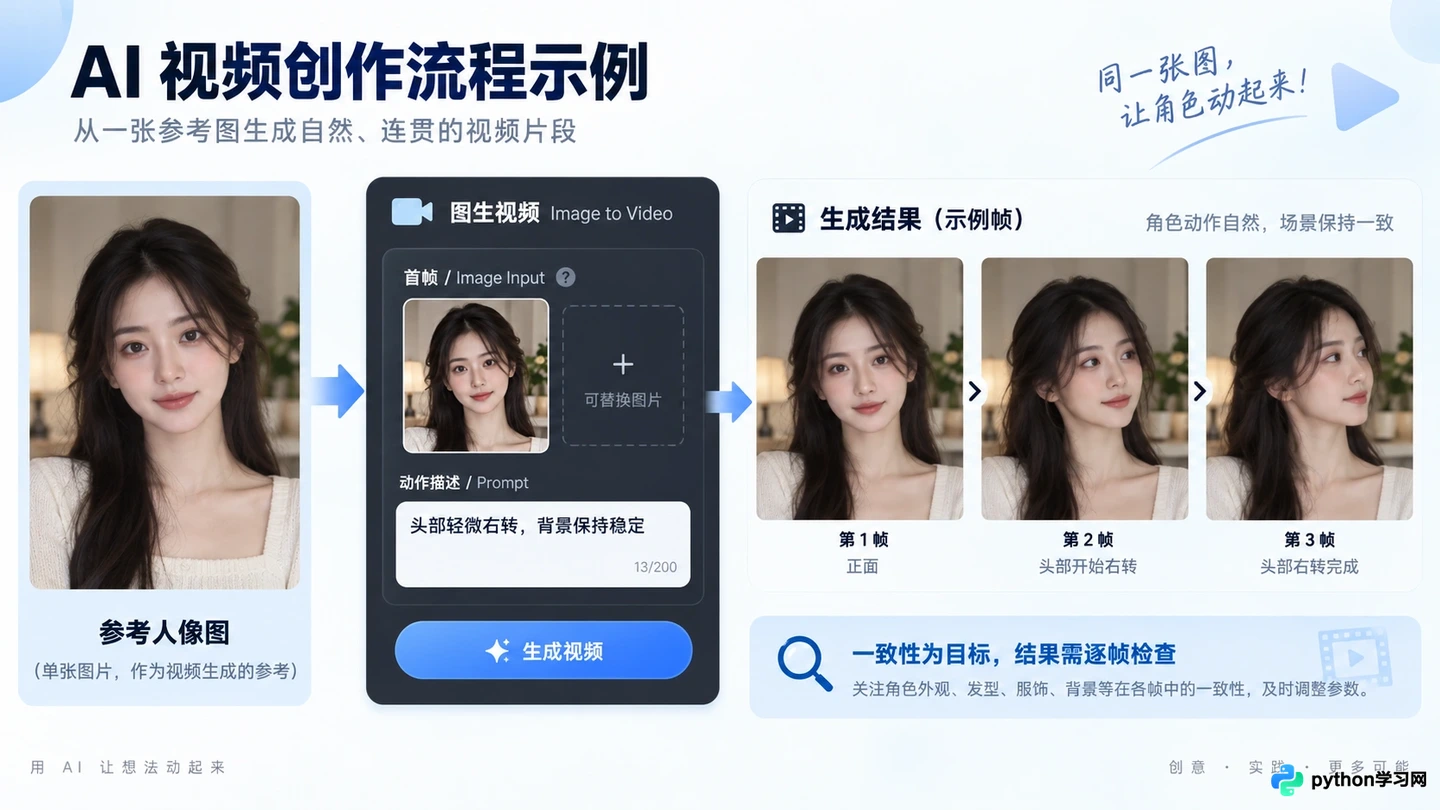
将固定的角色定妆照作为首帧输入视频生成模型,并配合限制性提示词,以确保角色身份的一致性。
约束运动边界:用ControlNet与低动态权重抑制闪烁
画面闪烁,尤其是背景和衣物纹理的高频抖动,往往源于模型对“运动”的过度解读。当提示词中包含复杂的动态描述,或者运动强度参数设置过高时,AI会在相邻帧之间产生剧烈的像素重构,导致视觉上的噪点和闪烁。
在支持高级控制的工作流中(如基于Stable Diffusion的AnimateDiff或ComfyUI),引入ControlNet是抑制闪烁的关键。使用Canny(边缘检测)或Depth(深度图)控制器,可以将首帧的结构信息强加给后续帧。这意味着,无论画面如何运动,物体的边缘轮廓和空间前后关系被牢牢锁定,模型只能在允许的范围内填充颜色和纹理,从而消除了因结构随意变动而产生的闪烁。
对于使用Runway Gen-2或Pika等云端工具的创作者,虽然无法直接调整底层参数,但可以通过“运动笔刷”(Motion Brush)或区域控制来限定变化范围。只涂抹需要移动的区域(如手臂、车轮),而将面部和背景保持静止或未选中状态。此外,适当降低全局运动强度(Motion Score),通常设置在3-5之间而非最高的10,能有效牺牲一部分动态幅度来换取画面的稳定性。在这种场景下,宁可后期通过剪辑加速,也不要前期生成无法使用的抖动素材。
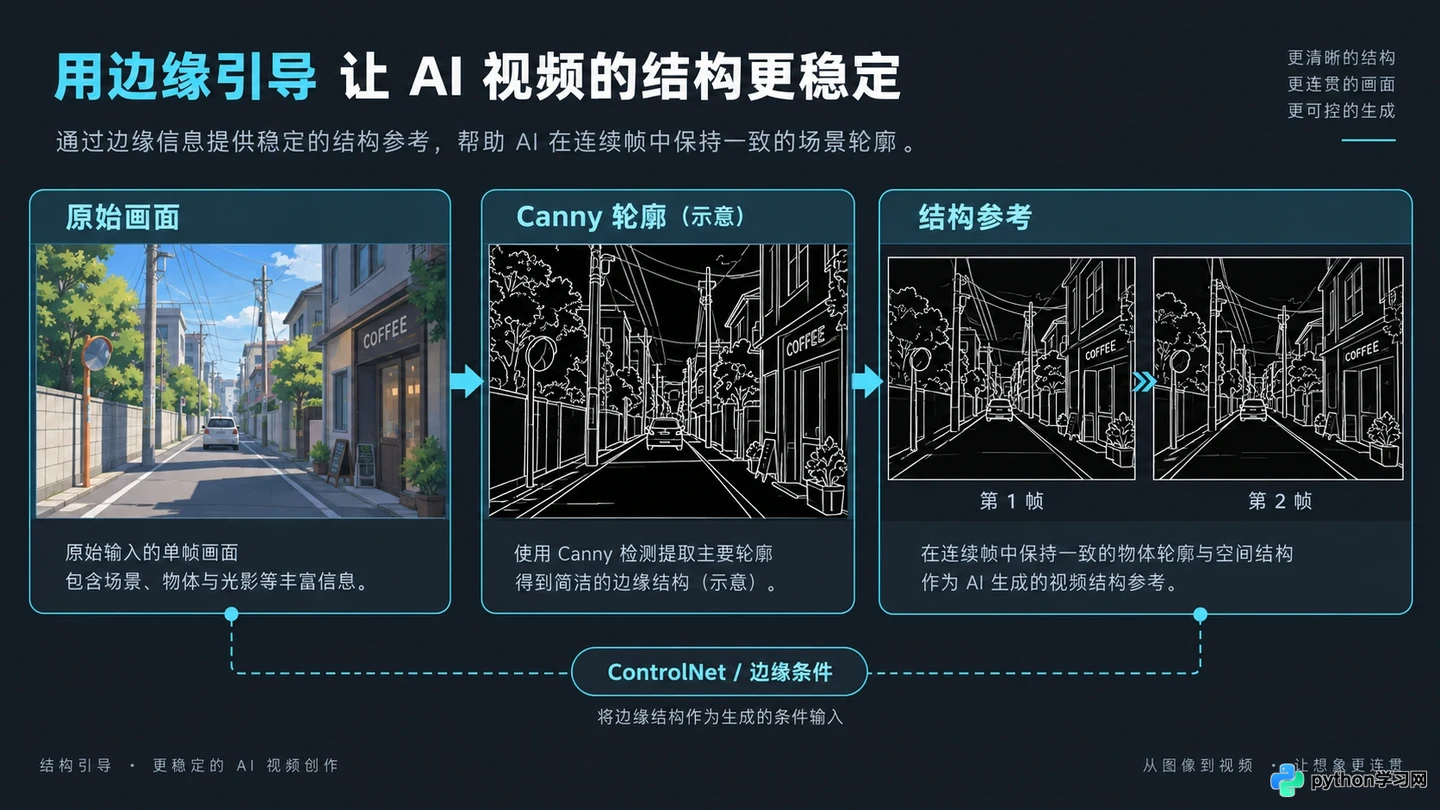
使用ControlNet的边缘检测功能锁定物体轮廓,限制AI在帧间的随意重构,从而抑制画面闪烁。
平滑时间缝隙:帧插值与去闪烁的后期补救
即便前期控制得当,AI生成的视频仍可能存在细微的帧间不连贯。这时候,传统的视频后期技术反而能成为AI工作流的重要补充。不要指望AI一次性输出完美的成品,而应将其视为“高噪点的原始素材”。
针对轻微的闪烁和卡顿,使用帧插值(Frame Interpolation)技术可以显著改善观感。工具如RIFE或Topaz Video AI可以通过算法在原有帧之间插入计算出的中间帧,使运动更加平滑,同时平均化相邻帧之间的色彩差异,从而减轻闪烁感。需要注意的是,帧插值可能会带来“肥皂剧效应”或运动伪影,因此需根据素材的具体动态程度调整插值倍数,通常2倍插值是最安全的起点。
对于顽固的面部微小变形,可以使用专门的人脸修复插件或软件(如CodeFormer或GFPGAN)对关键帧进行增强,然后再重新合成视频。这种方法虽然增加了处理步骤,但它能确保在特写镜头中,角色的五官始终保持在人类审美的舒适区内,避免因AI幻觉导致的恐怖谷效应。
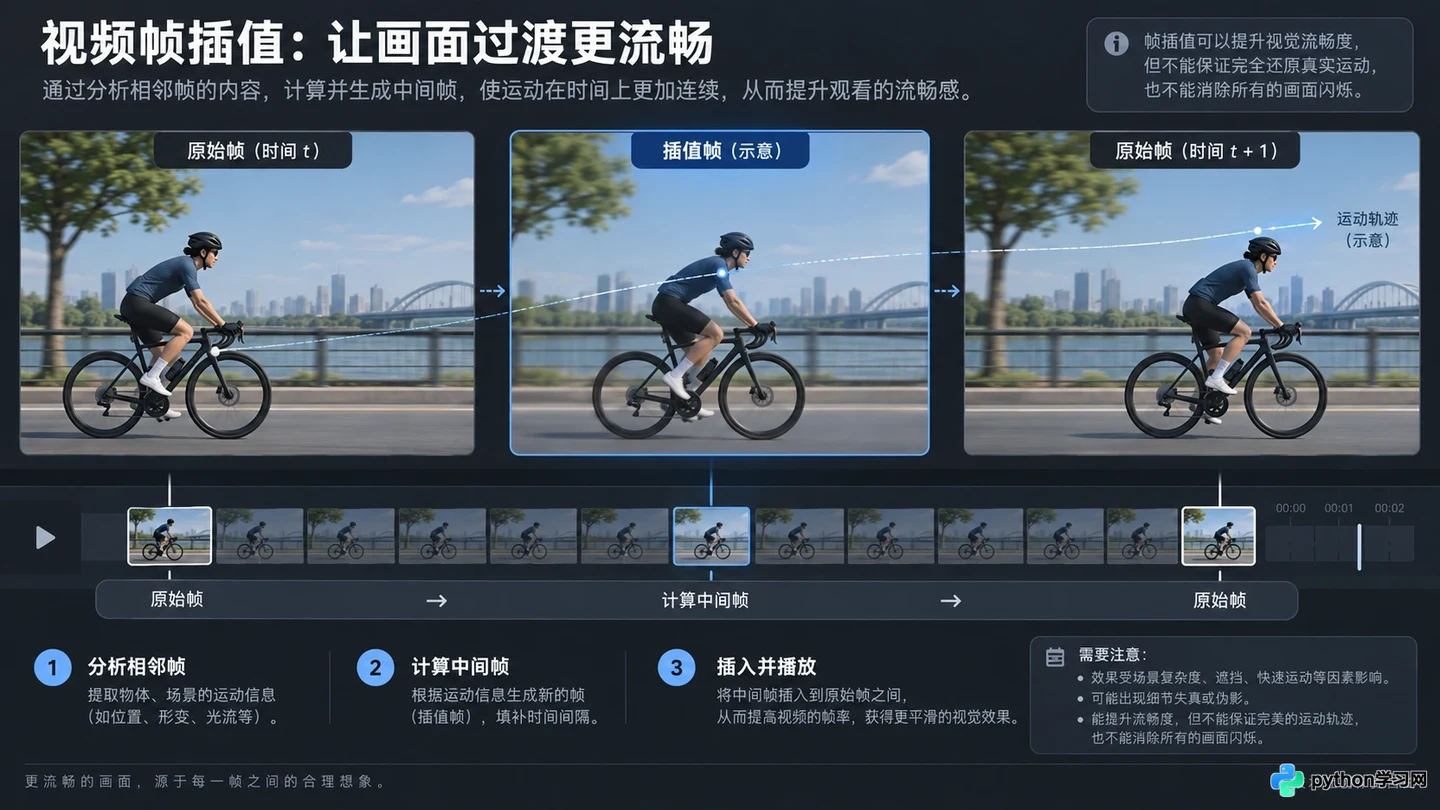
通过帧插值技术在原始帧之间插入计算帧,平滑运动轨迹并减轻色彩闪烁。
接受不完美的现实:叙事节奏对技术缺陷的掩盖
最后,必须承认当前的AI视频技术在长镜头和复杂交互场景中仍存在物理极限。试图用一个长达10秒的连续镜头展示角色复杂的打斗或表情变化,极易暴露一致性问题。聪明的做法是调整叙事策略,利用剪辑来规避技术短板。
采用快速剪辑、多景别切换(特写接全景)以及声音设计来转移观众注意力。当画面出现轻微不稳定时,配合紧凑的音效和音乐节奏,观众的感知焦点会从视觉瑕疵转移到情绪氛围上。此外,避免在视频中使用大面积纯色背景或重复纹理,这些区域最容易暴露出AI生成的噪点闪烁;增加环境的复杂度和光影变化,反而能利用视觉掩蔽效应让瑕疵变得不那么显眼。
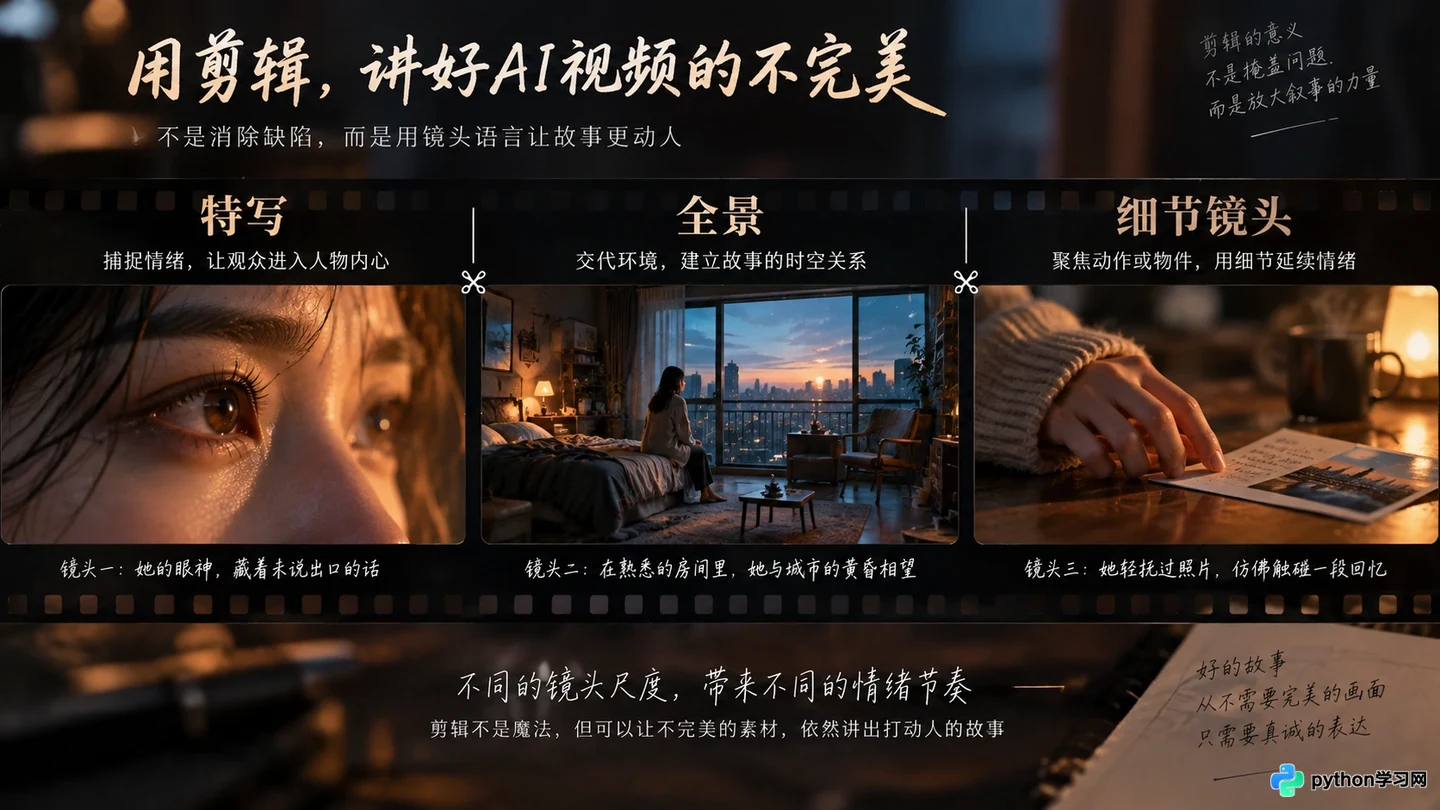
利用多景别切换和快速剪辑分散观众对单一画面瑕疵的注意力,通过叙事节奏弥补技术不足。
解决AI短剧的稳定性问题,不是在追求技术的绝对完美,而是在寻找创意表达与技术边界之间的平衡点。通过锁定角色锚点、约束运动范围、辅以后期平滑以及巧妙的剪辑策略,创作者可以将不可控的随机生成转化为可控的生产流程。在这个过程中,耐心和对工具特性的深刻理解,比单纯依赖更强大的模型更为重要。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









