

长文本有声书制作:在线AI配音怎么保持角色连贯性

做有声书最让人头大的瞬间,不是录错了字,而是听到第50章时,主角的声音突然从“沉稳大叔”变成了“清亮少年”,或者旁白的情绪在悲伤和欢快之间反复横跳。这种割裂感会让听众瞬间出戏,之前积累的情感投入也大打折扣。
很多创作者以为只要选定一个音色就能一劳永逸,其实长文本配音的核心难点在于“记忆”和“上下文”。在线AI配音工具虽然方便,但如果只是机械地分段生成,很容易出现音色微调漂移或语气不接茬的情况。要解决这个问题,关键不在于换更贵的工具,而在于建立一套标准化的角色管理流程。
建立专属的角色声音档案
不要每次新建项目都重新去音色库里挑声音。人的听觉对细微的频率变化非常敏感,即使是同一个AI模型,不同批次生成的音频在基频和共振峰上也可能有微小差异。
首先,在开始制作前,确定好每个主要角色的固定音色ID。大多数成熟的在线AI配音平台都允许用户收藏或标记常用音色。你需要为旁白、男主、女主以及重要配角分别锁定一个唯一的音色标识。
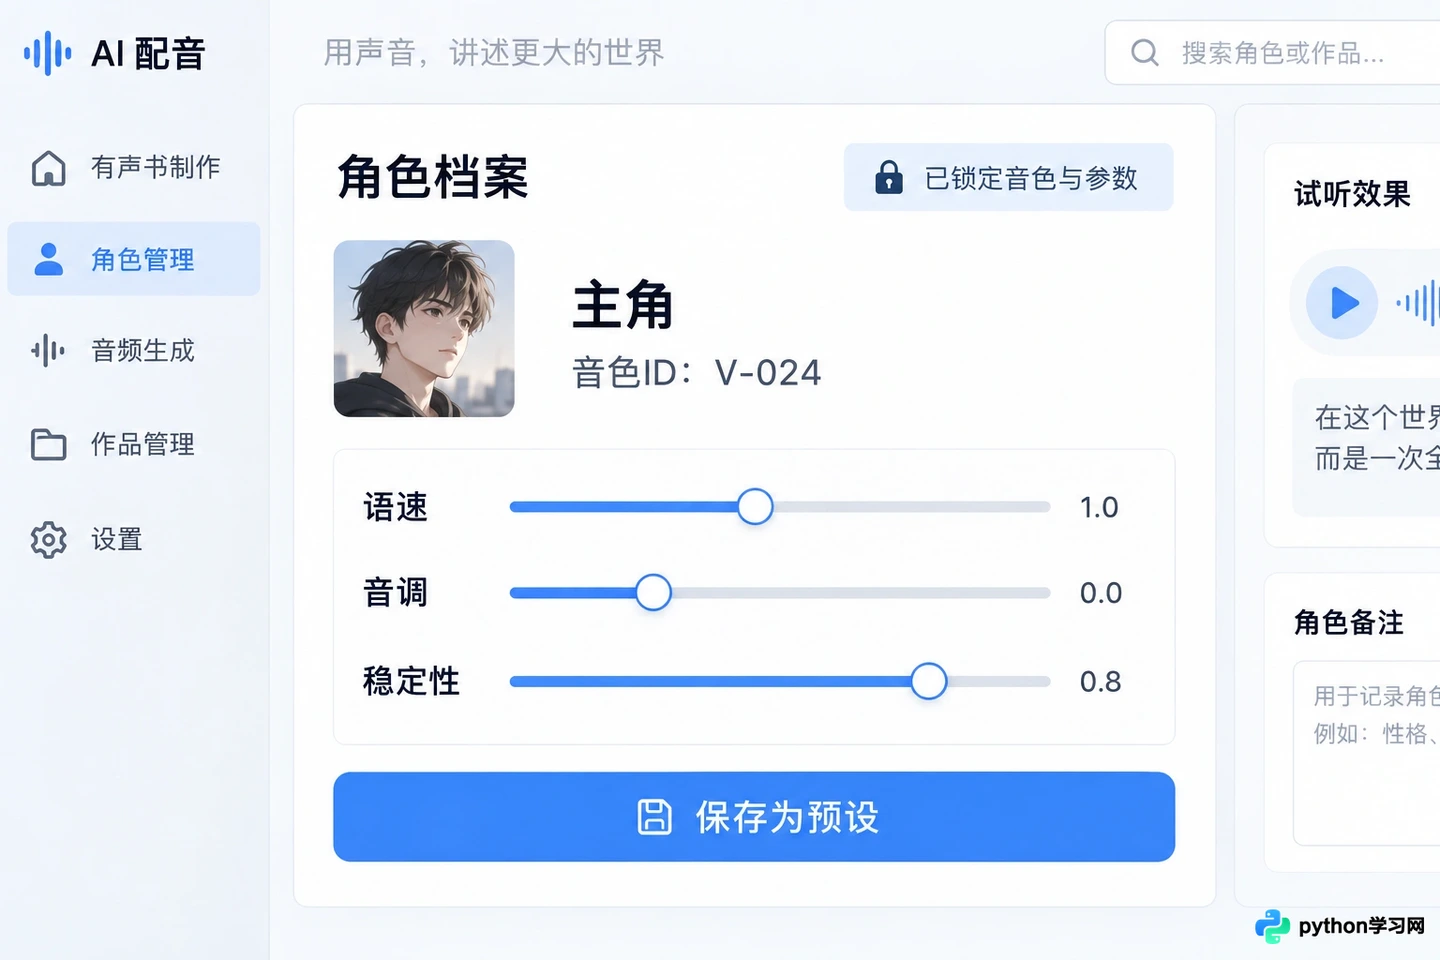
记录并锁定每个角色的音色ID及关键参数
更重要的是记录参数。除了音色,语速、音调(Pitch)和稳定性(Stability)参数对听感影响巨大。建议建立一个简单的表格或文档,记录下每个角色的最佳参数组合。例如,老年角色可能需要降低音调并增加一点颤抖效果,而年轻角色则需要较高的语速和明亮的音调。每次生成新段落时,直接调用这套预设,而不是凭感觉重新调整。
利用多角色管理功能分段处理
长文本直接扔进AI引擎往往会导致上下文丢失,因为大多数模型的注意力窗口是有限的。正确的做法是将剧本按场景或对话块进行拆分,但要保持元数据的一致性。
现在许多先进的在线平台支持“多角色同屏编辑”或“剧本模式”。在这种界面下,你可以像写剧本一样,为每一行文本指定说话人。系统会自动应用该角色之前设定的音色和参数,确保即使跨越了多个章节,声音特征依然保持一致。
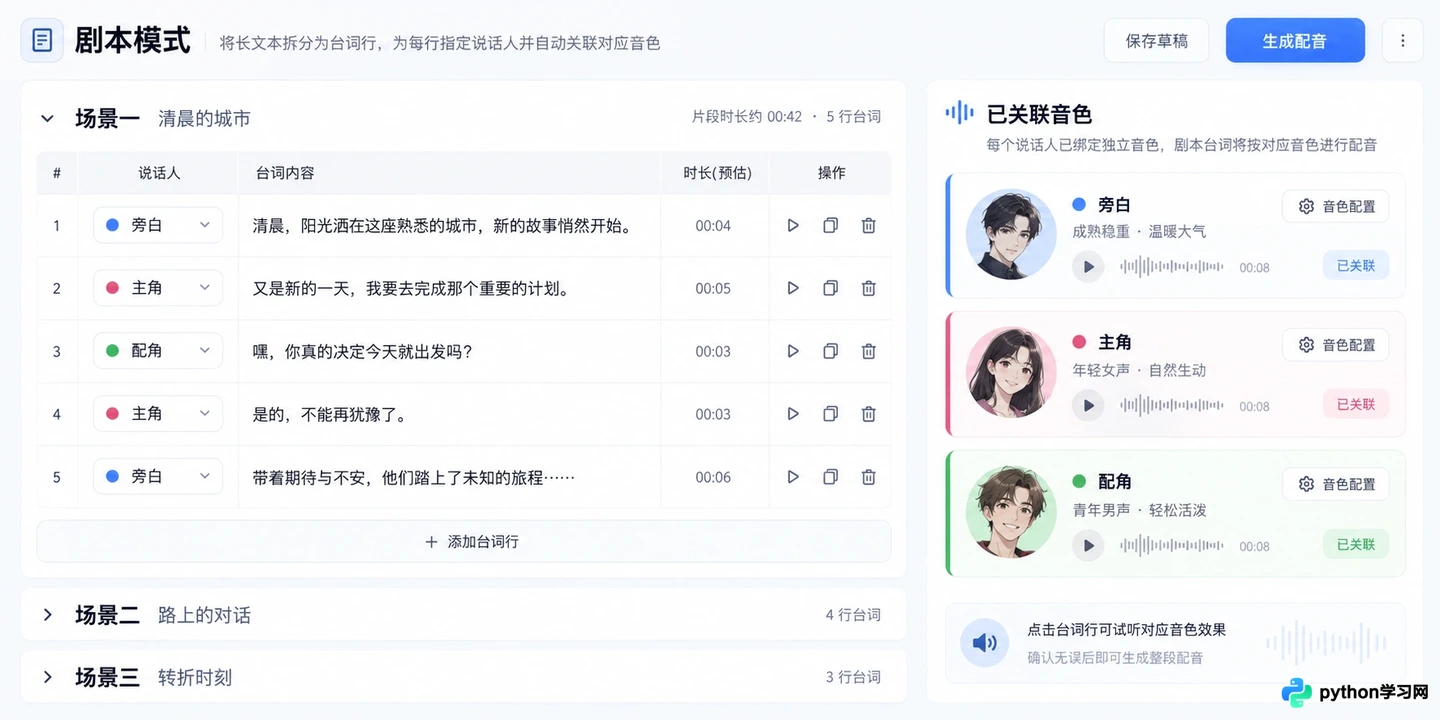
使用剧本模式为每行文本指定说话人以保持一致性
如果使用的平台不支持复杂的剧本模式,可以采用“分段生成+统一导出”的策略。将整本书按章节拆分成多个小任务,但在每个任务中,务必检查是否加载了相同的角色配置包。有些平台提供“项目克隆”或“模板保存”功能,利用这些功能可以确保第二章的设置与第一章完全一致,避免手动复制参数时的疏漏。
平滑情绪过渡与后期衔接
即使音色一致,情绪的断层也是常见问题。AI很难自动理解上一章结尾的悲伤如何延续到下一章开头的沉思。这时候需要人工介入进行“情绪锚点”的设置。
在生成长文本时,注意查看平台是否支持SSML(语音合成标记语言)或情绪标签。在段落开头加入适当的情绪提示词,如“低声地”、“激动地”或“缓慢地”,可以引导AI进入正确的状态。对于特别关键的转折处,可以生成几个不同情绪版本的短句,挑选最自然的一个作为过渡。
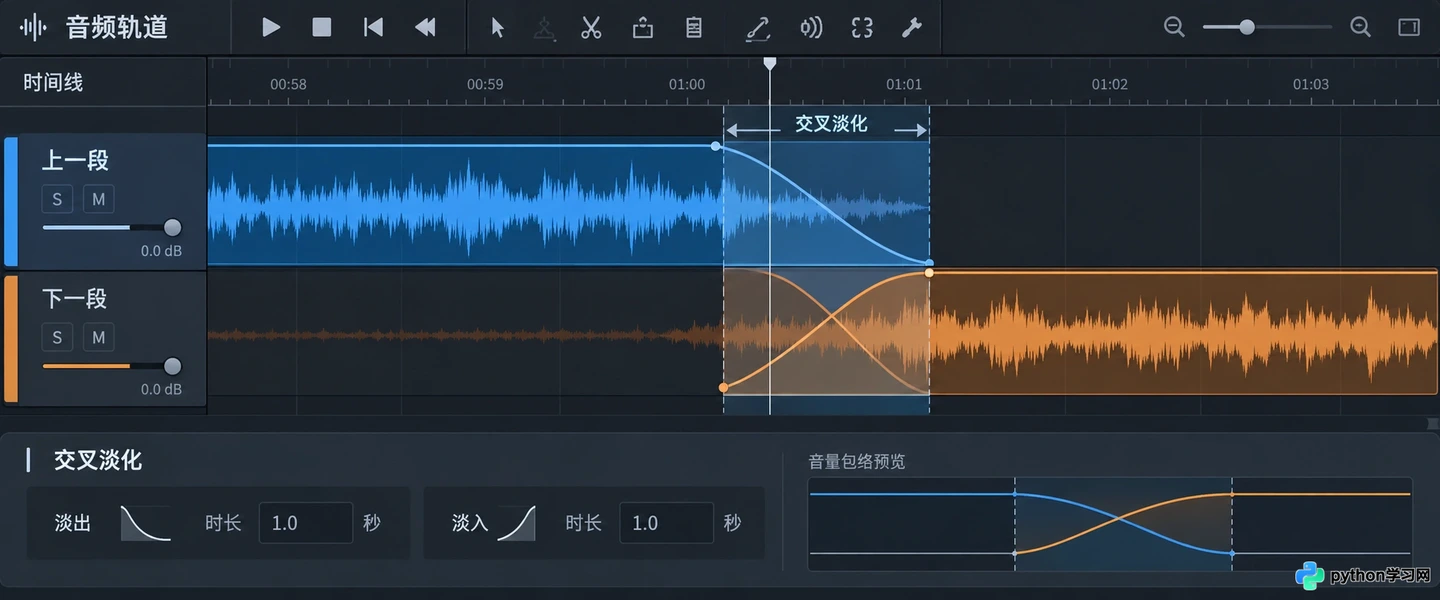
通过交叉淡化平滑不同音频片段间的衔接
后期处理同样重要。将不同段落生成的音频导入剪辑软件后,不要直接硬拼接。使用交叉淡化(Crossfade)技术,让上一段的尾音和下一段的起音有短暂的重叠和音量渐变,这能极大地掩盖因生成批次不同带来的底噪差异或语气突兀感。同时,统一添加背景噪音或混响效果,也能从声学环境上抹平碎片感,让整部有声书听起来像是在同一个空间里录制的。
定期回听与迭代优化
不要等到全书做完再检查。每完成3-5章,就从头到尾完整听一遍。重点监听角色切换的瞬间和长时间沉默后的第一句话。如果发现某个角色的声音出现了轻微的“漂移”,立即回到参数设置中进行微调,并将新的参数更新到你的角色档案中。
长文本有声书制作是一场马拉松,保持连贯性的秘诀在于克制随意调整的冲动,坚持使用标准化的工作流。当你的角色档案足够完善,后续的章节制作就会变得像流水线一样稳定且高效。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









