

Pandas时间序列处理:7个核心函数与实战技巧

本文详解Pandas中处理时间序列的7个核心函数,涵盖日期名称查询、算术计算、时区转换及数据切片等操作。通过具体代码示例,展示如何利用Timestamp、Timedelta和offsets等工具高效管理金融、零售等领域的时间数据,帮助开发者快速掌握时间序列分析技巧。
在零售、经济和金融等领域,数据往往与货币流动和销售活动紧密相关,且高度依赖时间维度。若缺乏时间戳或时间标记,管理海量收集的数据将变得异常困难。虽然Python标准库提供了NumPy的timedelta64和datetime64用于时间序列操作,且sklearn也包含部分时间序列功能,但Pandas提供了更丰富且易用的处理函数。
Pandas库中主要涉及四个与时间相关的核心概念。
- 日期时间(Datetime):表示特定的日期和时间,并支持相应的时区信息。在Pandas中,其数据类型为datetime64[ns]或datetime64[ns, tz]。
- 时间增量(Timedelta):用于表示时间差异,支持多种单位,如天、小时、分钟等。从概念上讲,它是日期时间的一种子类形式。
- 时间跨度(Period):指固定周期内的特定频率。其数据类型标记为period[freq]。
- 日期偏移(Date Offset):用于基于当前日期推算目标日期,Pandas中未为其定义特定的数据类型,而是通过偏移量对象实现。
时间序列分析对于理解随时间变化的趋势或系统模式至关重要。借助数据可视化手段,我们可以深入分析数据并据此做出后续决策。
接下来,我们将通过具体示例演示这些函数的实际应用。
1、获取特定日期的星期名称
import pandas as pd
day = pd.Timestamp(‘2021/1/5')
day.day_name()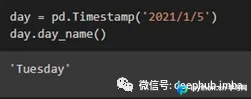
上述代码展示了如何显示特定日期的星期名称。首先导入Pandas库,并调用Timestamp和day_name函数。其中,Timestamp用于输入指定日期,而day_name函数则返回该日期对应的星期名称。
2、执行时间算术计算
import pandas as pd

day = pd.Timestamp(‘2021/1/5')
day1 = day + pd.Timedelta(“3 day”)
day1.day_name()

day2 = day1 + pd.offsets.BDay()
day2.day_name()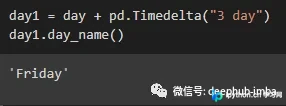
在第一个代码示例中,计算并显示三天后的日期名称。通过Timedelta函数,用户可以输入任意时间单位(如天、小时、分钟、秒)的时间差值。
在第二个代码示例中,利用offsets.BDay()函数来查找下一个工作日。这意味着,如果当前是星期五,计算结果将指向随后的星期一。
3、利用时区信息操作和转换日期时间
获取时区信息
import pandas as pd
import numpy as np
from datetime import datetime

dat_ran = dat_ran.tz_localize(“UTC”)
dat_ran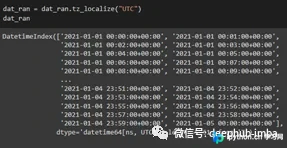
转换为美国时区
dat_ran.tz_convert(“US/Pacific”)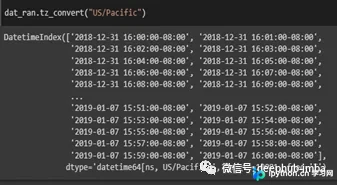
代码的目标是更改日期的时区设置。首先需确定当前时区,这通过tz_localize()函数完成,示例中当前时区为“UTC”。随后,使用tz_convert()函数将其转换为美国/太平洋时区(US/Pacific)。
4、使用日期时间戳
import pandas as pd
import numpy as np
from datetime import datetime
dat_ran = pd.date_range(start = ‘1/1/2021', end = ‘1/5/2021', freq = ‘Min')

print(type(dat_ran[110]))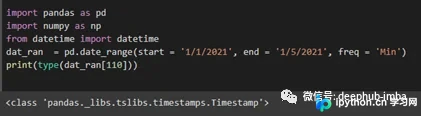
5、创建日期序列
import pandas as pd
import numpy as np
from datetime import datetime
dat_ran = pd.date_range(start = ‘1/1/2021', end = ‘1/5/2021', freq = ‘Min')

print(dat_ran)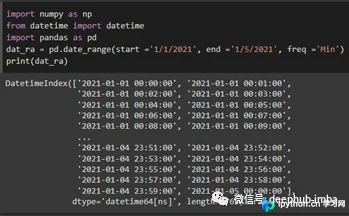
上述代码生成了一个日期序列的范围。通过date_range函数,输入起始和结束日期,即可获取该时间段内的所有日期。
6、操作日期序列
import pandas as pd
from datetime import datetime
import numpy as np

dat_ran = pd.date_range(start ='1/1/2019', end ='1/08/2019',freq ='Min')
df = pd.DataFrame(dat_ran, columns =[‘date'])
df[‘data'] = np.random.randint(0, 100, size =(len(dat_ran)))
print(df.head(5))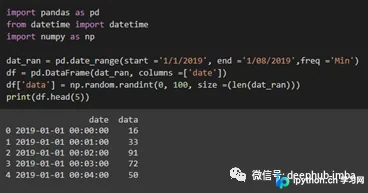
在上述代码中,使用DataFrame函数将字符串类型的数据转换为DataFrame格式。最后,np.random.randint()函数用于随机生成一些假设性的测试数据。
7、使用时间戳数据对数据进行切片
import pandas as pd
from datetime import datetime
import numpy as np
dat_ran = pd.date_range(start ='1/1/2019', end ='1/08/2019', freq ='Min')

df = pd.DataFrame(dat_ran, columns =[‘date'])
df[‘data'] = np.random.randint(0, 100, size =(len(dat_ran)))
string_data = [str(x) for x in dat_ran]

print(string_data[1:5])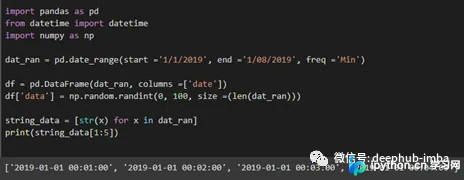
上述代码是第6条的延续。在创建DataFrame并将其映射到随机数后,对列表进行了切片操作。
最后总结,本文通过示例演示了时间序列和日期函数的基础应用。建议参考本文内容,并尝试Pandas中的其他日期函数进行更深入的学习,因为这些函数在实际工作中具有重要价值。
以上就是Pandas中常用的七个时间戳处理函数使用总结的详细内容,更多关于Pandas时间戳处理函数的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









