

Python os与os.path模块实战:筛选xlsx文件及递归遍历目录

发布时间:2026-10-15| 5人浏览过
本文详解Python中os和os.path模块的常用功能。通过os.listdir筛选指定目录下所有xlsx扩展名文件,并利用os.path.join结合递归函数实现多级子目录下的文件完整遍历。文章提供具体代码逻辑与操作步骤,帮助开发者高效处理文件路径与目录结构。
使用os模块筛选xlsx文件
本文旨在介绍如何在Python环境中实现仅读取扩展名为xlsx的文件。
具体解决方案如下:
主要依赖Python内置的os模块来完成文件筛选任务。
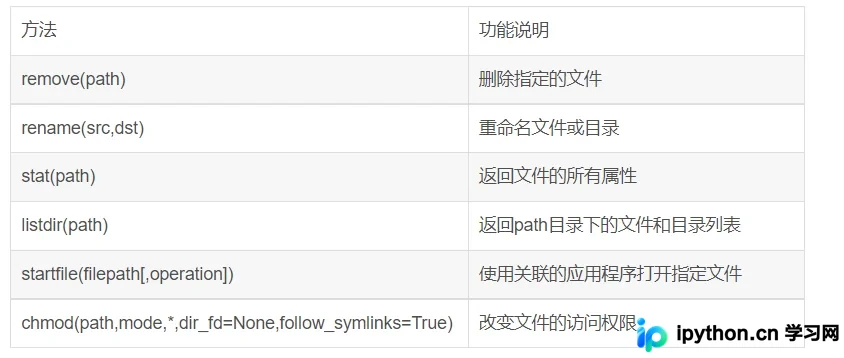
整体解决思路分为以下三个步骤:
- 第一步,明确需要处理的文件目录路径。
- 第二步,遍历该目录下的所有文件对象。
- 第三步,对遍历结果进行条件筛选,仅保留符合要求的文件并执行读取操作。
实现上述逻辑的具体代码示例如下:
import os
# 1、首先定义路径
filepath = 'E:/old/工作/数据库表'
# 2、循环遍历路径下的每一个文件
for filename in os.listdir(filepath):
    # 3、列出文件中以.xlsx结尾的文件
    if filename.endswith(('.xlsx')):
        print(filename)
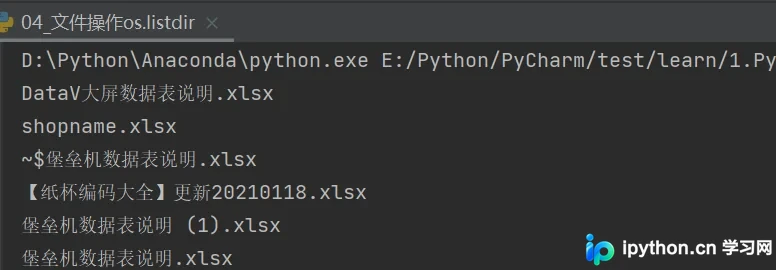
运行代码后的预期输出结果如下所示:
利用os.path递归遍历目录文件
第二个应用场景:利用Python遍历指定目录及其所有子文件夹中的文件。
该场景的解决方法:
利用os.path模块提供的join方法拼接路径,并配合递归逻辑实现深层遍历。
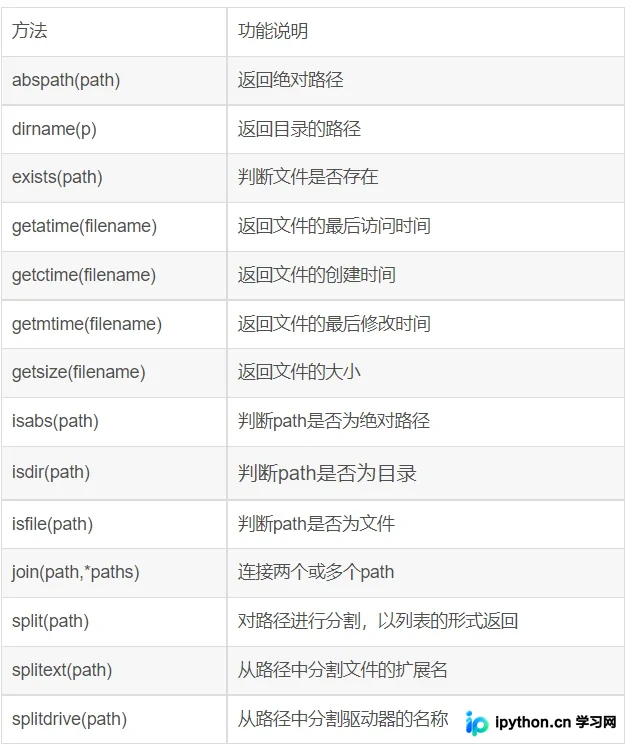
具体的解决思路如下:
- 首先定义一个递归函数,用于循环遍历指定目录下的所有子文件夹。
- 其次调用该函数,以查看并收集目录下的所有文件路径。
实现文件遍历的具体代码如下:
def get_filelist(dir,Filelist):
    if os.path.isfile(dir): #判断path是否为文件
        Filelist.append(dir) # 将路径添加到列表中
    elif os.path.isdir(dir): #判断路径是否为目录
        for s in os.listdir(dir):  #遍历目录下的每一个文件
            new_dir = os.path.join(dir,s)
            get_filelist(new_dir,Filelist) #调用定义的函数
    return Filelist

list_ = get_filelist('E:/old/工作/数据库表',[])
print(len(list_))
for l in list_:
    print(l)
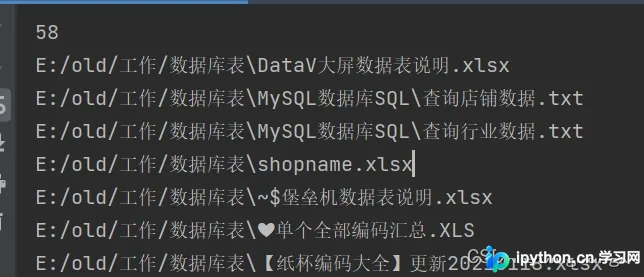
代码执行后的输出结果如下:
至此,关于Python os和os.path模块的详细介绍结束。如需了解更多相关技术内容,建议查阅本站往期文章或关注后续更新,感谢大家的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









