

怎么用Python实现数学集合运算:并集、交集与差集

set。针对两个集合 A 与 B,可以通过运算符或对应的方法完成计算:并集使用 A | B 或 A.union(B);交集使用 A & B 或 A.intersection(B);差集使用 A - B 或 A.difference(B);对称差集使用 A ^ B 或 A.symmetric_difference(B)。底层基于哈希表实现,单次元素检索与运算均摊时间复杂度为 O(1)。
假设我们在处理一项具体的数据比对任务:运营系统导出了昨天参与签到的用户 ID 列表,促销系统导出了昨天参与抽奖活动的用户 ID 列表。业务部门需要我们快速输出三组清单:第一,参与了任意活动的全量独立用户名单;第二,既签到又抽奖的高活跃重合用户;第三,仅完成了签到但未参与抽奖的用户名单。如果使用传统的列表循环遍历,随着数据规模增大,嵌套比对的时间复杂度会迅速攀升至 O(N×M)。而借助 Python 的集合运算,只需三行代码即可高效完成这些集合论维度的筛选与统计。
一、集合核心原理与数学几何映射
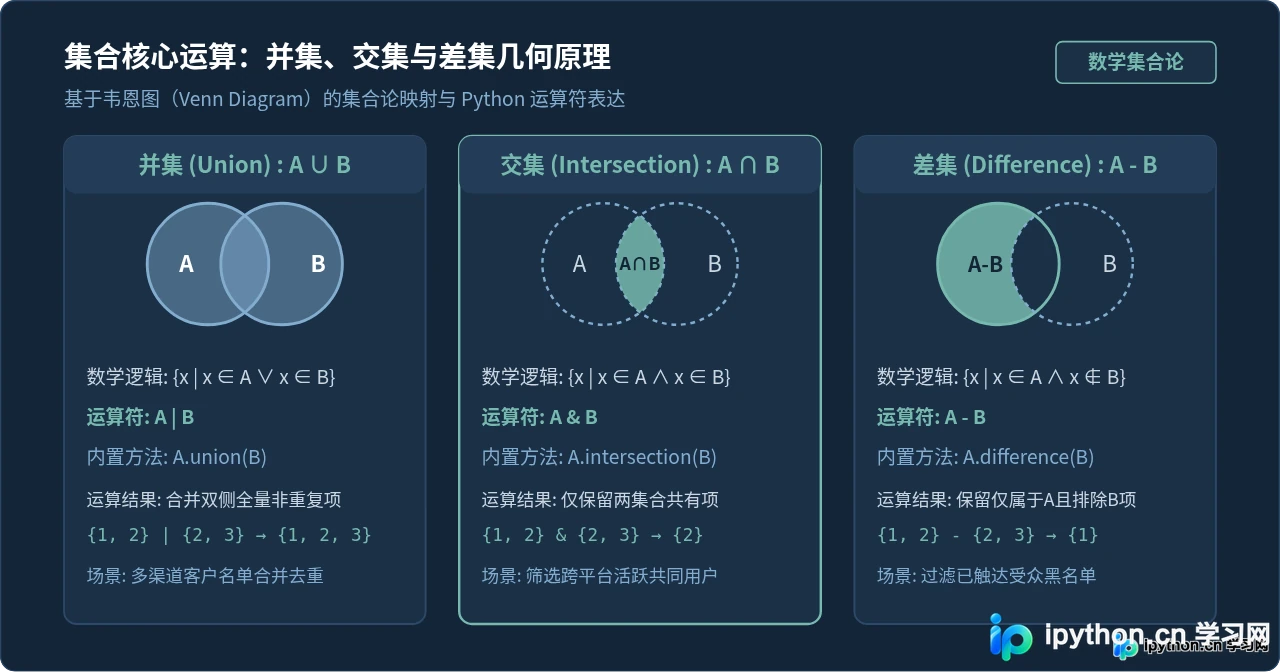
数学上的集合是一组互不相同的独立对象的无序聚合。在 Python 中,set 同样严格遵循这一定律:其内部元素不允许重复,且不保证插入顺序。理解并集、交集与差集的本质,最直观的方式是通过韦恩图(Venn Diagram)观察两个集合在几何空间中的覆盖与重叠区域。
- 并集(Union,记作 A ∪ B):包含属于集合 A 或属于集合 B 的所有元素。几何上等于将两个圆盘所覆盖的全部平面区域合并,重复重叠部分仅保留一次。
- 交集(Intersection,记作 A ∩ B):仅包含同时属于集合 A 且属于集合 B 的公共元素。几何上表现为两个圆盘相交的重叠透镜区域。
- 差集(Difference,记作 A - B 或 A \ B):属于集合 A 但不属于集合 B 的单侧独立元素。几何上表现为从集合 A 的圆盘中切除与 B 重叠的区域后剩余的新月形部分。注意差集具有方向性,A - B 与 B - A 的结果截然不同。
二、Python 集合声明基础与前置准备
在进行数学集合运算前,必须先正确声明集合对象。Python 提供了两种创建集合的语法:花括号字面量 {...} 与类型构造函数 set()。
# 1. 使用花括号字面量创建集合
set_a = {101, 102, 103, 104}

# 2. 将列表或元组转换为集合(自动去重)
user_list_b = [103, 104, 105, 105, 106]
set_b = set(user_list_b)

print("集合 A:", set_a)
print("集合 B(去重后):", set_b)运行结果示例:
集合 A: {101, 102, 103, 104}
集合 B(去重后): {103, 104, 105, 106}{} 默认表示空字典(dict),而非空集合。若要声明一个空集合,必须严格使用 empty_set = set()。若误用 {},后续调用集合运算将会抛出类型异常。
三、实操详解:并集、交集与差集的具体实现
Python 为每种数学集合运算都提供了两套并行的实现手段:操作符语法(如 |、&、-)和面向对象的内置方法(如 .union()、.intersection()、.difference())。在两端均为标准 set 实例时,两者的计算结果完全一致。
3.1 并集(Union):合并元素并消除重复项
并集运算将两个或多个集合中的全部元素聚合为一个新集合。若某些元素在多个集合中同时出现,新集合中只保留一个副本。
# 集合 A: 签到用户
checkin_users = {"Alice", "Bob", "Charlie", "David"}
# 集合 B: 抽奖用户
lottery_users = {"Charlie", "David", "Eva", "Frank"}

# 方式一:使用管道运算符 |
all_users_op = checkin_users | lottery_users

# 方式二:使用 union() 方法
all_users_method = checkin_users.union(lottery_users)

print("全部参与用户(运算符):", all_users_op)
print("两者是否等价:", all_users_op == all_users_method)示例输出:
全部参与用户(运算符): {'Alice', 'Bob', 'Charlie', 'David', 'Eva', 'Frank'}
两者是否等价: True
3.2 交集(Intersection):提取多个集合的重合公共项
交集运算仅挑选出在所有参与运算的集合中都存在的共有元素。如果两个集合没有任何相同项,交集将返回一个空集合 set()。
# 计算既签到又参与抽奖的核心用户
core_users_op = checkin_users & lottery_users
core_users_method = checkin_users.intersection(lottery_users)

print("同时参与两项活动的用户:", core_users_op)示例输出:
同时参与两项活动的用户: {'Charlie', 'David'}3.3 差集(Difference):提取属于前者但排除后者的单侧元素
差集运算关注的是“独有性”。A - B 表示保留所有属于 A 的元素,并剔除所有同样出现在 B 中的元素。差集运算不具备交换律,即 A - B 与 B - A 代表完全不同的业务含义。
# 1. 签到了但未参与抽奖的用户(A - B)
only_checkin = checkin_users - lottery_users

# 2. 参与了抽奖但未签到的用户(B - A)
only_lottery = lottery_users.difference(checkin_users)

print("仅签到用户:", only_checkin)
print("仅抽奖用户:", only_lottery)示例输出:
仅签到用户: {'Alice', 'Bob'}
仅抽奖用户: {'Eva', 'Frank'}
3.4 补充拓展:对称差集(Symmetric Difference)
在实际开发中,有时我们既不想要公共交集,也不偏向任何单侧,而是希望找出“仅属于其中某一个集合,但不同时属于两者”的所有元素。这在数学上称为对称差集(也称异或差集),对应运算符 ^ 与方法 .symmetric_difference()。
# 找出仅参与了单项活动的用户(排除同时参加两项者)
single_activity_users = checkin_users ^ lottery_users
print("仅参加单一活动的用户:", single_activity_users)示例输出:
仅参加单一活动的用户: {'Alice', 'Bob', 'Eva', 'Frank'}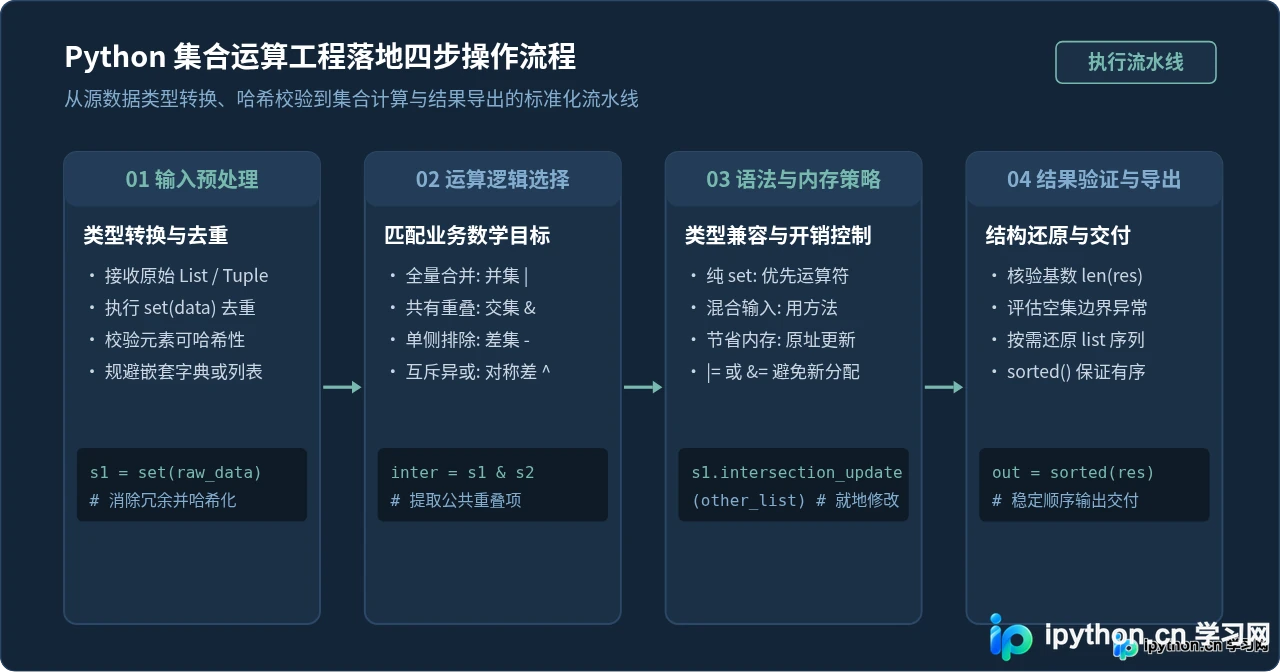
四、运算符 vs 内置方法:关键差异与就地修改
虽然运算符(如 |)与方法(如 .union())在核心数学语义上是一致的,但在工程实践中,两者存在三项非常关键的技术区别:参数类型宽容度、多参数链式调用以及就地修改(In-Place)支持。
4.1 操作数类型兼容性:严格约束 vs 宽容迭代
运算符要求两侧操作数必须均为 set 类型。如果右操作数是列表、元组或生成器,Python 将直接抛出 TypeError。相反,内置方法能够接受任意可迭代对象(Iterable)作为参数,并在底层自动完成迭代与集合化。
base_set = {1, 2, 3}
data_list = [3, 4, 5]

# 1. 尝试使用运算符与列表运算(将报错)
try:
    bad_result = base_set | data_list
except TypeError as e:
    print("运算符遇到非集合报错:", e)

# 2. 使用 union() 方法与列表运算(完全合法)
good_result = base_set.union(data_list)
print("union() 方法正常运算:", good_result)示例输出:
运算符遇到非集合报错: unsupported operand type(s) for |: 'set' and 'list'
union() 方法正常运算: {1, 2, 3, 4, 5}
4.2 原址就地更新(In-Place Update):规避内存重复分配
基础的 A | B 运算会开辟一块崭新的内存区域并返回全新的集合实例。而在处理百万级别海量数据的批处理任务中,频繁创建新集合会给垃圾回收器(GC)带来显著压力。为此,Python 提供了就地修改方法与增强赋值运算符:
- 就地并集:
A |= B或A.update(B)(直接在 A 原址扩充并去重) - 就地交集:
A &= B或A.intersection_update(B)(原址移除非共有项) - 就地差集:
A -= B或A.difference_update(B)(原址剔除匹配项) - 就地对称差集:
A ^= B或A.symmetric_difference_update(B)
big_set = {"order_1", "order_2", "order_3"}
processed = ["order_2", "order_4"]

# 原址更新集合,不产生新对象指针
big_set.difference_update(processed)
print("原址排除已处理订单后:", big_set)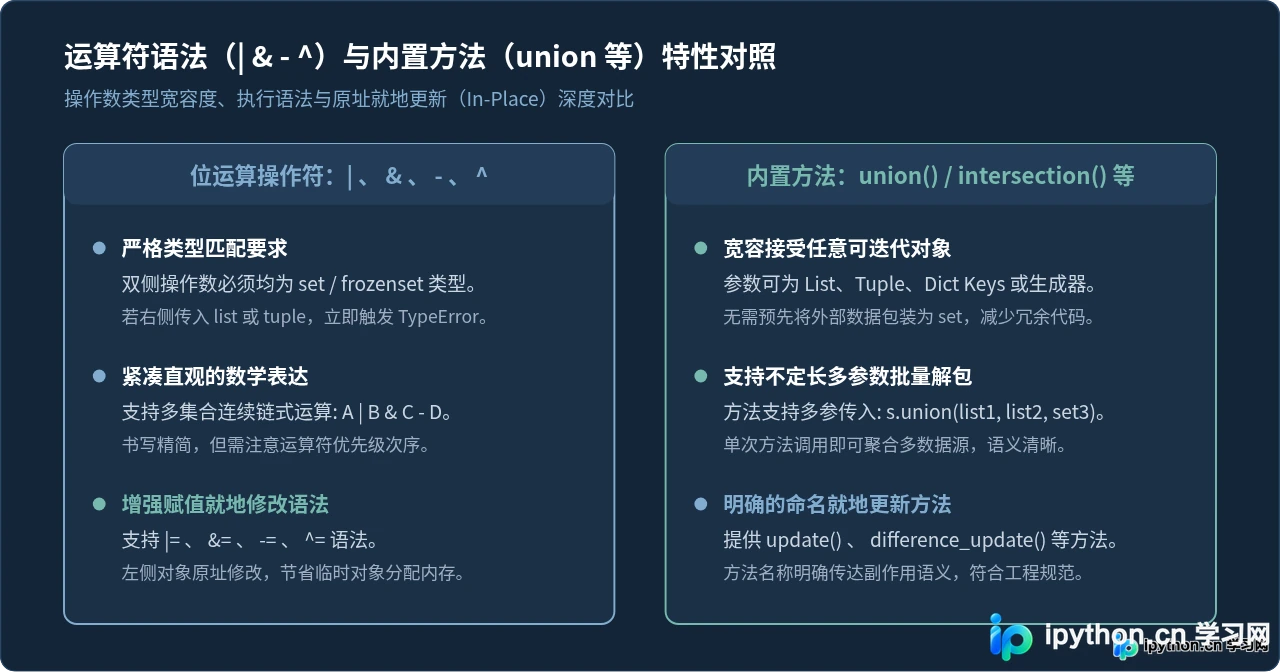
五、工程避坑指南与性能考量
集合虽然功能强大,但在实际工程架构中使用时,必须警惕以下三项核心边界条件:
5.1 元素的可哈希性约束(Hashable)
由于 set 基于底层哈希槽定位元素,其包含的所有元素必须是可哈希的不可变对象。数值、字符串、元组(其成员同样必须可哈希)和 frozenset 均可作为集合元素;而列表(list)、字典(dict)或集合(set)自身由于具有可变性,无法计算恒定的哈希值,强行添加将触发 TypeError: unhashable type: 'list'。
# 正确:元组作为不可变复合键
valid_set = {(1, "alpha"), (2, "beta")}

# 错误示例:试图将列表放入集合
try:
    invalid_set = {[1, 2], [3, 4]}
except TypeError as err:
print("不可哈希报错:", err)5.2 集合的无序性与原有顺序保留
集合运算会彻底打乱数据原有的时序排列。如果你的业务需求是在去重或过滤后仍要保持原始数据的相对先后顺序,不能单纯依靠 list(set_result)。在 Python 3.7+ 中,利用字典有序特性结合 dict.fromkeys() 是兼顾去重与保序的最佳方案:
original_list = [5, 2, 8, 2, 5, 1, 9]
excluded_set = {2, 9}

# 既排除 excluded_set 中的元素,又完整保留原列表剩余元素的相对顺序
filtered_ordered = [x for x in dict.fromkeys(original_list) if x not in excluded_set]
print("去重且保序差集结果:", filtered_ordered)5.3 集合运算的时间复杂度全貌
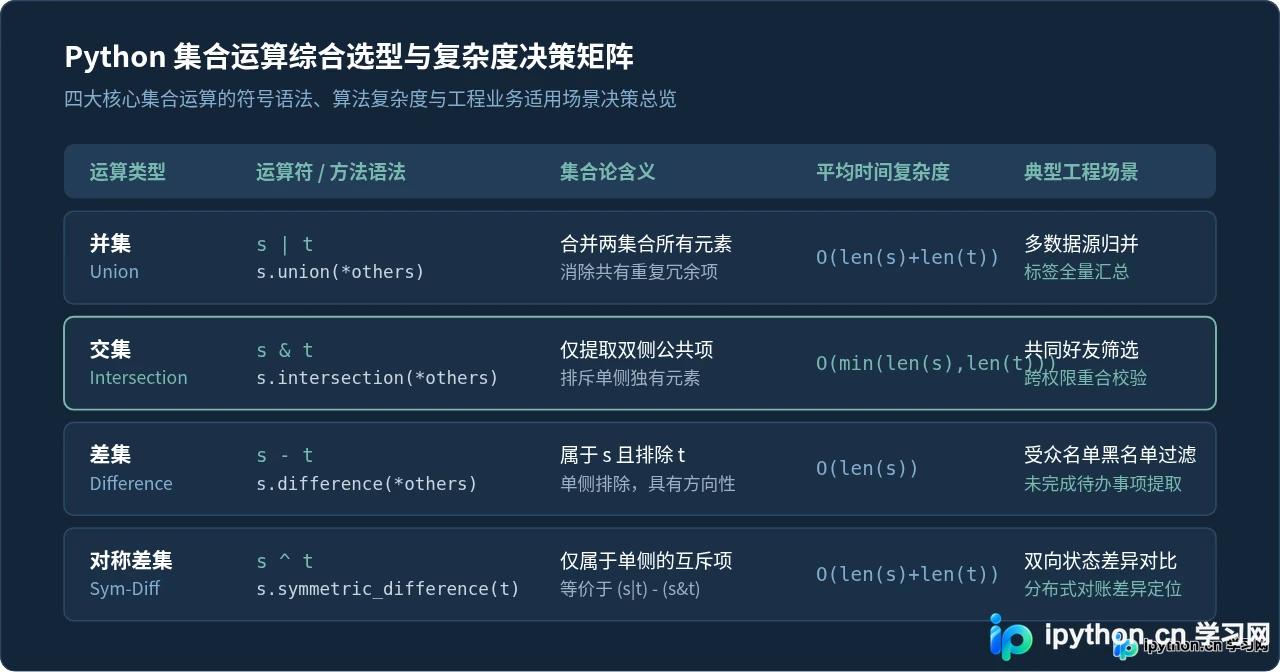
得益于 CPython 对集合底层的哈希优化,集合运算相比列表推导具有压倒性的性能优势:
| 运算类型 | 对应运算符 | 内置方法 | 平均时间复杂度 | 最坏时间复杂度 |
|---|---|---|---|---|
| 并集 (Union) | s | t |
s.union(t) |
O(len(s) + len(t)) | O(len(s) × len(t)) |
| 交集 (Intersection) | s & t |
s.intersection(t) |
O(min(len(s), len(t))) | O(len(s) × len(t)) |
| 差集 (Difference) | s - t |
s.difference(t) |
O(len(s)) | O(len(s) × len(t)) |
| 对称差集 (Sym-Diff) | s ^ t |
s.symmetric_difference(t) |
O(len(s) + len(t)) | O(len(s) × len(t)) |
六、总结
在 Python 中实现数学集合运算,核心在于熟练掌握 set 数据类型的基本特性与其提供的双轨语法:
- 概念映射:并集(
|)负责全量合并去重,交集(&)负责精准抓取共有项,差集(-)负责单向排除过滤,对称差集(^)负责定位非共有互斥项。 - 语法选型:在表达式简洁或涉及纯集合链式运算时,优先选用运算符语法;在输入数据源类型多元(包含列表、元组、迭代器)或需一次性处理多个参数时,优先选用内置方法。
- 性能控制:面对超大规模数据处理时,应优先采用
|=、update()等原址修改方式规避冗余内存分配,并确保集合内部元素符合可哈希不可变约束。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









