

Python使用xlrd库读取Excel表格数据详解

发布时间:2026-10-16| 6人浏览过
本文详细介绍如何使用Python的xlrd库读取Excel文件。内容涵盖通过索引或名称获取Sheet、提取有效行数和列数、获取指定行列数据及单元格值。最后提供一个结合装饰器的完整示例,演示如何筛选并处理Excel中的特定用例数据,适用于自动化测试场景。
前言
临近春节,工作事务繁杂,学习状态也受到影响。此前已整理好关于xlsx文件操作的内容,但因疏忽未发布便关闭了浏览器,导致内容丢失。以下操作均基于实际表格数据进行演示:
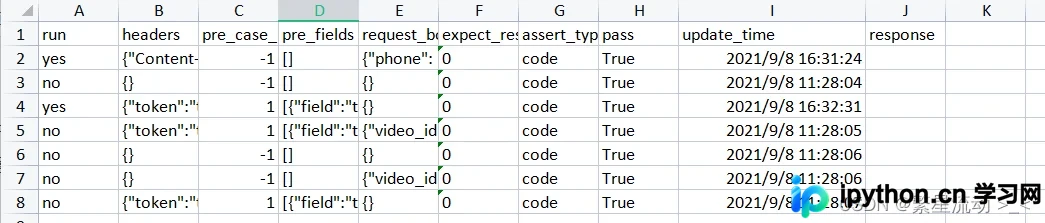
读取操作
获取Sheet的方法 通过索引获取Sheet表格:
table = worbook.sheets()[0]table = worbook.sheet_by_index(0)通过Sheet名称获取:
table = worbook.sheet_by_name(sheet_name='case')获取xlsx中所有Sheet:
table = worbook.sheet_names()
print(table)
打印:case
获取行和列 获取Sheet中有效行数:
row = table.nrows
print(row)
打印:8
获取Sheet中有效列数:
col = table.ncols
print(col)
打印:10
获取一行中有多少列数据:
col = table.row_len(0)
print(col)
获取指定行中的所有数据:
'''
rowx表示是获取第几行的数据
start_col表示从索引为多少开始,end_colx表示从索引为多少结束
end_colx为None表示结束没有限制
获取指定行中的数据并以列表的形式返回
'''
table_list = table.row_values(rowx=0, start_colx=0, end_colx=None)
print(table_list)
打印:['run', 'headers', 'pre_case_id', 'pre_fields', 'request_body', 'expect_result', 'assert_type', 'pass', 'update_time', 'response']
获取列中的数据:
'''
colx表示是获取第几列的数据
start_rowx表示从索引为多少开始,end_rowx表示索引为多少结束
end_rowx为None表示结束没有限制
获取指定列中的数据并以列表的形式返回
'''
table_list = table.col_values(colx=0, start_rowx=0, end_rowx=None)
print(table_list)
打印:['run', 'yes', 'no', 'yes', 'no', 'no', 'no', 'no']
获取单元格中值 获取指定单元格中的值:
table = worbook.sheet_by_name(sheet_name='case')
value = table.cell_value(rowx=0, colx=1)
print(value)
打印:headers
下面写个例子吧,就是将所有run为yes的行打印出来,其实在日常工作中就是将run为yes的用例执行一遍啦,虽然我们并不用excel来存储测试用例。这里直接将其定义成一个装饰器吧。
import xlrd
class Readxlrd():

    def __init__(self,func):
        self.func = func

    def __call__(self, *args, **kwargs):
        self.func(*args)
        worbook = xlrd.open_workbook(filename=args[0])
        table = worbook.sheet_by_name(sheet_name=args[1])
        row = table.nrows
        for i in range(row):
            if i >= 1:
                combined_dict = {}
                table_list = table.row_values(rowx=i, start_colx=0, end_colx=None)
                table_head = table.row_values(rowx=0, start_colx=0, end_colx=None)
                for k, v in zip(table_head, table_list):
                    combined_dict[k] = v
                if combined_dict['run'] == 'yes':
                    print(combined_dict)


@Readxlrd
def test(route,sheet):
    print('输入的路径为{},输入的sheet是{}'.format(route,sheet))
打印:输入的路径为C:\Users\86182\Desktop\case.xlsx,输入的sheet是case
{'run': 'yes', 'headers': '{"Content-Type": "application/x-www-form-urlencoded"}', 'pre_case_id': -1.0, 'pre_fields': '[]', 'request_body': '{"phone": "18262966312", "pwd": "123456"}', 'expect_result': '0', 'assert_type': 'code', 'pass': 'True', 'update_time': 44447.6884722222, 'response': ''}
{'run': 'yes', 'headers': '{"token":"token"}', 'pre_case_id': 1.0, 'pre_fields': '[{"field":"token","scope":"header"}]', 'request_body': '{}', 'expect_result': '0', 'assert_type': 'code', 'pass': 'True', 'update_time': 44447.6892476852, 'response': ''}
总结
到此这篇关于用python实现读取xlsx表格操作的文章就介绍到这了,更多相关python读取xlsx表格内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









