

DeepSeek开放平台支持哪些模型?V3与R1接口差异说明

在接入大语言模型服务时,开发者最常遇到的困惑往往不是“怎么调通”,而是“该调哪个”。面对DeepSeek开放平台提供的多个模型入口,如果选错了模型ID,不仅可能导致响应速度不符合预期,还可能因为输出格式的差异增加后处理的复杂度。
很多团队在初期测试时,习惯性地使用通用的聊天接口去处理复杂的逻辑推理任务,结果发现虽然答案正确,但缺乏推导过程,难以验证其可靠性;或者反过来,用高成本的推理模型去处理简单的客服问答,导致延迟过高且资源浪费。选对模型ID,是平衡成本、速度与效果的第一道关卡。
目前DeepSeek开放平台主要提供两类核心模型能力:以deepseek-chat为代表的通用对话模型(基于V3架构),以及以deepseek-reasoner为代表的深度推理模型(基于R1架构)。理解这两者在接口层面的具体差异,比单纯比较参数量更有实际意义。
通用对话:deepseek-chat的快速响应场景
deepseek-chat是DeepSeek V3系列的代表模型,它的定位非常明确:高效、通用、低成本。在日常的业务场景中,如智能客服、内容摘要、代码补全或常规信息查询,这个模型ID是首选。
在接口调用上,deepseek-chat的行为模式与其他主流大模型高度一致。它直接生成最终答案,不强制输出中间的思考过程。这意味着你的后端服务不需要额外的解析逻辑来剥离“思维链”,可以直接将返回的content字段展示给用户。
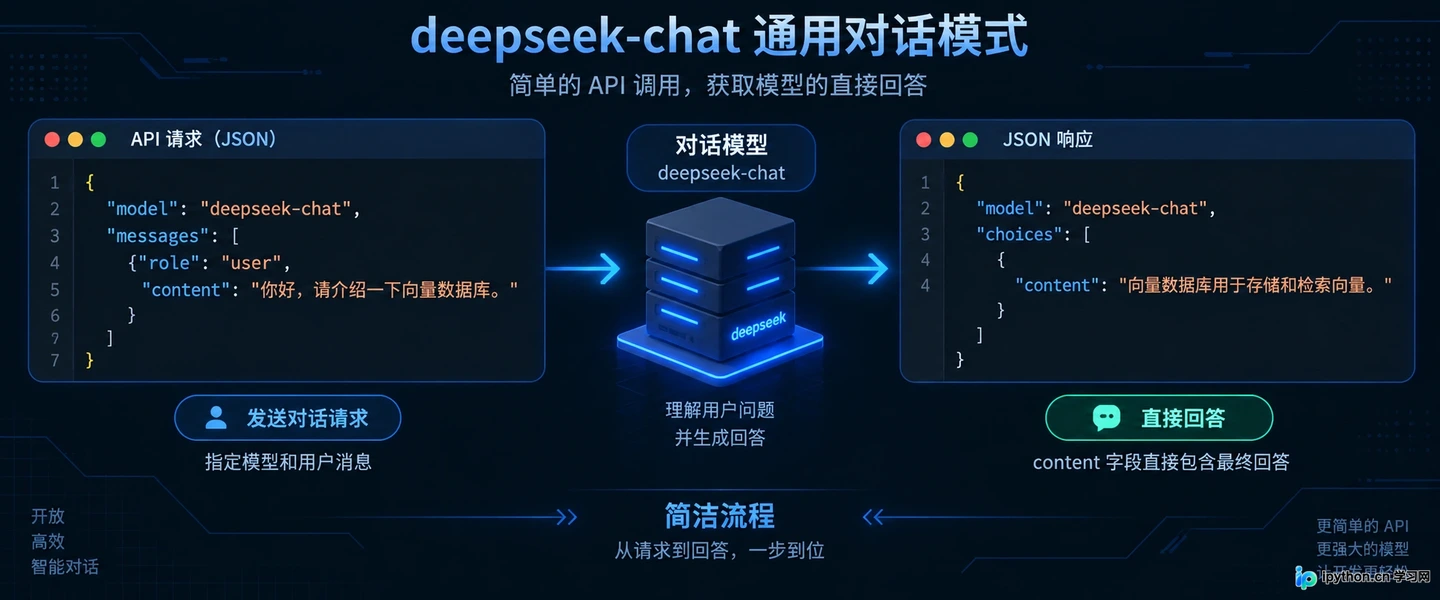
deepseek-chat 接口直接返回最终答案,适合低延迟场景
这种“直给”的模式带来了极低的延迟体验。对于需要实时交互的应用,比如即时通讯助手或搜索增强生成(RAG)系统,deepseek-chat能够在几百毫秒到一秒内返回结构化良好的文本。需要注意的是,虽然它具备较强的逻辑能力,但在面对极度复杂的数学证明或多层嵌套的逻辑陷阱时,它可能会跳过某些推导步骤,直接给出结论。
因此,如果你的应用场景对响应速度敏感,且任务本身不需要展示“我是如何得出这个结论的”,那么model=deepseek-chat就是最稳妥的选择。它在保持较高智力水平的同时,最大限度地优化了吞吐量和成本。
深度推理:deepseek-reasoner的思维链价值
当任务涉及到奥数题、复杂代码重构、科学推理或需要高可信度的逻辑分析时,deepseek-reasoner(基于R1架构)则展现出完全不同的工作流。这个模型ID的核心特征在于它会显式地输出“思考过程”。
在API返回的数据结构中,你通常会看到两个关键部分:一个是包含详细推导过程的reasoning_content(或在某些实现中合并在content的特定标签内),另一个是最终的answer。这种设计并非冗余,而是为了让开发者能够审查模型的逻辑路径,甚至在界面上向用户展示“慢思考”的过程,从而建立信任感。
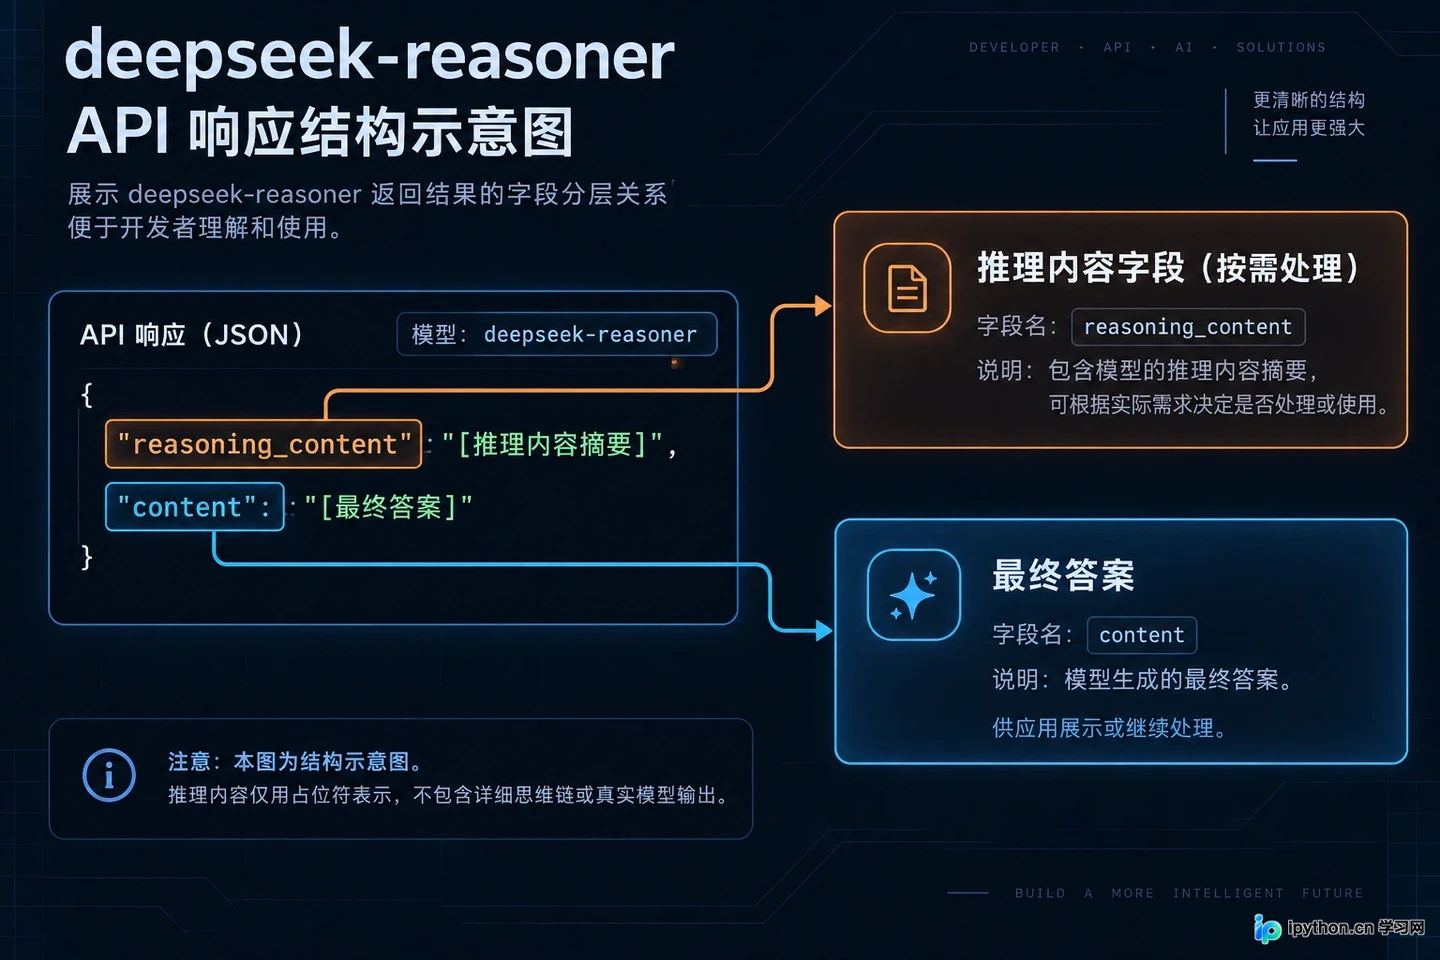
deepseek-reasoner 返回包含推理过程和最终答案的结构化数据
调用deepseek-reasoner时,必须接受一个事实:延迟会显著增加。因为它需要在内部进行多轮的自我反思、验证和修正,才能输出最终结果。这种机制类似于人类专家在解决难题时的草稿纸演算过程。
在代码实现上,处理deepseek-reasoner的响应需要额外的解析步骤。你需要决定是将完整的思考过程展示给用户(适合教育、科研场景),还是仅提取最终答案(适合后台自动化处理)。如果选择不当,用户可能会看到一大段冗长的内心独白,影响体验。因此,使用R1模型不仅仅是换个ID,更是前端展示逻辑和后处理流程的重构。
接口参数与调用行为的细微差别
虽然两者都遵循标准的OpenAI兼容接口格式,但在具体参数的支持和行为上存在细微但关键的差异。这些差异往往决定了集成的成败。
首先是temperature和top_p等采样参数。对于deepseek-chat,调整这些参数可以很好地控制输出的创造性和随机性,适用于创意写作或头脑风暴。然而,对于deepseek-reasoner,过度提高温度可能会干扰其严谨的逻辑推导过程,导致思维链断裂或出现幻觉。通常在推理场景下,建议保持较低的temperature值,以确保逻辑的稳定性。
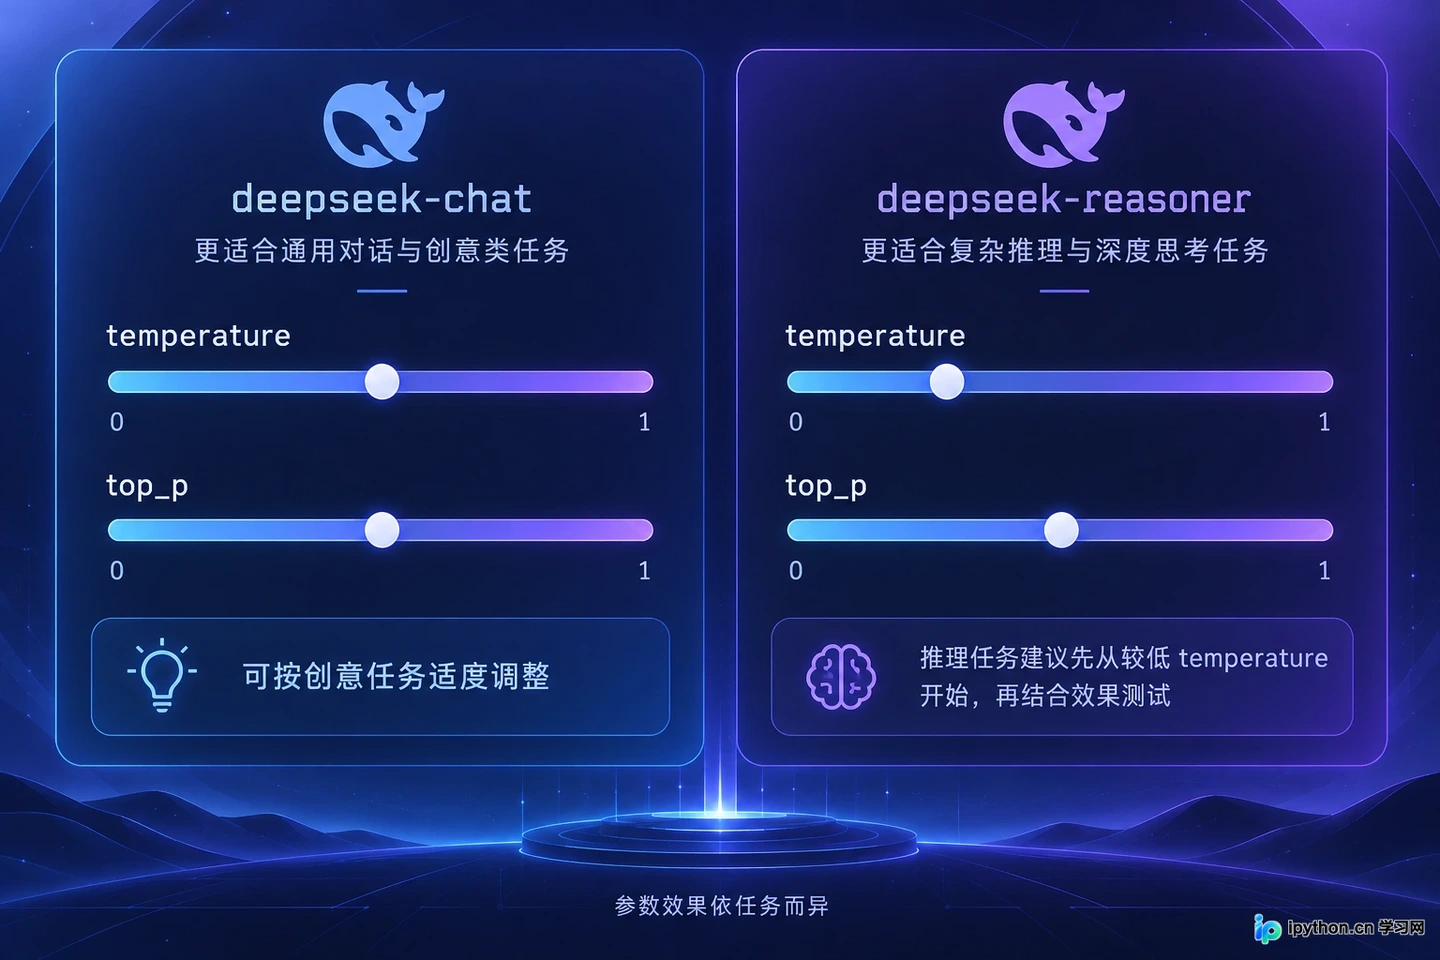
不同模型对Temperature等采样参数的敏感度差异
其次是流式输出(Stream)的表现。deepseek-chat的流式输出非常平滑,适合打字机效果的展示。而deepseek-reasoner在流式传输时,可能会先输出一段较长的思考内容,然后才输出最终答案。如果前端没有做好区分渲染,用户可能会在等待很久后突然看到一大段文字,或者误以为思考过程就是最终答案。
此外,部分高级功能如函数调用(Function Calling)或JSON模式输出,在不同模型版本上的支持程度可能不同。deepseek-chat通常在结构化输出方面优化得更好,适合需要严格格式对接的业务系统;而deepseek-reasoner更专注于自然语言的逻辑推演,虽然在逐步改进,但在强制格式约束上可能需要更多的提示词工程(Prompt Engineering)来辅助。
如何根据业务需求做出选择
回到最初的问题,如何在deepseek-chat和deepseek-reasoner之间做出选择?这不仅仅是一个技术问题,更是一个产品策略问题。
如果你的应用核心是“效率”和“规模”,例如处理成千上万条用户咨询、生成日常邮件草稿或进行简单的数据提取,deepseek-chat是无可争议的主力。它提供了最佳的性价比,能够支撑高并发的业务流量,且开发维护成本最低。
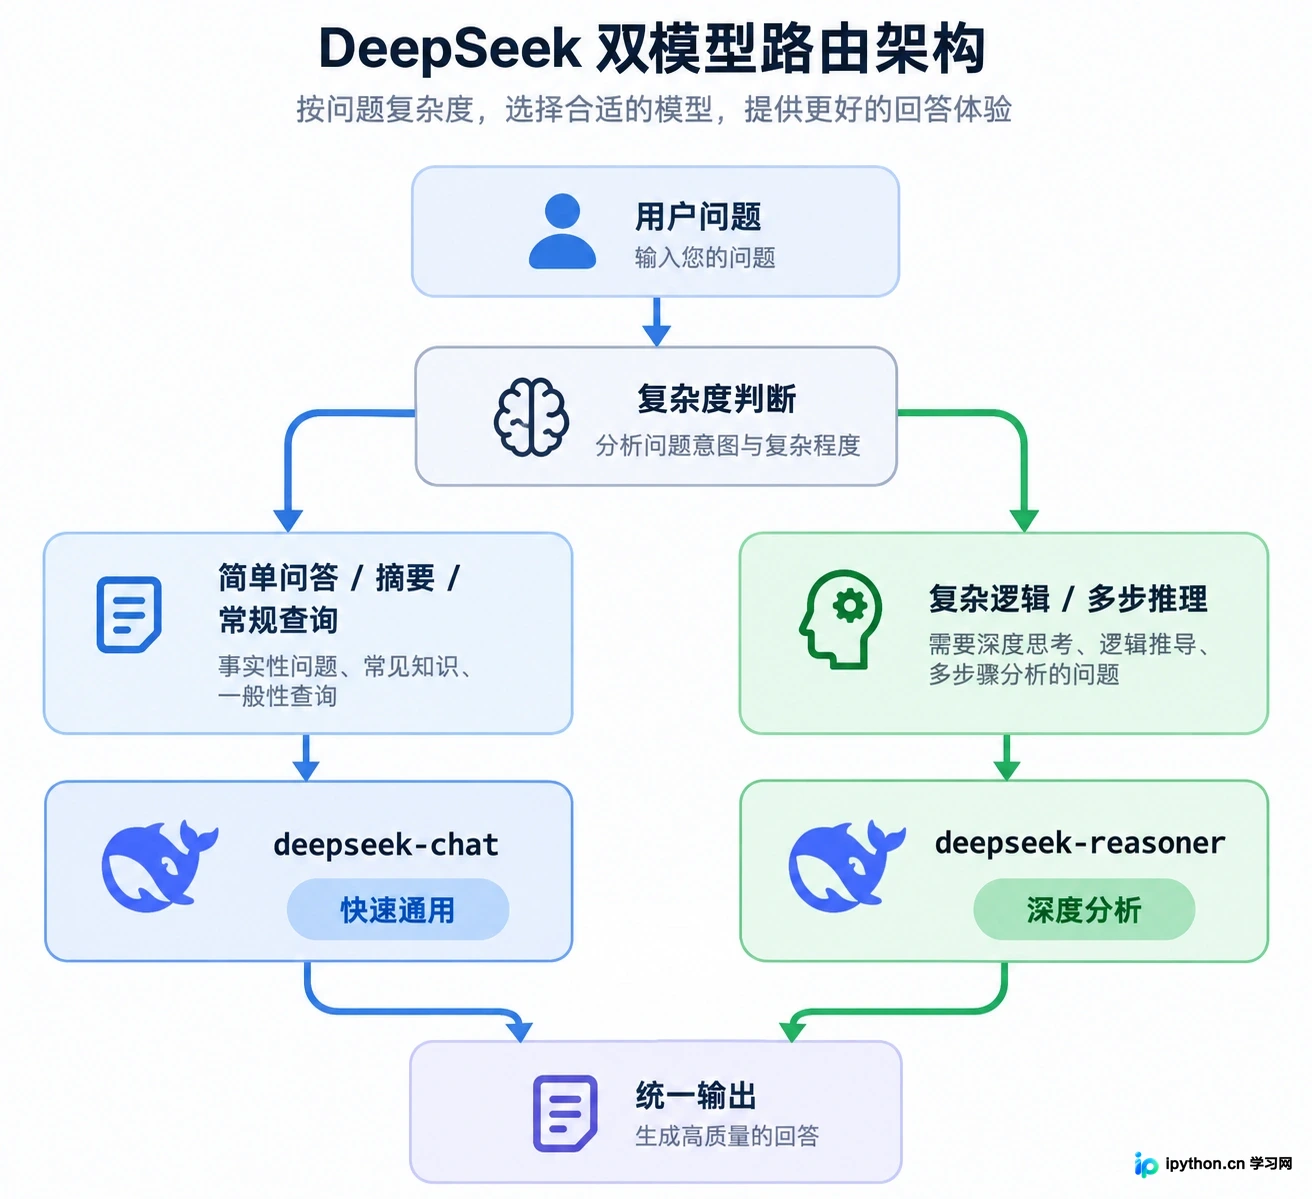
根据问题复杂度自动路由至不同模型的架构设计
反之,如果你的应用核心是“准确性”和“可解释性”,例如辅助医生进行病例分析、帮助学生理解复杂物理题、或为程序员提供深层Bug诊断,那么deepseek-reasoner的价值就无法替代。在这种场景下,用户愿意等待更长的时间,以换取一个经过严密推导、可信度更高的答案。
值得注意的是,这两种模型并非互斥。在一个成熟的智能应用中,完全可以采用路由策略:由一个轻量级的分类器判断用户问题的复杂度,简单问题路由至deepseek-chat,复杂逻辑问题路由至deepseek-reasoner。这种混合架构既能保证大多数情况下的快速响应,又能确保在关键时刻提供深度智力支持。
技术选型没有绝对的优劣,只有是否匹配场景。看清deepseek-chat的速度优势与deepseek-reasoner的逻辑深度,才能在DeepSeek开放平台上构建出既聪明又实用的AI应用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









