

MySQL常用SQL语句速查:增删改查与聚合函数示例

MySQL日常开发中最常使用的SQL,基本可以归纳为新增、查询、修改、删除,以及围绕查询展开的排序、分页、分组和聚合统计。掌握这些语句后,就能完成大多数基础数据操作。本文使用同一张示例表贯穿全文,方便直接对照语法、执行效果和容易出错的位置。
先准备一张用于练习的示例表
为了让后面的SQL能够直接对应,本文统一使用名为 products 的商品表。可以在MySQL命令行、phpMyAdmin、Navicat、DataGrip或其他能够连接MySQL的客户端中执行。
CREATE TABLE products (
    id INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    category VARCHAR(50) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    stock INT NOT NULL DEFAULT 0,
    status TINYINT NOT NULL DEFAULT 1,
    created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP
);字段含义很直观:id 是商品编号,name 是名称,category 保存分类,price 保存价格,stock 保存库存,status 表示状态,created_at 记录创建时间。
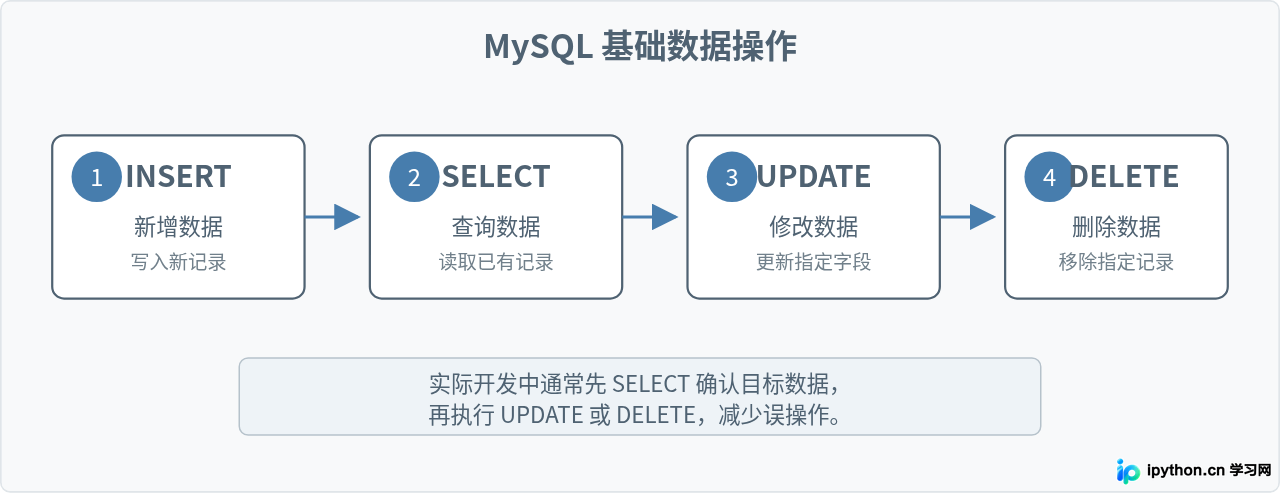
INSERT:新增一条或多条数据
向表中写入新记录使用 INSERT INTO。实际开发中建议明确写出字段名,不要完全依赖表中字段的排列顺序。
新增一条记录
INSERT INTO products
    (name, category, price, stock, status)
VALUES
    ('机械键盘', '电脑配件', 299.00, 50, 1);
因为 id 设置了 AUTO_INCREMENT,所以不需要手工提供编号;created_at 也设置了默认时间,因此可以省略。
一次新增多条记录
INSERT INTO products
    (name, category, price, stock, status)
VALUES
    ('无线鼠标', '电脑配件', 129.00, 80, 1),
    ('27英寸显示器', '显示设备', 1399.00, 20, 1),
    ('USB-C扩展坞', '电脑配件', 359.00, 35, 1),
    ('便携显示器', '显示设备', 899.00, 12, 0);
批量插入时,每组值都要按照前面字段列表的顺序提供。假如定义顺序是 name, category, price, stock, status,后面的每组数据也必须保持一致。
SELECT:查询数据是SQL使用频率最高的部分
查询全部字段最简单的写法是:
SELECT * FROM products;* 表示返回所有字段。学习和临时检查数据时这样写很方便,但正式业务代码通常更适合明确指定需要的列。
SELECT id, name, price, stock
FROM products;
这样可以减少无关字段的读取,也让SQL本身更清楚地表达程序究竟需要什么数据。
使用WHERE筛选数据
只查询启用状态的商品:
SELECT id, name, price
FROM products
WHERE status = 1;
同时限制多个条件可以使用 AND:
SELECT id, name, price, stock
FROM products
WHERE status = 1
  AND stock > 20;
表示两个条件满足任意一个时,可以使用 OR:
SELECT id, name, category
FROM products
WHERE category = '电脑配件'
   OR category = '显示设备';
对于同一个字段的多个取值,更适合使用 IN:
SELECT id, name, category
FROM products
WHERE category IN ('电脑配件', '显示设备');
常见的条件运算
| 写法 | 作用 | 示例 |
|---|---|---|
= |
等于 | status = 1 |
<> 或 != |
不等于 | status <> 0 |
>、<、>=、<= |
数值比较 | price >= 300 |
BETWEEN |
范围查询,包含边界 | price BETWEEN 100 AND 500 |
IN |
匹配多个指定值 | status IN (0, 1) |
LIKE |
模糊匹配 | name LIKE '%显示器%' |
IS NULL |
判断NULL值 | field IS NULL |
= NULL 判断。需要判断空值时,应写成 IS NULL 或 IS NOT NULL。
LIKE模糊查询
查找名称中包含“显示器”的商品:
SELECT id, name
FROM products
WHERE name LIKE '%显示器%';
% 可以匹配任意长度的字符。'显示器%' 表示以“显示器”开头,而 '%显示器' 表示以“显示器”结尾。
ORDER BY排序
按照价格从高到低排列:
SELECT id, name, price
FROM products
ORDER BY price DESC;
DESC 表示降序,ASC 表示升序。ASC也是默认排序方式。
还可以指定多个排序条件,例如先按状态降序,再按价格升序:
SELECT id, name, status, price
FROM products
ORDER BY status DESC, price ASC;
LIMIT限制结果数量
只返回前3条:
SELECT id, name, price
FROM products
ORDER BY id DESC
LIMIT 3;
分页时常见的写法是:
SELECT id, name, price
FROM products
ORDER BY id DESC
LIMIT 10 OFFSET 20;
它表示跳过前20条,再获取10条数据,也就是常见分页场景中的一段结果。
UPDATE:修改已有数据
修改现有记录使用 UPDATE ... SET。例如把编号为1的商品价格改成279元:
UPDATE products
SET price = 279.00
WHERE id = 1;
一次可以修改多个字段:
UPDATE products
SET price = 269.00,
    stock = 60,
    status = 1
WHERE id = 1;
也可以基于字段原来的值进行计算。例如商品卖出3件后减少库存:
UPDATE products
SET stock = stock - 3
WHERE id = 1
  AND stock >= 3;
这里额外加入 stock >= 3,可以避免这个SQL把库存直接更新成负数。不过在真实的订单扣库存场景中,还需要结合事务、并发控制以及具体业务规则处理,不能只依靠这一条示例SQL解决所有并发问题。
例如准备执行:
UPDATE products
SET status = 0
WHERE category = '显示设备';
可以先检查:
SELECT id, name, category, status
FROM products
WHERE category = '显示设备';
确认这些确实是需要修改的记录,再执行UPDATE。
DELETE:删除满足条件的数据
删除记录使用 DELETE FROM。例如删除编号为5的商品:
DELETE FROM products
WHERE id = 5;
也可以根据其他条件批量删除:
DELETE FROM products
WHERE status = 0
  AND stock = 0;
DELETE同样必须重点检查WHERE。如果写成:
DELETE FROM products;含义就是删除表中的全部记录,而不是删除“当前看到的这一条”。
COUNT、SUM、AVG、MAX、MIN:常用聚合函数
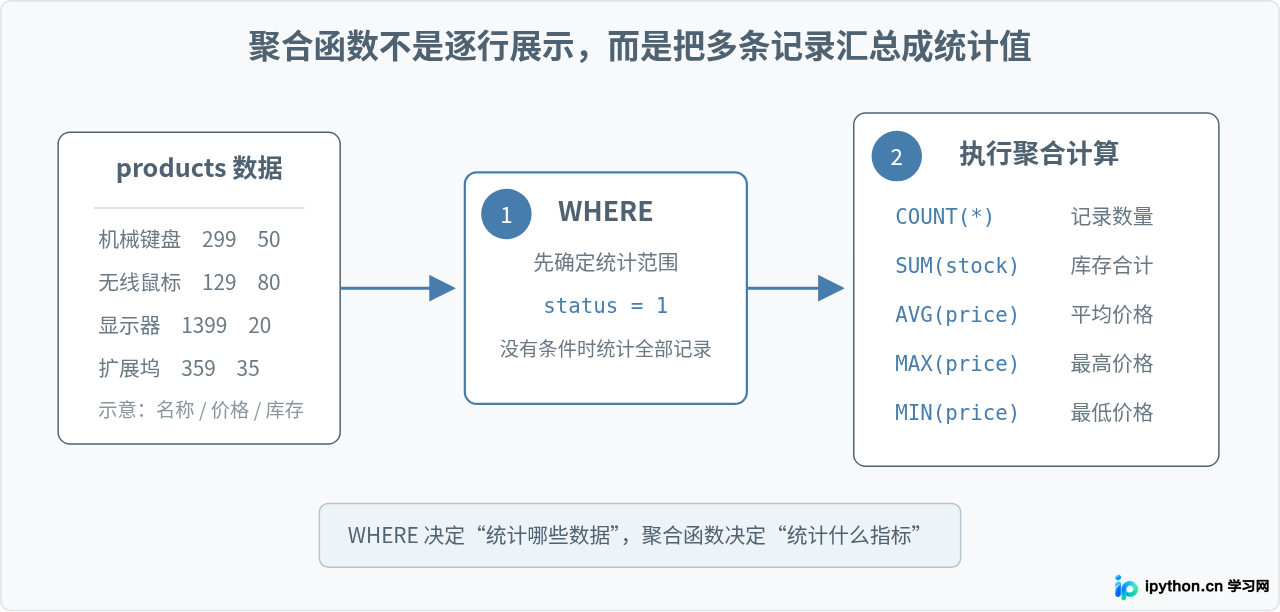
普通SELECT主要解决“有哪些记录”,聚合函数解决的是“这些记录一共有多少、合计多少、平均是多少、最大最小是多少”。
COUNT统计记录数量
SELECT COUNT(*) AS product_count
FROM products;
统计启用状态商品数量:
SELECT COUNT(*) AS enabled_count
FROM products
WHERE status = 1;
COUNT(*) 统计符合条件的记录数。需要注意,COUNT(column) 统计的是该字段不为NULL的记录数,这与 COUNT(*) 的含义并不完全相同。
SUM计算合计值
统计全部商品库存总数:
SELECT SUM(stock) AS total_stock
FROM products;
如果需要估算每种商品“单价 × 当前库存”后的总金额,可以写成:
SELECT SUM(price * stock) AS stock_amount
FROM products;
这里得到的是根据当前表中 price 和 stock 计算出的结果,只适用于示例中的数据含义,并不等同于会计意义上的实际库存成本。
AVG计算平均值
SELECT AVG(price) AS average_price
FROM products
WHERE status = 1;
这条语句计算所有启用商品的平均价格。
MAX和MIN获取最大、最小值
SELECT
    MAX(price) AS highest_price,
    MIN(price) AS lowest_price
FROM products;
结果只返回最高价格和最低价格。如果还要获得“最高价格对应的是哪件商品”,通常需要进一步排序或使用子查询,而不能简单把 name 直接随意放在同一条聚合查询中。
GROUP BY:按照分类进行分组统计
如果只执行 COUNT(*),得到的是整个结果集的一个统计值。需要分别统计每个分类时,就要使用 GROUP BY。
例如统计每个分类有多少件商品:
SELECT
    category,
    COUNT(*) AS product_count
FROM products
GROUP BY category;
也可以同时统计多个指标:
SELECT
    category,
    COUNT(*) AS product_count,
    SUM(stock) AS total_stock,
    AVG(price) AS average_price,
    MAX(price) AS highest_price,
    MIN(price) AS lowest_price
FROM products
GROUP BY category;
这条SQL会按照 category 分组,每个分类返回一行统计结果。
WHERE和HAVING的区别
WHERE 用来筛选参与统计的原始记录,HAVING 通常用于筛选分组聚合后的结果。
例如只统计启用商品,并且最终只保留商品数量不少于2个的分类:
SELECT
    category,
    COUNT(*) AS product_count,
    AVG(price) AS average_price
FROM products
WHERE status = 1
GROUP BY category
HAVING COUNT(*) >= 2;
理解这条SQL时,可以按照下面的顺序:
WHERE status = 1:先排除未启用商品。GROUP BY category:再按照分类把数据分组。COUNT(*)和AVG(price):计算每组的数量和平均价格。HAVING COUNT(*) >= 2:只留下数量至少为2的分类。
DISTINCT:去除重复值
如果只是想查看表中存在多少种不同分类,可以使用 DISTINCT:
SELECT DISTINCT category
FROM products;
统计不同分类的数量:
SELECT COUNT(DISTINCT category) AS category_count
FROM products;
这里需要区分 GROUP BY 和 DISTINCT:DISTINCT主要用于去除重复结果,而GROUP BY更适合在分组后继续进行COUNT、SUM、AVG等统计。
常见组合查询示例
真正使用SQL时,各个语法通常不会彼此孤立。下面几种组合非常常见。
查询价格最高的5件启用商品
SELECT id, name, category, price
FROM products
WHERE status = 1
ORDER BY price DESC
LIMIT 5;
统计每个分类的启用商品数量
SELECT
    category,
    COUNT(*) AS product_count
FROM products
WHERE status = 1
GROUP BY category
ORDER BY product_count DESC;
统计库存总量超过50的分类
SELECT
    category,
    SUM(stock) AS total_stock
FROM products
GROUP BY category
HAVING SUM(stock) > 50
ORDER BY total_stock DESC;
查询价格在200到1000元之间且有库存的商品
SELECT id, name, price, stock
FROM products
WHERE price BETWEEN 200 AND 1000
  AND stock > 0
ORDER BY price ASC;
修改和删除前先SELECT,是一个实用习惯
UPDATE和DELETE真正危险的地方不是语法复杂,而是条件写错后会直接影响已有数据。一个简单但很有效的操作习惯,是先把WHERE条件放进SELECT验证。
假设准备删除所有停用商品:
DELETE FROM products
WHERE status = 0;
执行前先运行:
SELECT id, name, status
FROM products
WHERE status = 0;
只有当查询结果与预期一致时,再执行对应DELETE。UPDATE也可以采用同样的方式。
对于重要数据,仅靠SELECT确认仍然不代表具备完整的安全保障。生产环境中还应根据实际情况考虑权限控制、备份、事务以及操作审计等措施。
SQL执行顺序不要完全按照书写顺序理解
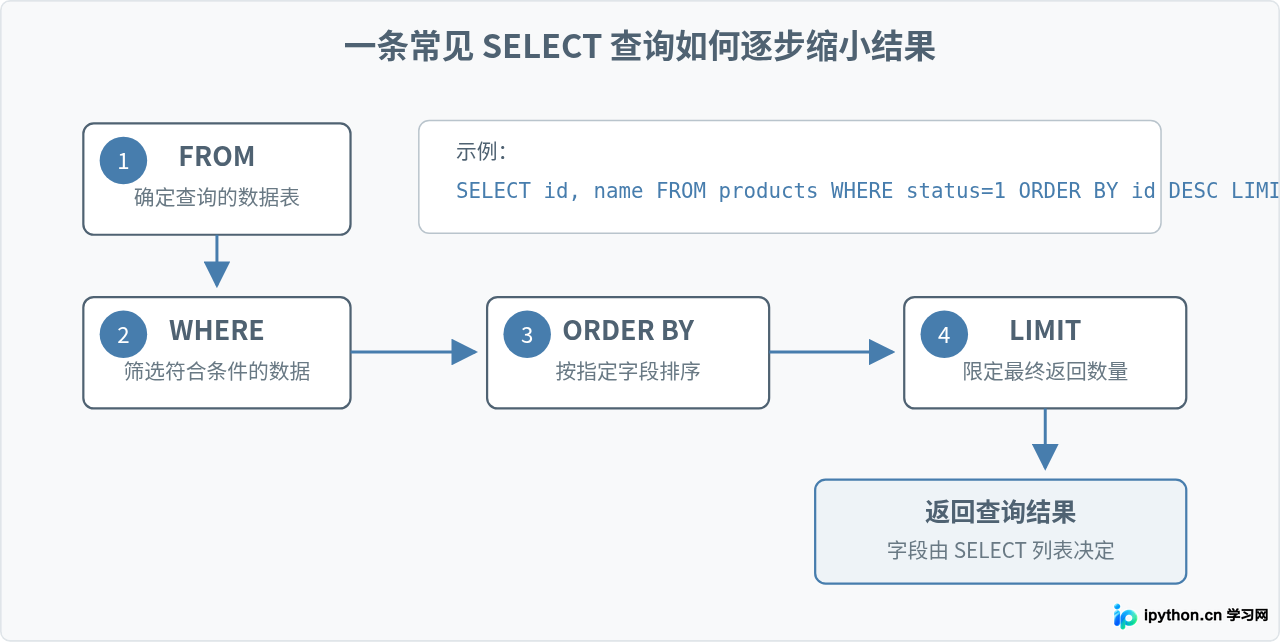
SQL写出来时通常以SELECT开头,但理解复杂查询时,更适合从数据来源和筛选过程入手。例如:
SELECT
    category,
    COUNT(*) AS product_count
FROM products
WHERE status = 1
GROUP BY category
HAVING COUNT(*) >= 2
ORDER BY product_count DESC
LIMIT 10;
从逻辑上理解,可以把它拆成:确定数据来源、筛选原始记录、进行分组、计算聚合结果、筛选分组、排序、限制输出数量。实际数据库内部如何优化和执行,还会受到索引、统计信息和执行计划等因素影响,因此不能简单把这套理解等同于数据库内部的物理执行过程。
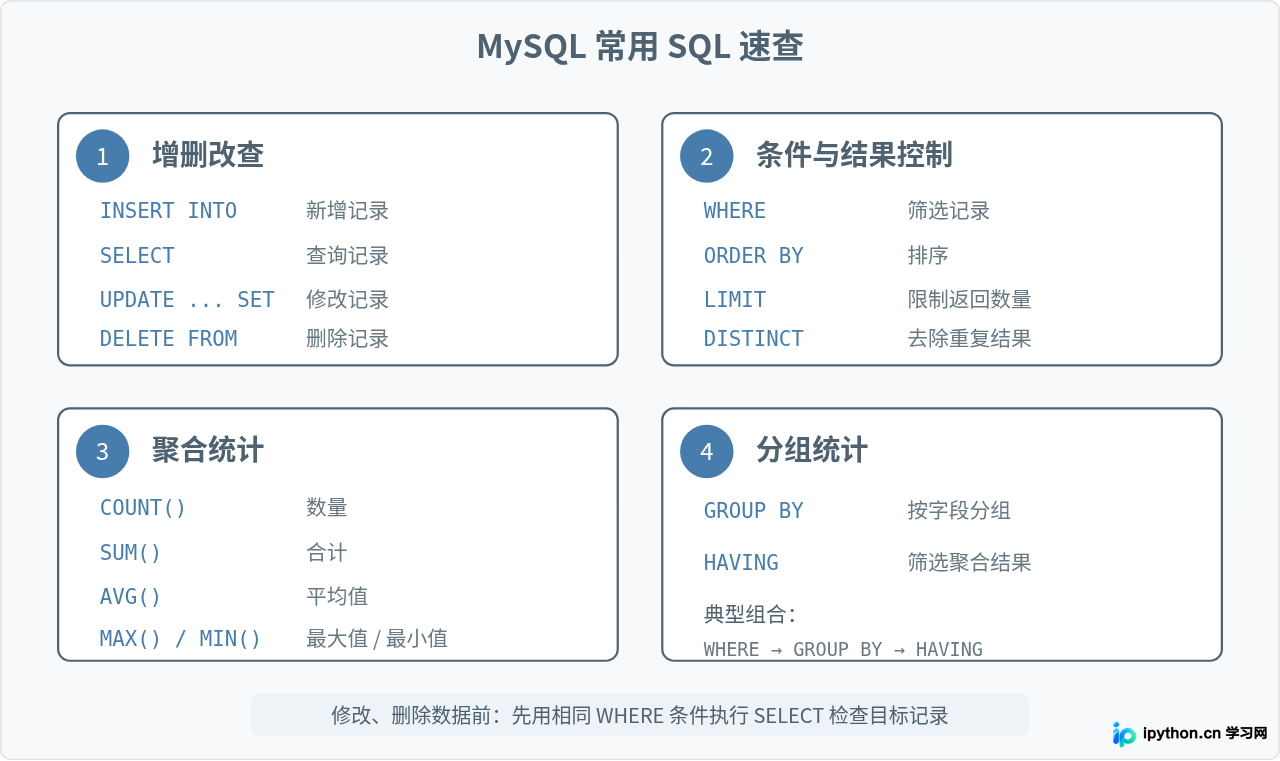
常用SQL语句速查表
| 需求 | 常用写法 |
|---|---|
| 新增数据 | INSERT INTO 表名 (字段) VALUES (值) |
| 查询数据 | SELECT 字段 FROM 表名 |
| 条件查询 | SELECT ... FROM ... WHERE 条件 |
| 修改数据 | UPDATE 表名 SET 字段=值 WHERE 条件 |
| 删除数据 | DELETE FROM 表名 WHERE 条件 |
| 升序排序 | ORDER BY 字段 ASC |
| 降序排序 | ORDER BY 字段 DESC |
| 限制数量 | LIMIT 数量 |
| 去重 | SELECT DISTINCT 字段 FROM 表名 |
| 统计数量 | COUNT(*) |
| 计算总和 | SUM(字段) |
| 计算平均值 | AVG(字段) |
| 最大值 | MAX(字段) |
| 最小值 | MIN(字段) |
| 分组统计 | GROUP BY 字段 |
| 筛选分组结果 | HAVING 聚合条件 |
几个容易写错的地方
UPDATE和DELETE忘记WHERE
这是基础SQL中风险最高的一类错误。没有WHERE时,UPDATE可能影响整张表,DELETE可能删除全部记录。因此执行前不要只检查SQL语法,还要确认筛选条件。
把NULL写成“= NULL”
判断NULL应使用:
WHERE some_field IS NULL

WHERE some_field IS NOT NULL
不要把它当成普通字符串或普通数值进行等号比较。
把WHERE和HAVING混为一谈
可以简单记成:WHERE主要过滤原始记录,HAVING主要过滤GROUP BY产生的分组统计结果。例如:
SELECT category, COUNT(*) AS product_count
FROM products
WHERE status = 1
GROUP BY category
HAVING COUNT(*) >= 2;
这里 status = 1 针对单条商品记录,而 COUNT(*) >= 2 针对每个分类统计后的结果。
业务代码直接拼接用户输入
本文中的SQL主要用于说明语法。如果在PHP、Java、Python等程序中接收用户输入,不应简单地把用户输入直接拼接进SQL字符串。实际业务代码应使用对应数据库驱动提供的参数绑定、预处理语句等机制处理参数。
例如,用户搜索关键字本质上可能对应:
SELECT id, name
FROM products
WHERE name LIKE ?;
其中具体参数由程序通过数据库驱动绑定,而不是直接把未经处理的外部输入拼接到SQL正文。
如何把这些SQL真正记住
常用SQL没有必要一开始记住大量冷门语法。先围绕一张简单的数据表反复完成几个真实任务更有效:插入几条数据,用WHERE查出来,修改其中一条,删除测试记录,再分别计算数量、库存合计和平均价格。
掌握基础操作后,再练习把语句组合起来,例如:
SELECT
    category,
    COUNT(*) AS product_count,
    AVG(price) AS average_price,
    SUM(stock) AS total_stock
FROM products
WHERE status = 1
GROUP BY category
HAVING SUM(stock) > 20
ORDER BY product_count DESC
LIMIT 10;
这条查询已经把筛选、分组、COUNT、AVG、SUM、HAVING、排序和数量限制组合到一起。能够看懂并根据业务条件修改这样的SQL,说明基础的增删改查和聚合查询已经形成了比较完整的理解。
日常使用时,可以把核心关系记成一句话:INSERT负责写入,SELECT负责读取,UPDATE负责修改,DELETE负责删除;WHERE确定目标记录,GROUP BY负责分组,聚合函数负责计算,HAVING筛选聚合后的结果。遇到复杂查询,再按照这个关系逐段拆开,通常比死记整条SQL更容易定位问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









