

Python 使用 split 去除文件行号的方法

发布时间:2026-10-14| 2人浏览过
本文介绍如何使用 Python 去除文件每行的行号。核心思路是利用字符串的 split 方法,以指定分隔符(如点号)进行分割,并提取分割后的右侧元素。通过读取文件内容,逐行处理并存储到新列表中,最后写入新文件,从而完成行号删除操作。
1. 问题背景
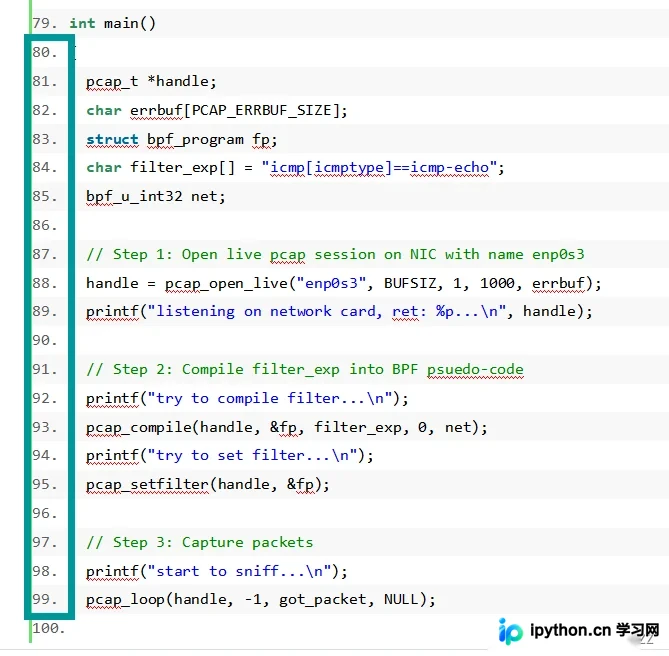
文件中的行号往往带来不便,这里尝试编写一个 Python 脚本来去除这些行号。
2. 解决思路
- 利用
def second_of_str函数对字符串进行分割,获取分隔符右侧的元素并返回一个列表。 - 定义
def move函数,传入源文件路径,读取文件的每一行,将处理后的结果存入新列表。具体操作是调用分割函数,将分割后的右侧部分加入新列表。 - 在主函数中调用上述处理函数,完成文件内容的转换。
3. 代码实现
def second_of_str(str,splitsymbol):
    s = str.split(splitsymbol,1)   # 分隔符右边的元素
    # if  len(s) == 1:
    #     return []
    return s[1]

def move(file_path, new_file_path):
    with open(file_path,encoding='utf-8') as f:
        content = f.read().splitlines()

    # for line in content:
    #     print(line)

    new_content = []
    for line in content:
        new_line = second_of_str(line,'.')
        # 去掉后的每行加入新列表
        new_content.append(new_line)

    for line in new_content:
        print(line)

    f1 = open(new_file_path,encoding='utf-8',mode = 'w')
    for line in new_content:
        f1.writelines(line)
        f1.writelines(["\n"])
    f1.close()
    return new_content

if __name__ == '__main__':
    f = move('1.txt','2.txt')
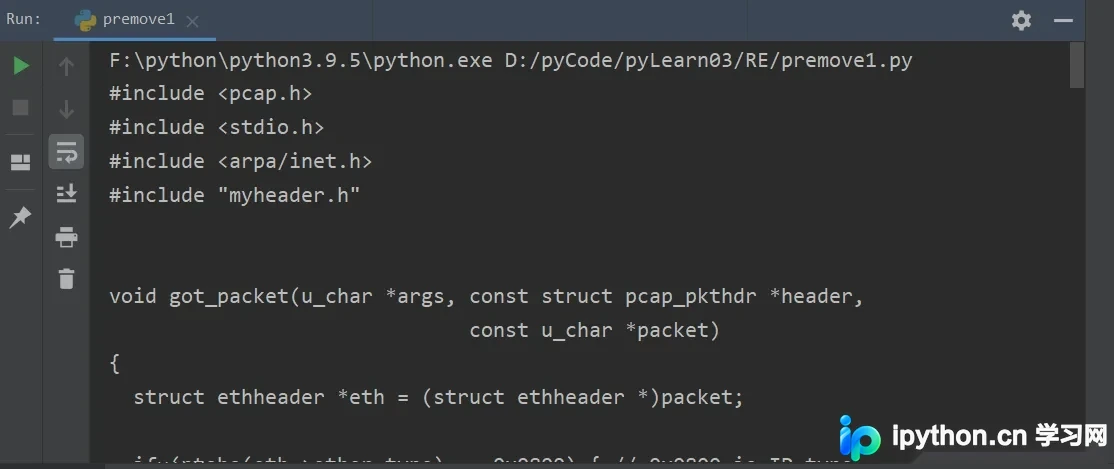
代码编写完成,效果如下。
至此,关于 Python 删除文件每一行行号的思路与实现介绍完毕。如需了解更多相关 Python 处理行号的内容,可搜索本站历史文章或继续浏览后续文章,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









