

MySQL与PostgreSQL的主要区别及选型建议

MySQL与PostgreSQL都是极其成熟的开源关系型数据库,但两者的设计哲学截然不同:MySQL追求易用性、执行速度和高并发Web事务,属于典型的“实用驱动型关系数据库”;PostgreSQL则严格遵循SQL标准、强调数据完整性与高级特性支持,是一个功能完备的“对象-关系型数据库”。选择哪一个,取决于业务对结构规范性、扩展需求以及复杂查询的侧重程度。
一、核心架构与系统特性的主要区别
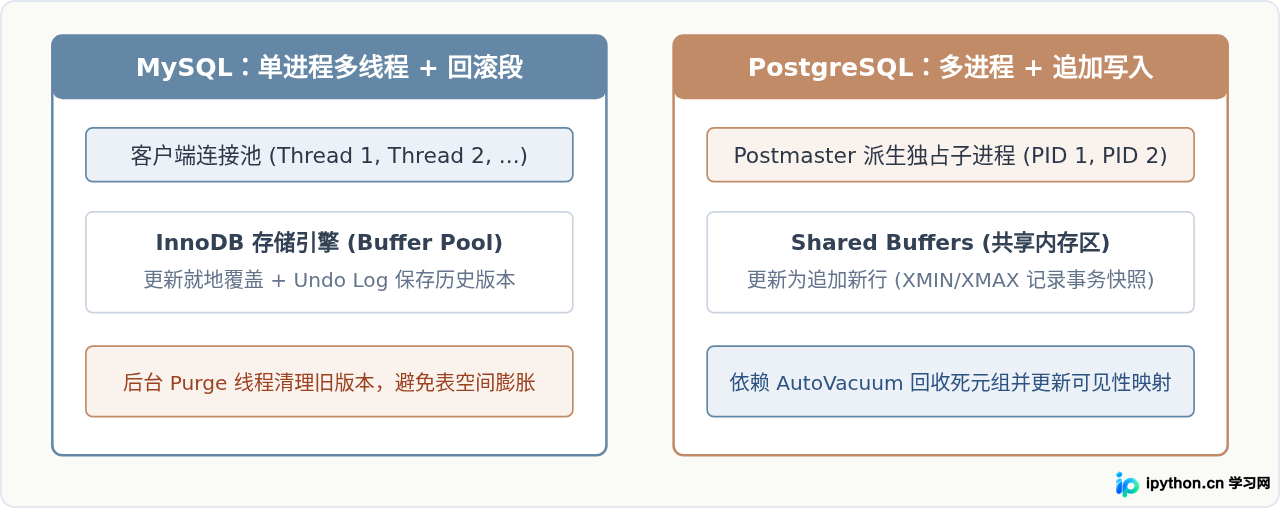
理解两者的区别,首先需要厘清其底层并发模型与存储引擎架构。设计起点上的差异,直接决定了它们在资源开销、扩展方式与事务实现上的不同表现。
| 对比维度 | MySQL (默认 InnoDB) | PostgreSQL |
|---|---|---|
| 进程/线程模型 | 单进程多线程模型,连接建立与内存切换较轻量 | 多进程模型,每个客户端连接对应一个独立后台进程 |
| 存储引擎支持 | 可插拔引擎架构(InnoDB、MyISAM、Memory等) | 单一内置引擎,所有特性围绕核心存储深度优化 |
| 数据模型分类 | 标准关系型数据库 (RDBMS) | 对象-关系型数据库 (ORDBMS),支持表继承与自定义类型 |
| MVCC 实现机制 | 基于 Undo Log 回滚段记录历史版本,通过 Purge 线程清理 | 通过写追加(Append-only)原地保存多版本,依赖 VACUUM 清理 |
| SQL 标准兼容度 | 中等,存在较多非标准方言与宽松检查机制 | 极高,极其严格地实现 ANSI SQL 标准 |
在并发处理上,MySQL的每条新建连接仅生成一个工作线程,内存占用相对平缓;而PostgreSQL采用多进程架构,每个连接都是一个完整的系统级进程。因此,PostgreSQL在高并发短连接场景下,强烈建议部署 PgBouncer 等连接池中间件进行连接复用,避免频繁 `fork` 进程带来的内存和CPU争抢。
二、关键功能与技术细节差异
1. 数据类型与 JSON 处理能力
虽然两者都支持 JSON 数据存储,但底层机制存在根本差异:
- MySQL: 提供
JSON类型,在内部以二进制格式存储以优化访问速度。支持虚拟生成列(Generated Columns)并在此列上建立 B-Tree 索引,语法上通过->与->>抽取字段。 - PostgreSQL: 提供
json(纯文本存储)和jsonb(分解二进制存储)。jsonb支持完整的 GIN 索引(广义倒排索引),能够直接对整个 JSON 对象的任意键值对建立索引,实现毫秒级的包含操作查询(@>)。
-- PostgreSQL 对 JSONB 字段直接创建 GIN 倒排索引
CREATE INDEX idx_user_meta ON users USING gin (metadata);

-- 检索包含指定键值对的记录(能完全命中 GIN 索引)
SELECT * FROM users WHERE metadata @> '{"role": "admin", "active": true}';
此外,PostgreSQL 原生具备数组类型(INTEGER[]、TEXT[])、范围类型(INT4RANGE、DATERANGE)、网络地址类型(INET、CIDR)以及 UUID 类型,免去了应用层序列化和文本转换的额外负担。
2. 索引类型与复杂查询支持
MySQL的InnoDB引擎主要依赖 B+Tree 索引以及空间数据的 R-Tree 索引;全文检索(Full-Text Search)在分词、语法和多语言扩展上相对基础。
PostgreSQL拥有丰富的索引体系:
- B-Tree: 传统等值与范围查询。
- GIN (Generalized Inverted Index): 适用于数组、JSONB 全文搜索的倒排索引。
- GiST / SP-GiST: 适用于地理几何信息(如结合 PostGIS 扩展)、多维数据及不规则拓扑查询。
- BRIN (Block Range Index): 块范围索引,用于按时序追加的大数据量日志表,索引体积通常不到 B-Tree 的 1%,极其节省磁盘空间。
- 部分索引(Partial Index): 允许只为满足特定条件的子集建立索引,例如仅为
WHERE status = 'unprocessed'创建索引,降低维护开销。
三、具体业务场景下的选型对比
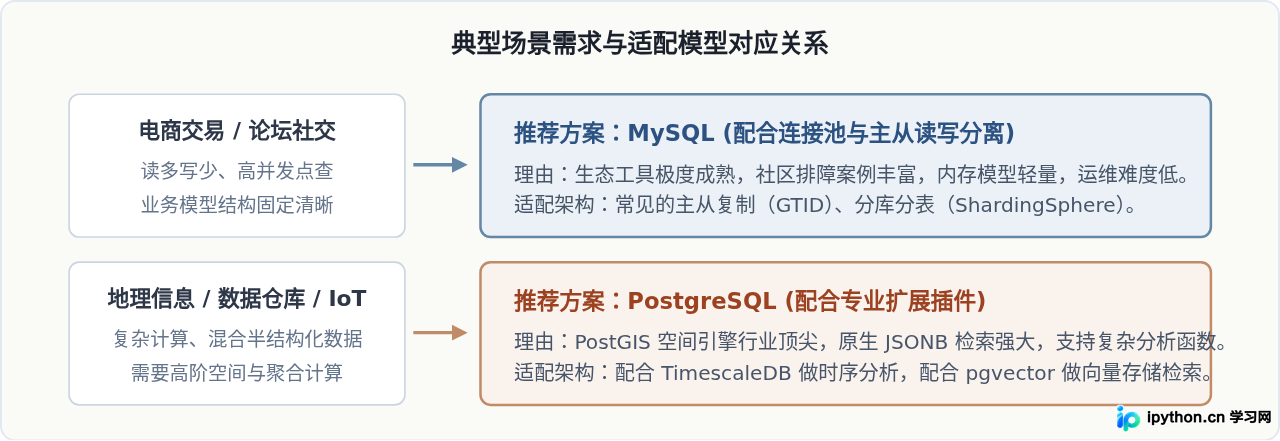
选型不应脱离具体的工程限制和团队技术栈。我们通过具体的典型业务场景来拆解决策过程。
四、选型判断操作指南:四步评估法
新系统立项时,不需要陷入技术优劣的空泛争论,建议按照以下具体步骤逐步排查业务指标:
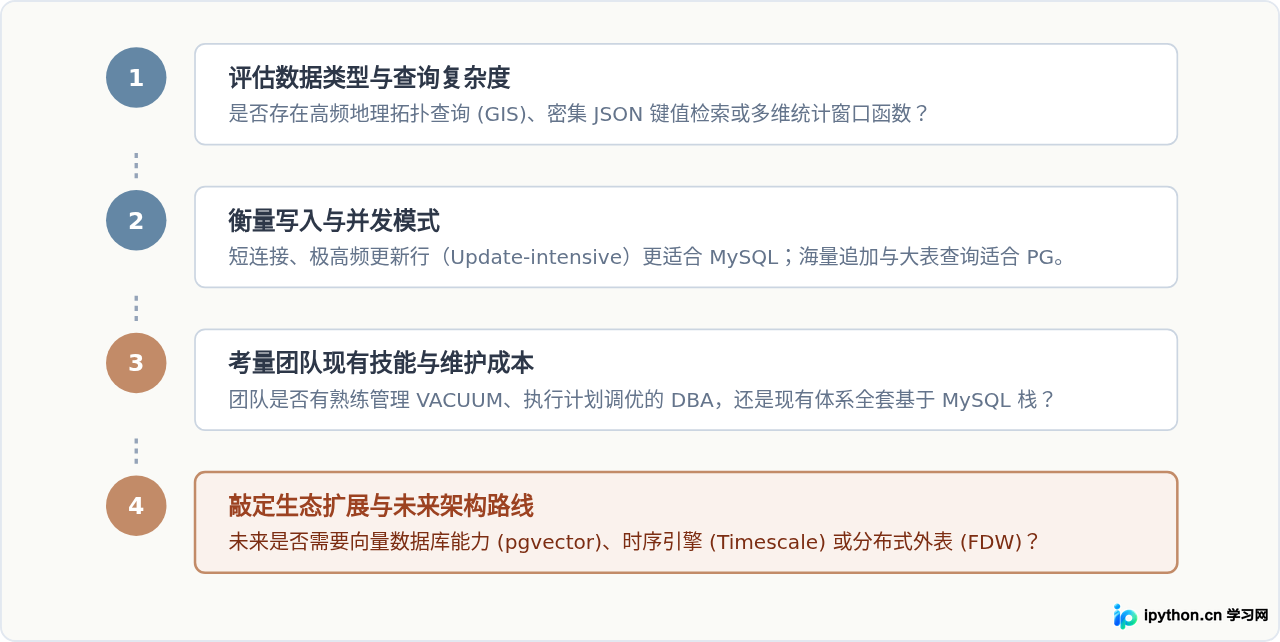
- 第一步:检查数据类型与结构。 业务如果只是普通订单、用户表、文章这类规则二维表,两者完全胜任;如果系统需要存储多维地理坐标、复杂半结构化配置(包含嵌套数组与对象检索)、IP段匹配,优先选 PostgreSQL。
- 第二步:核对并发连接与更新特性。 如果应用架构存在短连接多、并发事务小、对单个特定行的 UPDATE 频率极其剧烈(例如秒杀库存、计数器刷新),MySQL 的 Undo Log 机制比 PostgreSQL 的追加重写(Write Append)能避免大量空间膨胀。如果业务以复杂分析、报表聚合、批处理写入为主,PostgreSQL 的多核并行查询执行器能带来倍数级的性能优势。
-
第三步:评估运维技术栈与排障风险。 MySQL 在国内各类监控体系(Prometheus、Percona Toolkit)、主从切换(MHA、Orchestrator)、数据恢复工具与公有云托管方案上储备深厚。如果团队缺乏专业的 PostgreSQL 运维经验,上线初期很容易在
autovacuum_vacuum_scale_factor、shared_buffers和work_mem的参数调优上踩坑。 -
第四步:考虑扩展插件与多模需求。 近年来 AI 应用爆发,PostgreSQL 通过安装
pgvector插件,可以直接在已有业务库内同时提供文本、结构化数据与大模型嵌入向量的联合查询,省去额外搭建专用向量数据库(如 Milvus、Chroma)的运维开销。类似的外挂能力还包括时序扩展 TimescaleDB 与外部数据包装器 Foreign Data Wrappers (FDW)。
五、总结:核心选型结论
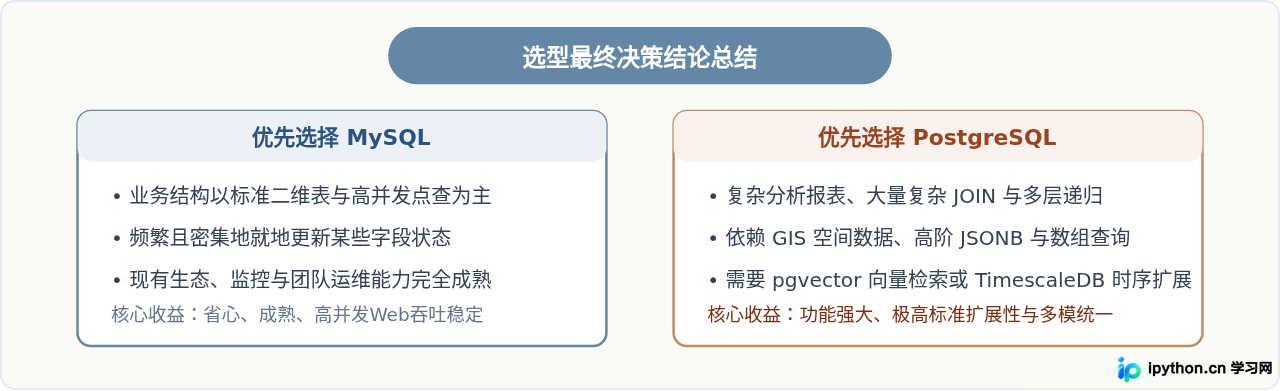
归纳而言,技术选型不是寻找“最强大的数据库”,而是寻找“最契合业务负载与团队现状的数据库”。
- 果断选择 MySQL 的场景: 标准互联网 Web 应用、电商与支付交易核心、SaaS 系统;团队技术栈全面依托主流开源运维工具链,或者业务属于轻量读写为主、注重开箱即用与快速迭代的项目。
- 果断选择 PostgreSQL 的场景: GIS/空间地理信息系统、混合有大量非结构化 JSON 的数据分析系统、包含复杂统计窗口与递归查询的 ERP/财务系统;需要向量检索(AI 应用)、时序数据扩展或追求严格 SQL 标准兼容的新型企业级项目。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









